Глава Cerebras призвал сместить разговор об ИИ от апокалипсиса к практике
С@ask_vcавтор про «startups»
1 нед
Cerebras Systems анонсировала CS-4 — стоечную ИИ-систему, в основе которой три процессора WSE-3 Turboi (WSE-3T). Несмотря на название, это не новый чип: тот же кристалл WSE-3 двухлетней давности (5 нм TSMC, 4 трлн транзисторов, 900 тыс. ядер), но с частотой, поднятой с 1,4 до 2,8 ГГц, что удвоило пропускную способность памяти и производительность в FLOP/s.
Главная новизна — не кремний, а «коробка» вокруг него: CS-4 стала первой настоящей rack-scale системой Cerebras (предыдущий «CS-3 Rack» был просто двумя независимыми CS-3 в одной стойке без объединения вычислений). Новая платформа Nexusi рассчитана на несколько будущих поколений чипов, включая CS-5 и CS-6, и должна снизить стоимость эксплуатации ИИ-дата-центров, где электричество становится главным ограничением масштабирования.
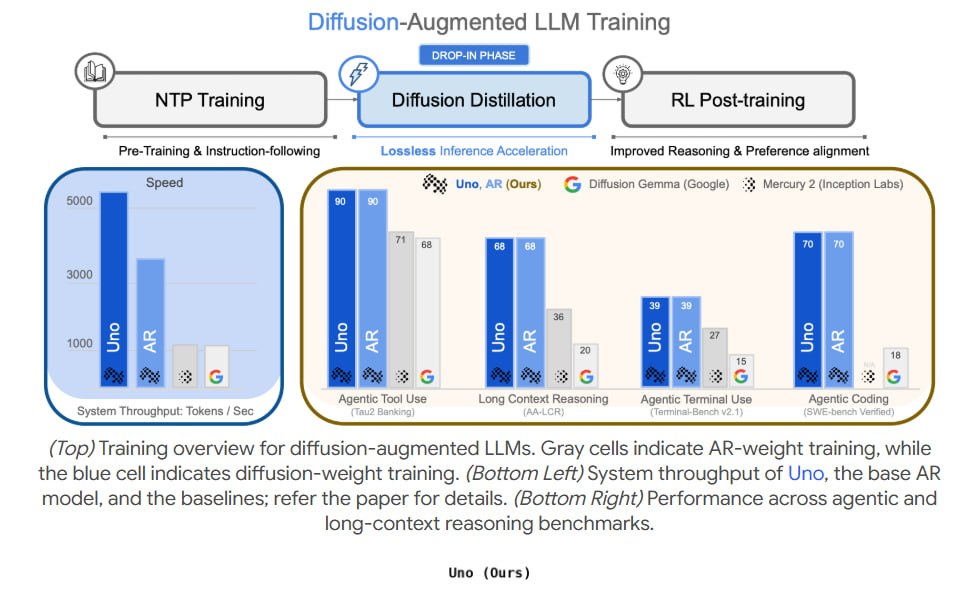
OpenAI открыла превью-доступ к режиму Ultrafast для флагманской модели GPT-5.6 Sol: за счёт аппаратного ускорения на чипах Cerebrasi модель генерирует до 750 токенов в секунду — примерно в 14 раз быстрее обычного API. Сама модель не стала «умнее», меняется только скорость выдачи, но для длинных ответов и агентных задач это критично.
Пока режим доступен лишь ограниченному числу клиентов API в режиме превью, цена и сроки массового запуска не раскрыты — OpenAI обещает расширять доступ по мере наращивания вычислительных мощностей.
Автор канала @llm_under_hood (по совету @AigizK) протестировал модель Gemma 4 31B, запущенную на специализированных чипах Cerebrasi, на агентском бенчмарке под бизнес-задачи. С выключенным reasoning (он тормозит и спотыкается о structured outputs) модель сдвинула фронтир скорости бенчмарка и оказалась совсем рядом с GPT-5.4 mini по качеству и цене — при этом её, в отличие от закрытой GPT-5.4 mini, можно скачать и запускать локально.
Через два дня выяснилось, что эффект не ограничивается одной моделью: запуск gpt-oss-120B на том же железе Cerebras во всех трёх режимах reasoning (high, medium, low) тоже выводит её на speed frontier, а medium-режим дополнительно попадает на cost-фронтир по эффективности. Вывод автора — дело не столько в конкретной модели, сколько в самом железе Cerebras, которое команды уже используют для near-realtime AI-решений.
ВыводCerebras выпускает wafer-scale engines — чипы, которые примерно в 50 раз крупнее самых больших GPU, что делает железо дорогим и специализированным, но позволяет запускать небольшие модели на очень высоких скоростях
Это всё на сейчас.