Random Attention: новый подход к сжатию KV-кэша
К@quant_prune_distillAI-инженер
1 месИсследователи из Salesforce Research предложили метод случайного прунинга KV-кэша, который не уступает сложным эвристикам и ускоряет инференс LLM.
Этот метод позволяет ускорить работу нейросетей с длинными текстами без потери качества.
- Снижает требования к оперативной памяти при обработке длинных контекстов.
- Ускоряет генерацию ответов за счет упрощения алгоритма работы с кэшем.
- Показывает, что простые методы могут быть эффективнее сложных эвристик в задачах оптимизации LLM.
Random Attention: Rethinking KV Cache Eviction for Efficient Reasoning
📄 Статья
С увеличением характерной длины контекстов в LLM все острее стал вставать вопрос о сжатии KV-кэша. Длинный KV-кэш занимает много места в памяти, а еще и замедляет инференс.
Исследователи за последние несколько лет придумали много эвристик по прунингу / слиянию токенов разной степени безумия — одна якобы лучше другой.
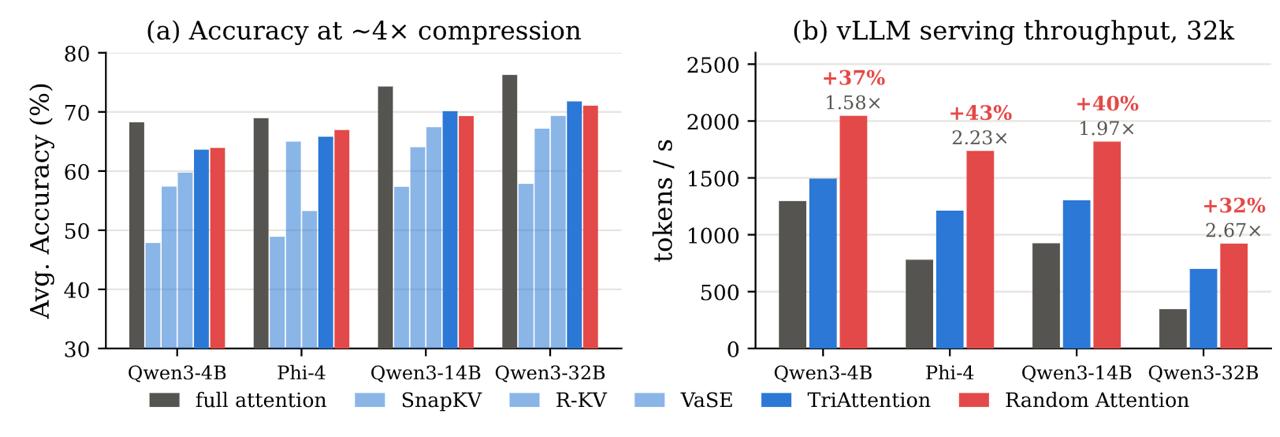
А тут вот ребята из Salesforce Research заметили, что рандомный прунинг работает, вообще говоря, не хуже всех этих хитроумных идей, а кроме того, предлагает более быстрый инференс ввиду отсутствия необходимости оценивать важность токенов.
Кратко (AI)
Исследователи из Salesforce Research представили метод Random Attention для управления KV-кэшем в больших языковых моделях. Авторы утверждают, что случайное удаление токенов работает не хуже сложных алгоритмов прунинга, при этом значительно ускоряя процесс инференса за счет отсутствия вычислений важности токенов.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖