ИИ

Алёна Феногенова представила 5 новых линеек бенчмарков для русскоязычных языковых моделей

На конференции AI RnD Day Алёна Феногенова представила пять новых линеек тестов для оценки современных LLM на русском языке. Главный тезис: один общий балл в метрике плохо описывает модель для реального применения — качество зависит от связки «модель × обвязка × промпт × окружение», поэтому нужны раздельные замеры разных навыков.

Пять линеек охватывают разные аспекты: LIBRAi — работа с длинным контекстом, MERAi Reason — математические рассуждения, MERA Text 2.0 — языковые, культурные и прикладные навыки, RUMBA — память между сессиями, harness-bench-fasti — работа в агентной обвязке (выбор инструмента vs успешное выполнение действия в среде).

ВыводLIBRA Mini: из 18 задач полной LIBRA выбрано 6 сложных, диапазон контекста от 4K до 512K токенов, запуск через lm-evaluation-harness; задачи требуют связывать факты из разных частей текста, отвечать по нескольким статьям Wikipedia, определять человека по теме диалога, считать уникальные абзацы среди повторов

62,2 → 39,8 → 12,6падение балла Qwen3-30B-A3B на LIBRA (4K/64K/128K токенов)
8700запросов в MERA Text 2.0
в 4,3 разасокращение объёма MERA Text 2.0

Полный разбор →

Nvidia обсуждает страхование кредитов под залог чипов

v@vcnewsмедиа / агрегатор
1 мес
Nvidia обсуждает со страховыми компаниями возможность покрытия рисков по кредитам под залог чипов, узнало FT. Если занимавшая деньги компания обанкротится, а заложенные чипы Nvidia не удастся перепродать по цене, достаточной для погашения долга, страховая компания возьмёт на себя часть убытков vc.ru/ai/3165419
Nvidia обсуждает страхование кредитов под залог чипов

Калькулятор с интегрированным ИИ для списывания

М@olya_tashitмедиа / агрегатор
1 мес
Калькулятор, в который какой-то паренек вкрячил ИИ. Удобно проносить на экзамен. Мдааа... Дети с этими нейронками совсем одичают. В наше время приходилось заводить хотя бы одного друга - чтоб он диктовал правильные ответы в наушник. 😐

Обновления экосистемы YuE2: техрепорт, VAE и новые инструменты

Н@GreenNeuralRobotsAI-инженер
1 мес

Российские разработчики выпустили WebPageBench — бенчмарк для проверки веб-агентов на русскоязычных сценариях

Команда, работавшая над проектом год, представила WebPageBenchi — локальную тестовую среду для оценки ИИ-агентов, выполняющих повседневные задачи на сайтах (покупки, бронирование билетов и отелей, заказ справок) на русском языке. Ключевая идея: вместо реальных сайтов, где интерфейсы меняются, антибот блокирует прогоны, а заказы с оплатой становятся настоящими, используются шесть мок-версий популярных сервисов, где каждое действие агента фиксируется в лог и проверяется автоматически, а не со слов самого агента.

Бенчмарк важен, потому что впервые показывает объективный разрыв между тем, что агенты сообщают о своей работе, и тем, что они реально сделали — а разрыв оказался значительным.

152всего задач в бенчмарке
24связок «модель + обвязка» на лидерборде
41 пунктразрыв между заявленным и реальным успехом

Полный разбор →

Paperclip — opensource-оркестратор, превращающий ИИ-агентов в виртуальную компанию

Появился инструмент Paperclipi — оркестратор, который объединяет Claude Code, Codex, Cursor, OpenClawi и другие ИИ-агенты в полноценную виртуальную команду с должностями, иерархией и бюджетами. Пользователь назначает агентам роли (CEO, CTO, CMO, дизайнер, разработчик, маркетолог), ставит задачи и цели, а дальше агенты сами координируют работу через систему тикетов, похожую на Jira или Gitlab.

Проект бесплатный, с открытым исходным кодом и разворачивается локально; репозиторий уже набрал почти 100 тыс. звёзд на GitHub. Систему уже используют на практике — и первые пользователи столкнулись с тем, что поддержание такой виртуальной оргструктуры сжигает большие объёмы токенов, что заставляет искать способы оптимизации расходов.

~100 тыс.звёзд репозитория Paperclip на GitHub
10 разлимит запусков задачи в сутки до автопаузы

Полный разбор →

Курс Stanford CS329A по Retrieval-Augmented Language Modeling

L@lovedeathtransformersAI-инженер
1 мес
https://cs329a.stanford.edu/ Huh? Курс стенфорда по RSI. Тут есть проблема что RSI прекрасен как концепция, но ужасен когда ты его делаешь иии он почти не работает на текущем поколении моделей. Но сами статьи клёвые, точно стоит почитать.

Scumble: бесплатный редактор с открытым кодом для инпейнтинга

Н@GreenNeuralRobotsAI-инженер
1 мес

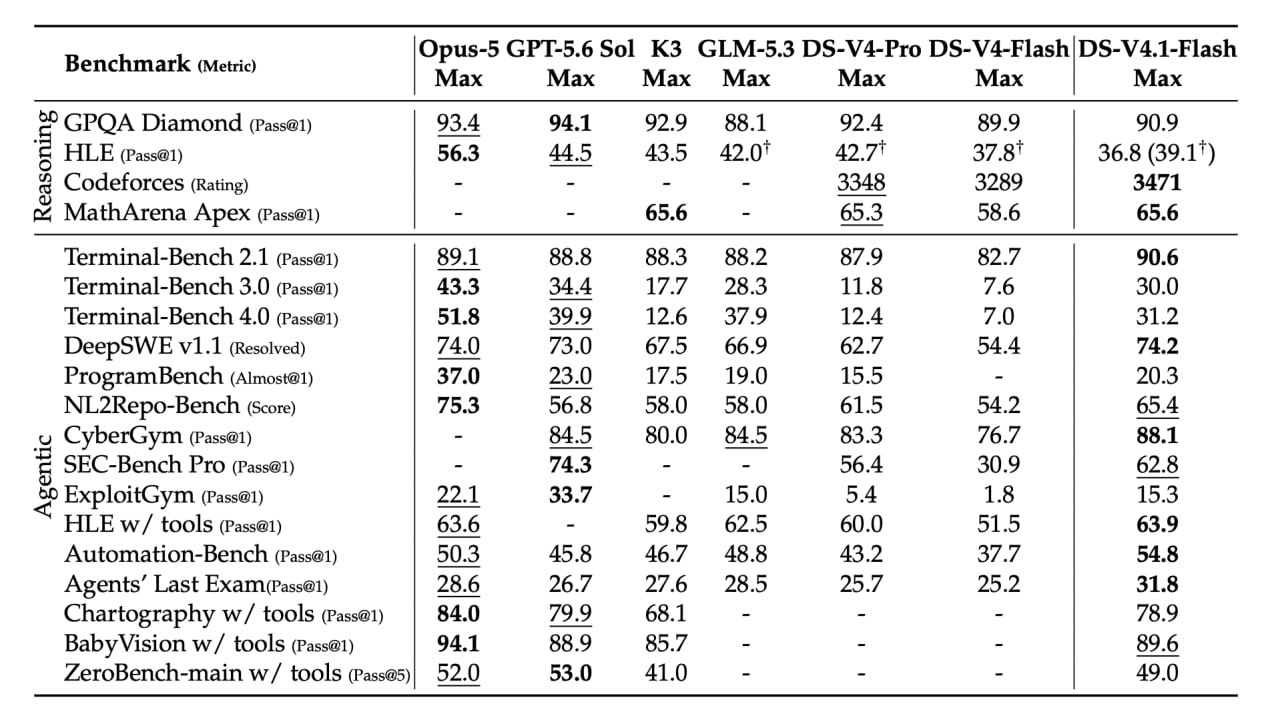
Технический разбор архитектуры DeepSeek-V4.1-Flash

Д@stuffyNLPAI-инженер
1 мес
Технический разбор архитектуры DeepSeek-V4.1-Flash

Гибридные ML-пайплайны в Yandex Cloud

1 мес
Гибридные ML-пайплайны в Yandex Cloud

ИИ-стартап Clay привлек $115 млн при оценке $7,1 млрд

Р@rusvenавтор про «startups»
1 мес

UniPhysGen: модель для автоматического добавления физических свойств 3D-мешам

Н@GreenNeuralRobotsAI-инженер
1 мес
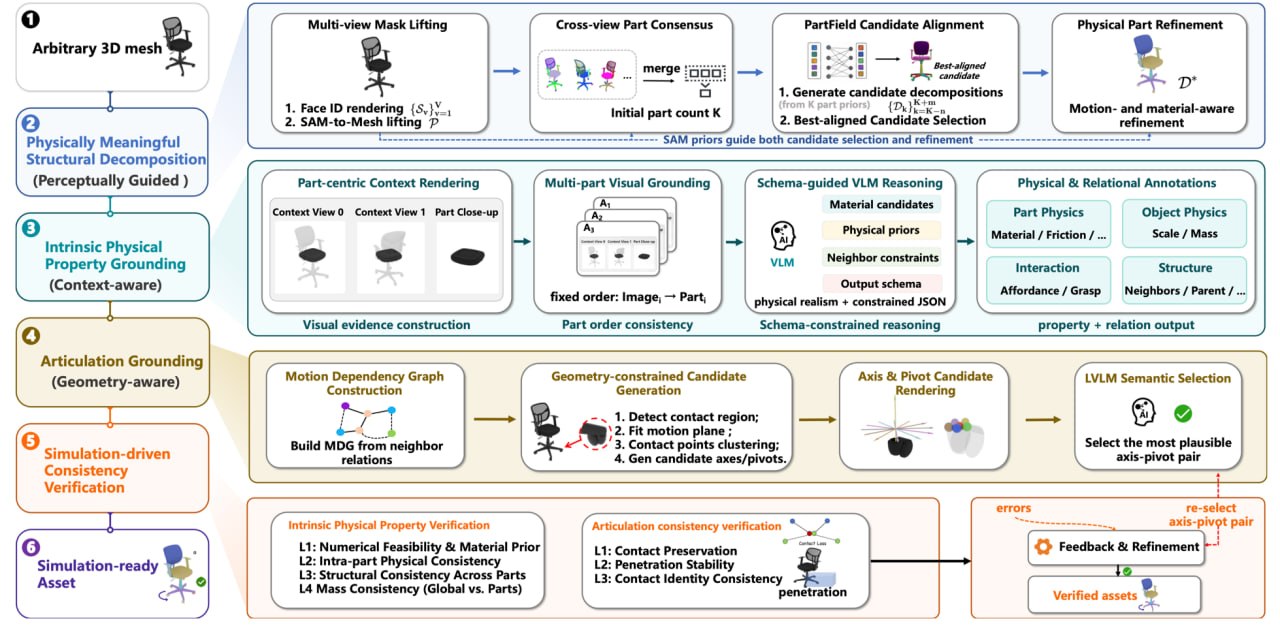
UniPhysGen Модель добавляет физические свойства 3D-мешам для симуляции. Берет сегментированный объект и выдает массу, трение, сочленения и масштаб Что умеет • Предсказывает материал и плотность каждой части • Определяет кинематику и структуру сочленений • Генерирует объектный масштаб и массу • Совместно рассуждает о физике и артикуляции • Нужны сегментированные меши на входе • Полный пайплайн UniPhys Pipeline для сырых мешей • Симуль-верифицированные ассеты на выходе github.com/breezexian/uniphysgen huggingface.co/breezexian/UniPhysGen #simulation #3d MAX
UniPhysGen: модель для автоматического добавления физических свойств 3D-мешам

Разработка ИИ-агента для автоматизации закупки рекламы в Telegram

Л@baldfrombrowserмедиа / агрегатор
1 мес
Разработка ИИ-агента для автоматизации закупки рекламы в Telegram

Новый оператор для MLP-слоев трансформеров: Change the Product, Keep the Parameters

С@oulenspiegel_channelAI-инженер
1 мес

Критика инвестиций в метавселенную и прогнозов McKinsey

М@cgeventAI-инженер
1 мес

Anthropic добавил в Claude Code скиллы build-eval и hillclimb для автоматической оптимизации продуктов

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 1 мес назад

Anthropic выпустил для Claude API/Claude Code два новых скилла — build-eval и hillclimbi, которые превращают создание приложений и бизнес-процессов в автоматическую оптимизацию по метрикам, а не в написание кода вручную. Достаточно задать цель (например, «100% клиентов, готовых оплатить, доходят до конца процесса»), и Claude сам анализирует логи, тикеты поддержки и трейсы, генерирует гипотезы, вносит изменения и проверяет, улучшилась ли метрика — по одному изменению за раунд.

Подход не убирает человека из процесса, а меняет его роль: вместо придумывания и реализации гипотез владелец продукта теперь формулирует чёткие, не поддающиеся подмене метрики успеха. По мнению одного из авторов, это необходимое условие для «software factories», самоуправляемых продуктов и AI-native организаций.

34%снижение стоимости вызова после кэша
2.6 разарост скорости при low thinking effort
$17стоимость полного теста на 616 кейсах

Полный разбор →

Ещё ↓