gpuСбросить фильтр ×

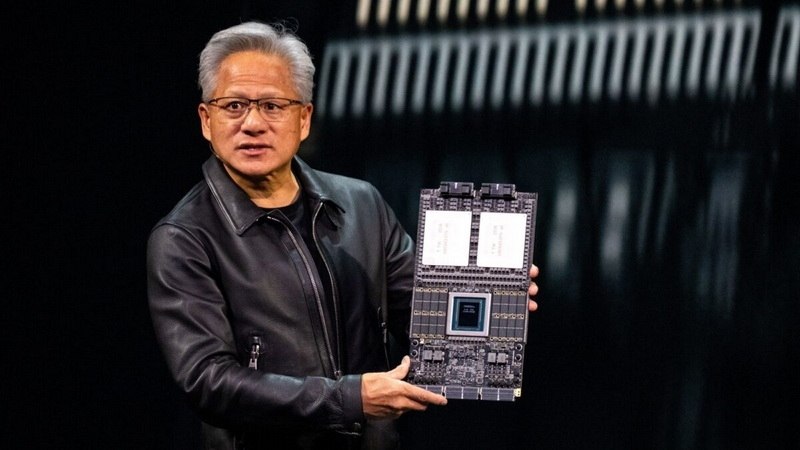
Nvidia снизила характеристики платформы Vera Rubin

3@ru3dnewsмедиа / агрегатор
7 ч
Nvidia не смогла выпустить Vera Rubin, которые обещала: память HBM4 замедлилась, а местами даже ужалась Nvidia урезала заявленные характеристики ИИ-платформы Vera Rubin: скорость HBM4 и NVLink 6 снизилась. В системе NVL72 пропускная способность памяти на GPU упала с 22 до 19,2 Тбайт/с, а NVLink — с 3,6 до 3 Тбайт/с. Для HGX Rubin NVL8 уменьшили и объём памяти — с 2,3 до 2 Тбайт, а производительность в некоторых режимах обучения — до 130–270 Пфлопс. При этом в разных документах Nvidia всё ещё встречаются старые цифры, а спрос на Rubin, судя по всему, остаётся высоким. #verarubin #nvidia 📎Подробнее 🔖 3DNews в TG | MAX | VK
Nvidia снизила характеристики платформы Vera Rubin

Участники Orbit Wars рассказали о масштабе вычислений и инженерных решениях

D@datastorieslanguagesAI-инженер
9 ч

Анлокер gpu-unlock ускоряет матричные вычисления на видеокартах NVIDIA

Открытый проект gpu-unlock снимает программное ограничение скорости матричных вычислений на потребительских видеокартах NVIDIA, меняя низкоуровневые регистры до запуска драйвера. В тестах отдельных моделей RTX 30 прирост BF16i достигает примерно 80%, но эффект зависит от задачи: обработка промптов ускоряется, а генерация токенов может почти не измениться.

Основная версия работает под Linux и не требует перепрошивки BIOS; при этом пользователи сообщали о сбоях и необходимости откатывать изменения. Данные о поддерживаемых моделях расходятся: ранние сообщения указывают на GA102 и GA104, более поздние — также на RTX 20 и RTX 40.

87,5 → 157,4 TFLOPSBF16 на RTX 3090 Ti
14–36%ускорение префилла LLM
5 тысячзвёзд GitHub у проекта

Полный разбор →

MiniMax собрала каталог community-разработок для H3: ускорение, референсы и запуск на разном железе

MiniMax обновила каталог интеграций и моделей для MiniMax H3: в нём появились ускоренные варианты генерации, инструменты для работы с референсами, LoRAi и готовые ComfyUI-воркфлоу. Все перечисленные разработки созданы сообществом, а каталог ведёт сама MiniMax.

Практический эффект — H3 становится доступнее на менее мощном оборудовании и быстрее в отдельных сценариях: от работы с картинками, видео и аудио до обработки длинных клипов и замены персонажей или фона.

464 ГБполный набор весов
19,5 ГБpruned int8 для GPU 24 ГБ
27:50 → 12:55обработка клипа на 5070 Ti

Полный разбор →

NVIDIA открыла код платформы Run для распределения GPU

G@aiofthedayAI-инженер
2 дн
NVIDIA открыла код платформы, которая помогает GPU меньше простаивать Run распределяет видеокарты между командами и AI-задачами. Например, если одной команде не хватает мощности для обучения модели, а другая использует свои GPU лишь частично, Run позволяет задействовать свободные ресурсы по заданным правилам. Система работает поверх Kubernetes. Подходит для разработки, обучения и запуска моделей на своих серверах или в облаке. https://developer.nvidia.com/blog/nvidia-runai-is-now-open-source-as-part-of-nvidia-dsx-ai-factory-platform/

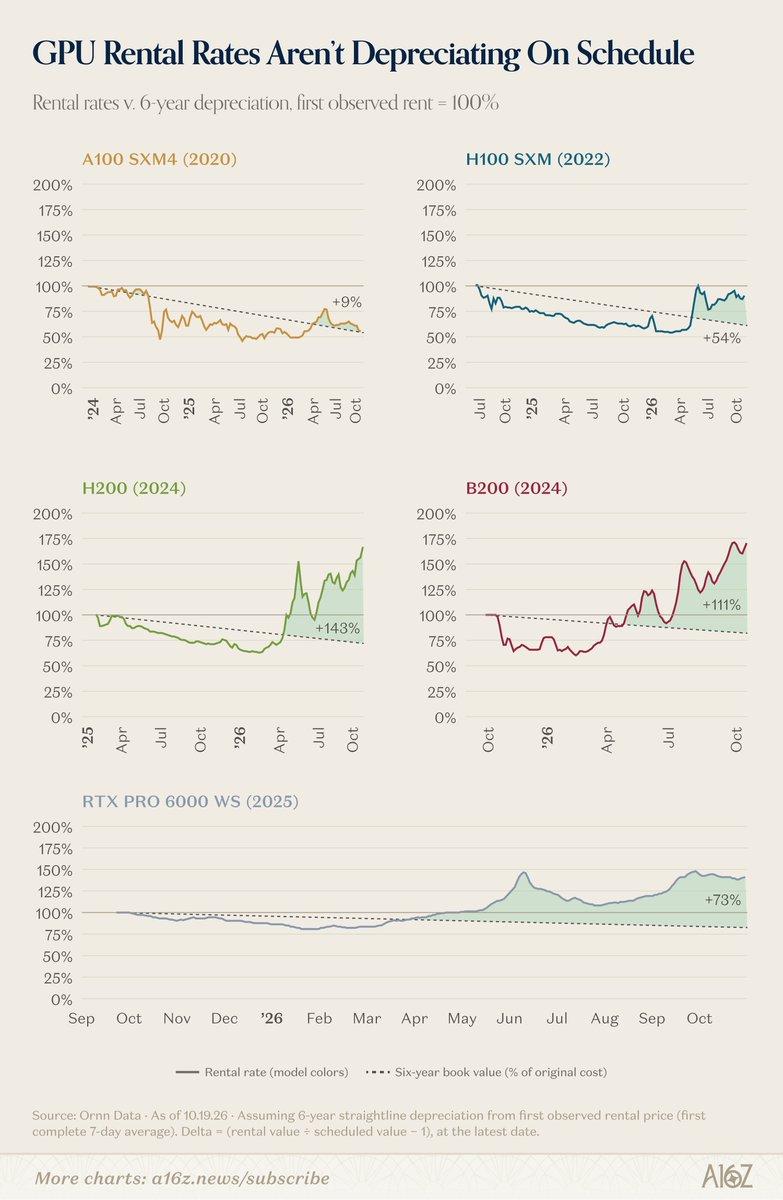
Аренда GPU дорожает, а спрос на токены OpenRouter вырос в 27 раз

С@seeallochnayaAI-инженер
2 дн
Аренда GPU дорожает, а спрос на токены OpenRouter вырос в 27 раз

Инференс на Blackwell приносит до $38 в час на GPU

С@seeallochnayaAI-инженер
2 дн

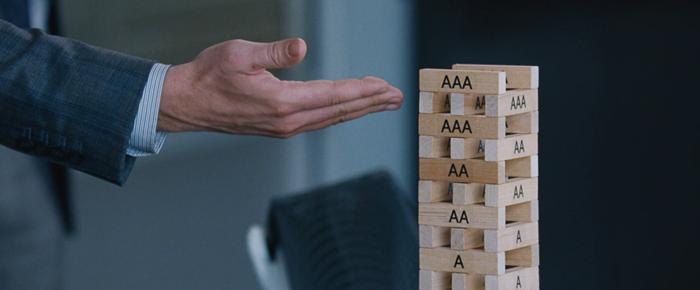
Форвардные контракты на GPU как обеспечение кредитов для ИИ

P@ruspmпродакт / фаундер
4 дн
Форвардные контракты на GPU как обеспечение кредитов для ИИ

Компании редко выводят ИИ-агентов в прод

️@neyroseti_drAI-инженер
6 дн
Компании редко выводят ИИ-агентов в прод

Альтман предложил три подхода к безопасности ИИ

3@ru3dnewsмедиа / агрегатор
1 нед
Альтман предложил три подхода к безопасности ИИ

Гайд по локальному запуску DeepSeek: от домашнего ПК до сервера с 8 GPU

1 нед
Гайд по локальному запуску DeepSeek: от домашнего ПК до сервера с 8 GPU

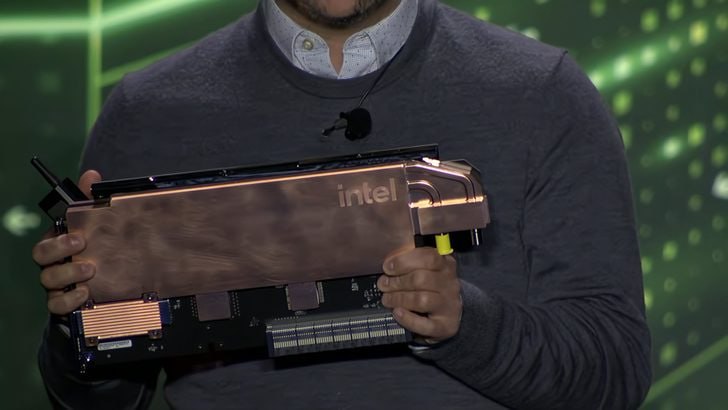
Intel показала двухчиповый ускоритель Crescent Island

P@prohitecавтор про «tech»
1 нед
Два GPU Crescent Island на одной плате Компания Intel продемонстрировала двухчиповую конфигурацию ускорителей серии Crescent Island на базе архитектуры Xe3P. Новое решение выполнено в серверном форм-факторе OAM (Open Accelerator Module) и объединяет два графических процессора на одной плате, причем каждый чип оснащен собственным массивом памяти LPDDR5X. Для связи между кристаллами на модуле задействован мост на базе PLX-контроллера, а за отвод тепла отвечает массивный медный водоблок с системой жидкостного охлаждения. Подобная компоновка позволяет плотнее упаковывать вычислительные узлы в серверных стойках.
Intel показала двухчиповый ускоритель Crescent Island

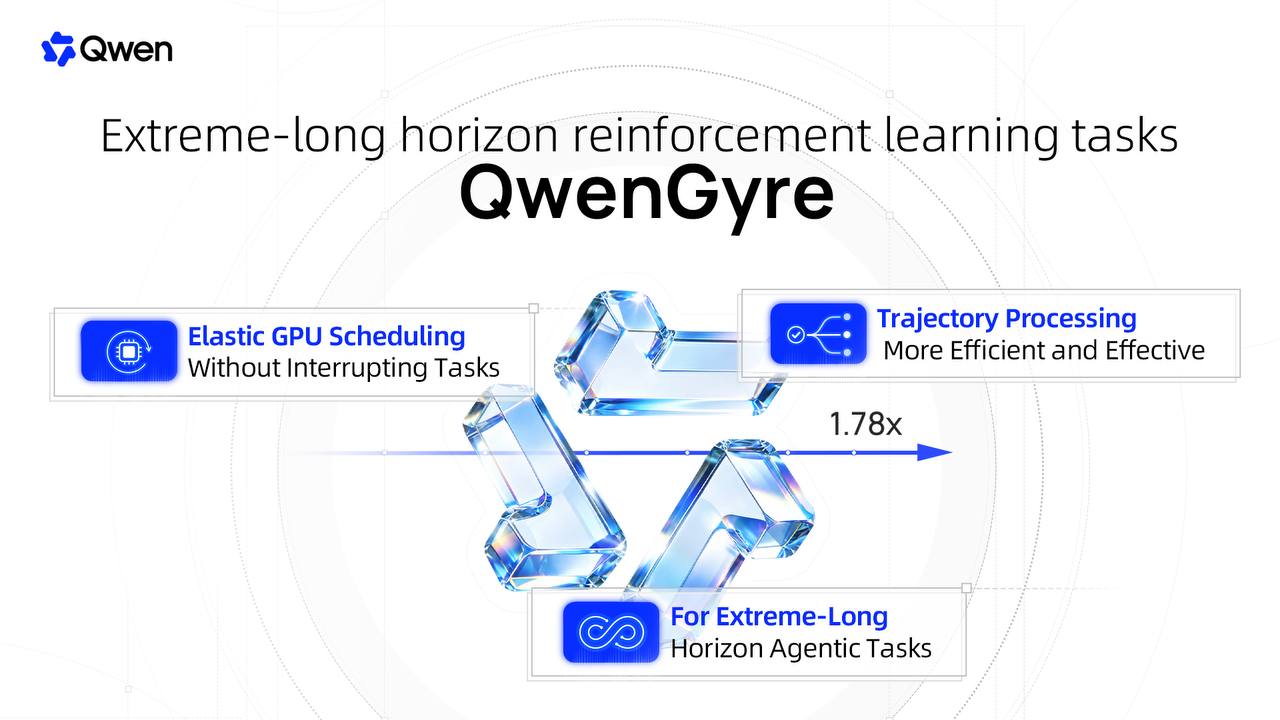
Qwen представила QwenGyre для ускорения обучения ИИ-агентов

2 нед
Qwen представила QwenGyre для ускорения обучения ИИ-агентов

Анонс архитектуры AMD RDNA 5 ожидается не ранее второй половины 2027 года

P@prohitecавтор про «tech»
2 нед
Анонс архитекутры AMD RDNA 5 может состояться не ранее второй половины 2027 года Следующее поколение графических процессоров AMD RDNA 5 представят не раньше Computex 2027, а наиболее вероятным сроком анонса называется вторая половина 2027 года. Об этом сообщил инсайдер Kepler_L2, исключив вероятность презентации новинок на CES или в первые месяцы 2027 года. По данным инсайдера, в 2027 году выйдет только один чип линейки — среднебюджетный AT2, тогда как остальные решения (флагманский AT0, а также AT3 и AT4) появятся только в 2028 году. В NVIDIA выходить из графика тоже не спешат: линейка GeForce RTX 60 выйдет не раньше 2028 года.
Анонс архитектуры AMD RDNA 5 ожидается не ранее второй половины 2027 года

Власти обсуждают разрешение зарубежных чипов и ИИ-решений на критической инфраструктуре

Правительственная рабочая группа предложила временно разрешить использование зарубежных чипов и ИИ-решений на критически важных объектах — таких как значимые объекты критической инфраструктуры. Сейчас там разрешено применять только оборудование из реестра отечественной радиоэлектроники, но российских аналогов нужной для ИИ производительности на рынке не хватает.

По данным Forbes, на которые ссылается vc.ru, «лазейка» должна действовать до тех пор, пока в России не появятся аналоги сопоставимой мощности. Таким образом власти пытаются снять дефицит высокопроизводительных ИИ-чипов, не отказываясь от курса на импортозамещение.

Полный разбор →

Разбор доклада «Financing the AI Buildout»: сколько выручки нужно ИИ-индустрии, чтобы окупить дата-центры

Автор канала «Сиолошная» вместе с Пашей из @RationalAnswer разобрал академическую статью «Financing the AI Buildout», подготовленную для BPEAi (журнал и конференция по макроэкономике). В статье оценивается, сколько денег США планируют вложить в строительство дата-центров под ИИ к 2032 году и какая выручка нужна отрасли, чтобы эти вложения окупились с учётом стоимости капитала.

Итоговые цифры огромны: по расчётам автора статьи, индустрии ИИ нужно будет зарабатывать около $3,73 трлн в год — это почти 9,2% ВВП США, то есть масштаб, сопоставимый со всей обрабатывающей промышленностью страны. Автор «Сиолошной» в отдельном уточняющем посте пересчитал модель отдельно для OpenAI и Anthropic и показал, что итоговая цифра сильно зависит от предполагаемой операционной маржи — и усомнился, что эти компании реально выйдут на операционные расходы в $855 млрд в год.

ВыводК 2032 году в США планируется ввести в эксплуатацию 183 ГВт дата-центров; 1 ГВт ДЦ стоит примерно $41 млрд, итоговые затраты с учётом инфляции — $8,5 трлн

$8.5Tпрогнозные затраты на ДЦ в США к 2032
$3.73Tтребуемая годовая выручка ИИ-индустрии
9.2%доля этой выручки от ВВП США

Полный разбор →

Создание анимации с нулевыми затратами на GPU

A@nn_for_scienceAI-инженер
2 нед

Оптимизация производительности GPU Apple Silicon через ограничение SIMD-групп

L@lovedeathtransformersAI-инженер
2 нед
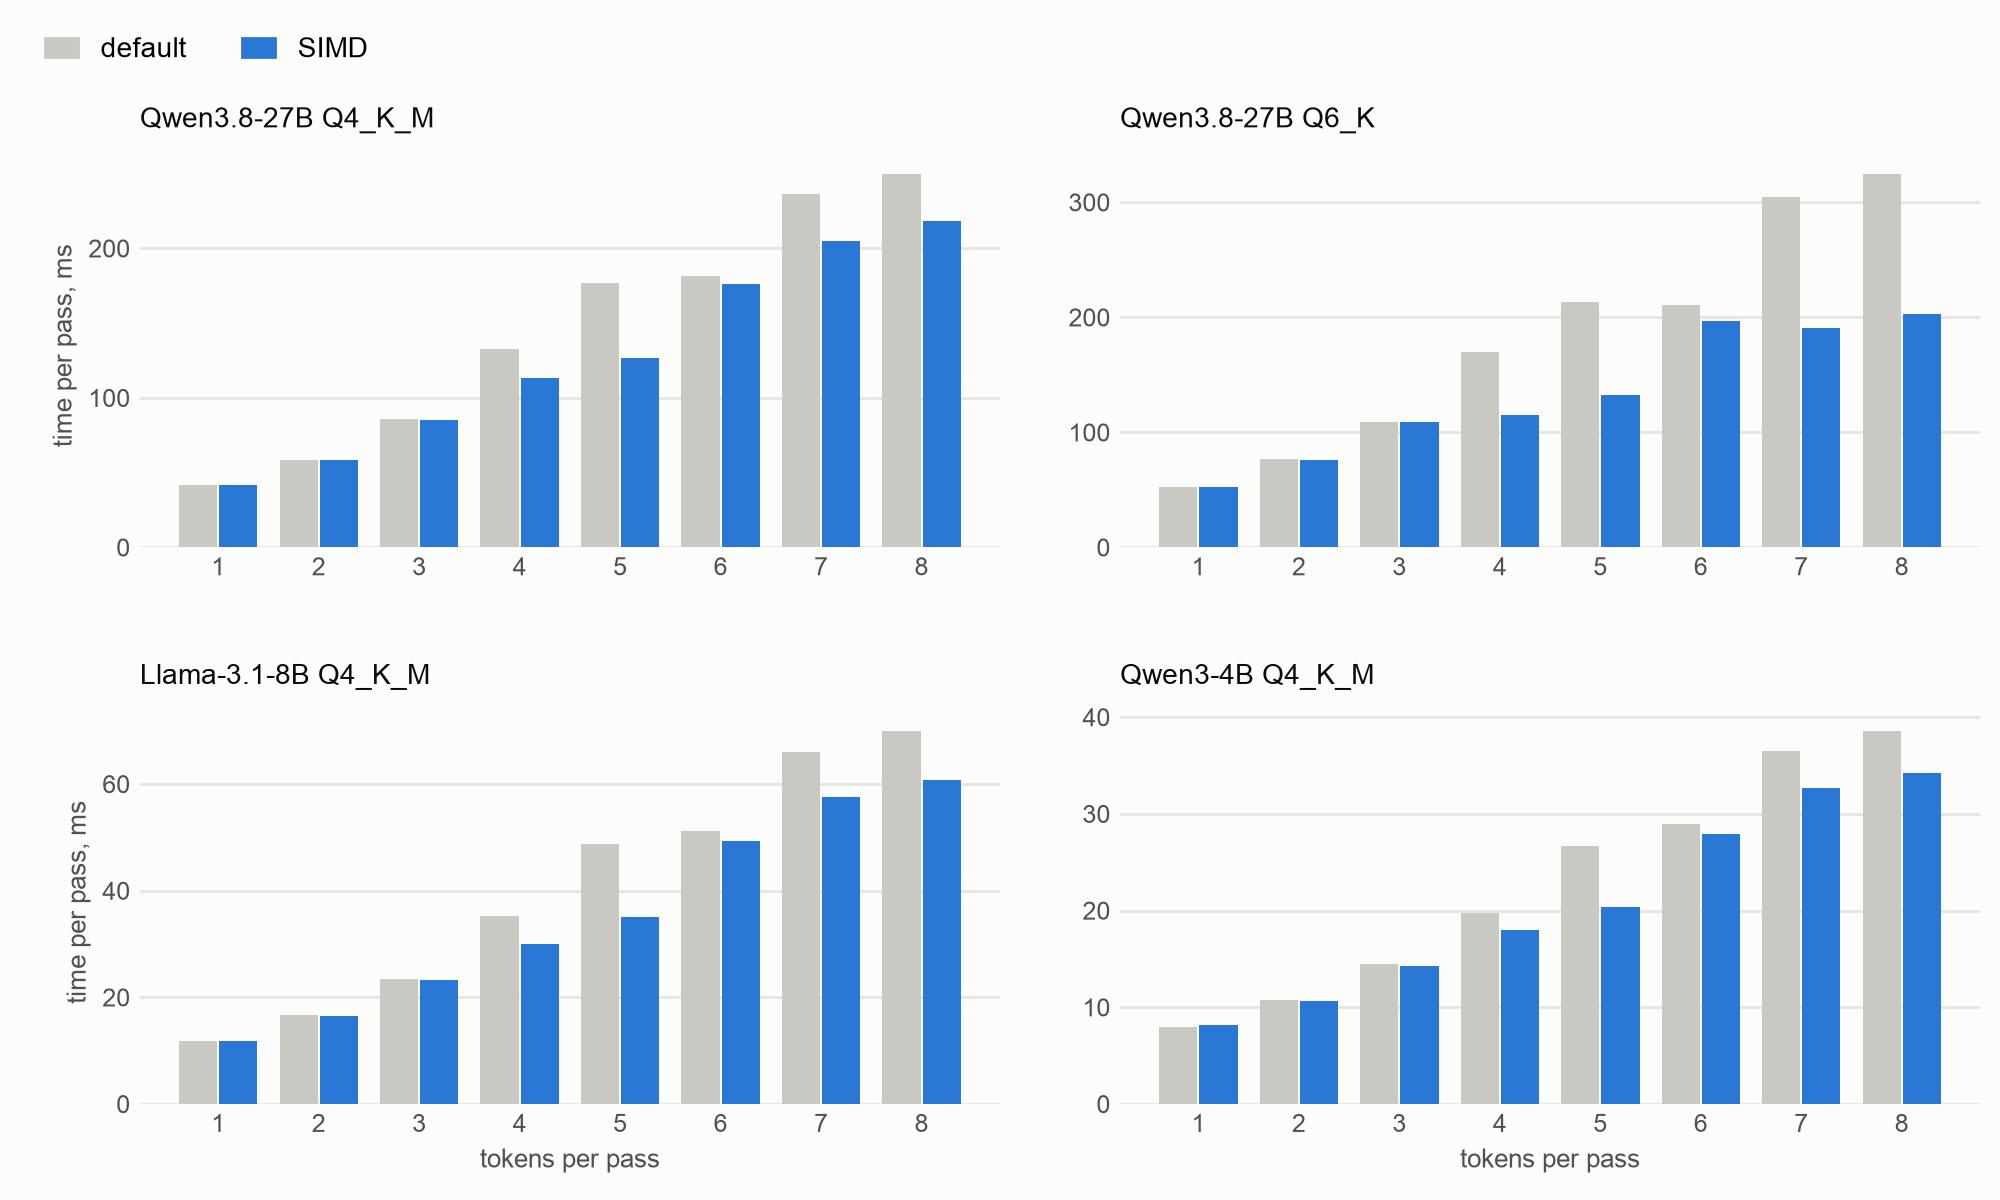
Оптимизация производительности GPU Apple Silicon через ограничение SIMD-групп

Связь между архитектурой GPU Xbox 360 и мобильными чипами нулевых

Х@habr_comмедиа / агрегатор
3 нед
Связь между архитектурой GPU Xbox 360 и мобильными чипами нулевых

Microsoft внедряет технологию Advanced Shader Delivery для GPU NVIDIA и Intel

P@prohitecавтор про «tech»
3 нед
Microsoft внедряет технологию Advanced Shader Delivery для GPU NVIDIA и Intel

Google Colab теперь включен в подписки Google AI

М@cgeventAI-инженер
3 нед
Google Colab теперь включен в подписки Google AI

Настройка P2P на GPU NVIDIA CMP 90HX

Х@habr_comмедиа / агрегатор
4 нед
P2P на CMP 90HX заработал — и сначала оказался медленнее обмена через RAM Штатный драйвер NVIDIA считает, что CMP 90HX не поддерживает прямой обмен между GPU. Но внутри всё тот же GA102, а в драйвере остались внутренние механизмы, позволяющие принудительно переопределять обычные ограничения возможностей. После нескольких дней сборки модулей, чтения логов и CUDA-тестов P2P наконец заработал. И выдал около 250 МБ/с — против 1,60 ГБ/с через системную память. То есть задача из «как включить P2P» превратилась в «почему рабочий P2P передаёт данные со скоростью флешки». Дальше пришлось разбираться уже с причиной этой скорости.
Настройка P2P на GPU NVIDIA CMP 90HX

xAI расширяет дата-центр Colossus 2 до 660 000 GPU

I@itcnewsruавтор про «tech»
1 мес
xAI Маска собирается установить 660 000 ИИ-ускорителей NVIDIA Компания расширяет дата-центр Colossus 2 в Мемфисе. К концу 2026 года там планируют разместить до 660 000 GPU NVIDIA Blackwell GB300. По словам Маска, xAI уже устанавливает 440 000 ускорителей, а ещё 220 000 должны добавить до конца года. На этих мощностях компания развивает собственные ИИ-модели, конкурируя с OpenAI и Anthropic.
xAI расширяет дата-центр Colossus 2 до 660 000 GPU
Ещё ↓