обучение моделейСбросить фильтр ×

Почему для сложных вопросов автор советует отключать поиск

A@oestickAI-инженер
вчера

Подборка инструментов, моделей и советов для MOSS-Image

Н@GreenNeuralRobotsAI-инженер
вчера

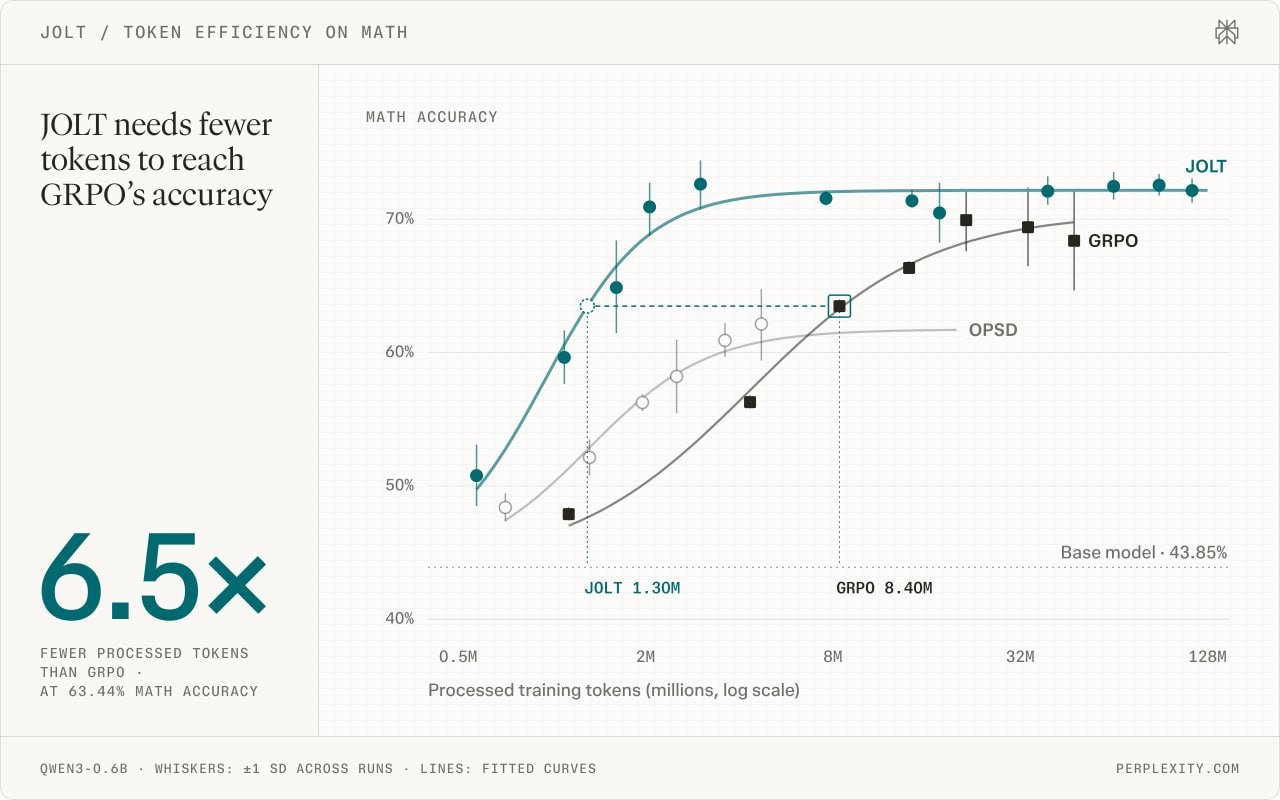
Perplexity представила метод самообучения моделей JOLT

2 дн
Perplexity представила метод самообучения моделей JOLT

Dust предлагает обучать трансформеры без обратного распространения ошибки

В Dust активации зашумляют независимо для каждого токена, а изменения лосса используют для оценки направления сдвига выходов слоёв. Полученную оценку превращают в псевдоградиентi и передают оптимизатору — например, SGD или Adam — без явного вычисления градиента обратным распространением.

Авторы проверили метод на небольшой GPT-2-like модели: он сходился заметно лучше эволюционного бейзлайна EGGROLLi и, по их данным, конкурировал с SGD. Подход может быть полезен для обучения моделей с недифференцируемыми компонентами, хотя приведённые эксперименты охватывают только ограниченный масштаб.

ВыводДля каждого токена используют несколько независимых шумов; псевдоградиент получают усреднением изменений лосса, умноженных на шум.

8-слойнойразмер тестовой модели
2kдлина контекста
10–20 млнтокенов в бюджете обучения

Полный разбор →

Истории апокалипсиса в заказной разработке

B@bogdanisssimoAI-инженер
3 дн
Модель, пережившая апокалипсис. Апокалипсис в заказной разработке приходит из самых неожиданных мест. С неба, когда прилетает туда, где лежали все данные или товары. Или от клиента, через годы после приёмки, письмом «верните все деньги». Для тебя тебя это может звучать, как страшный сон, а мы прямо сейчас это проживаем. Несколько актуальных историй из личного опыта собрала в PDF: – прилет по инфраструктуре. Что делать, если данных, на которых модель обучалась несколько лет больше не существует и как в таком случае пройти приемку? – страшный сон ЭЯЙ-разработчика: клиент через год после приёмки требует вернуть все деньги. Enjoy 💅

У GLM-5.3 обнаружили способность учитывать будущее обучение

Х@htech_plusисследователь
4 дн
У GLM-5.3 обнаружили способность учитывать будущее обучение

Microsoft завершила предобучение модели MAI-Base-2

4 дн
Microsoft завершила предобучение модели MAI-Base-2

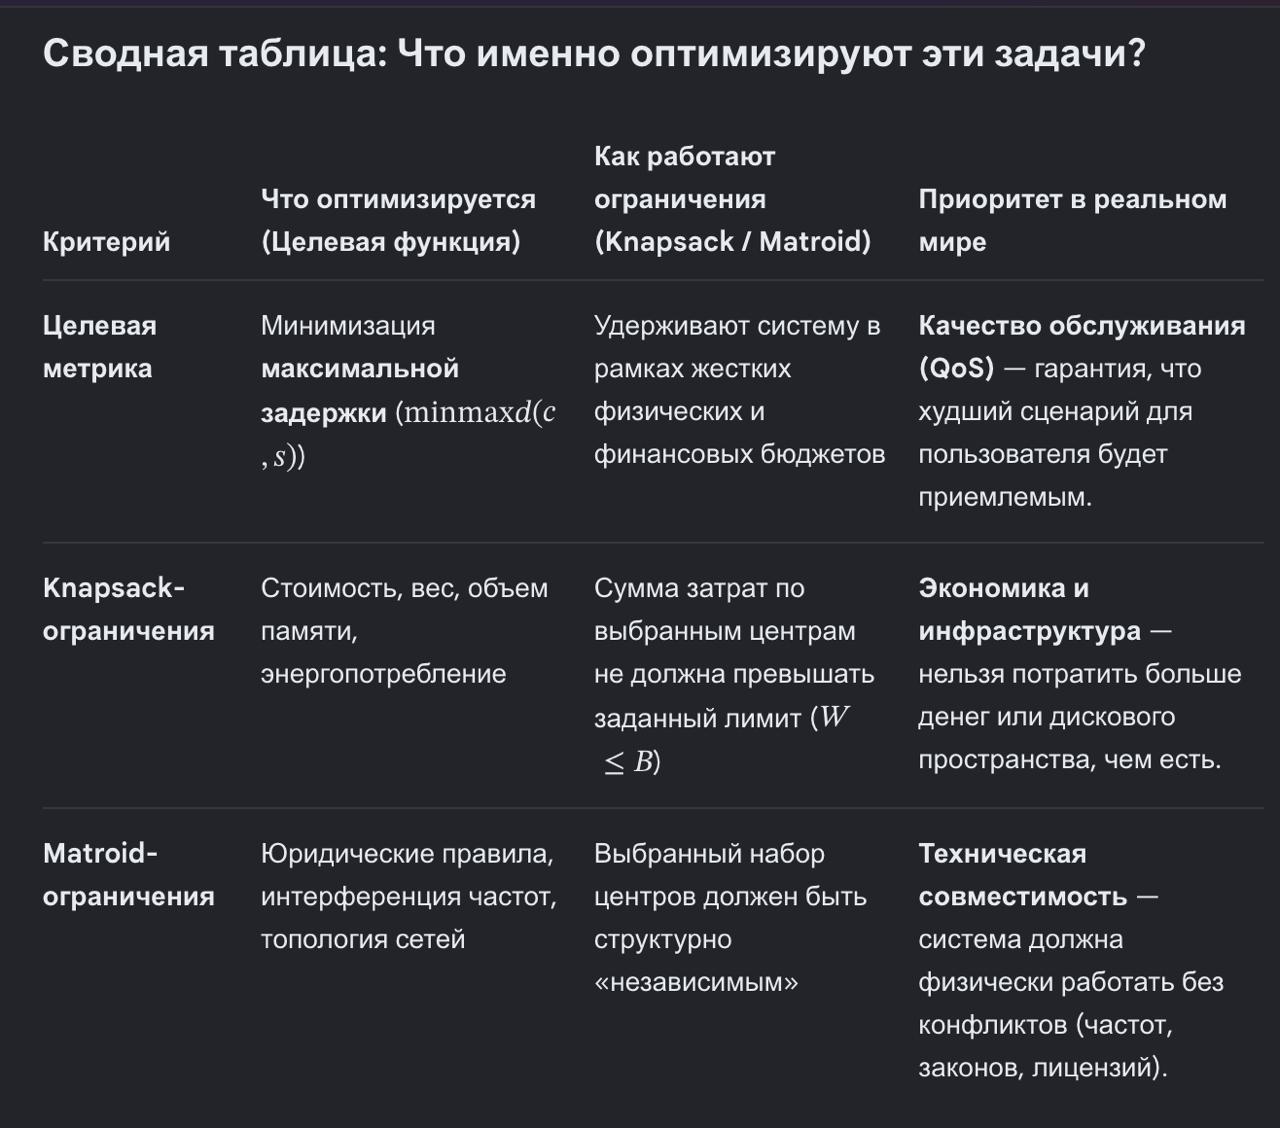
Задачи оптимизации для ИИ-агентов и самообучающихся моделей

T@kryak_startupAI-инженер
5 дн
Задачи оптимизации для ИИ-агентов и самообучающихся моделей

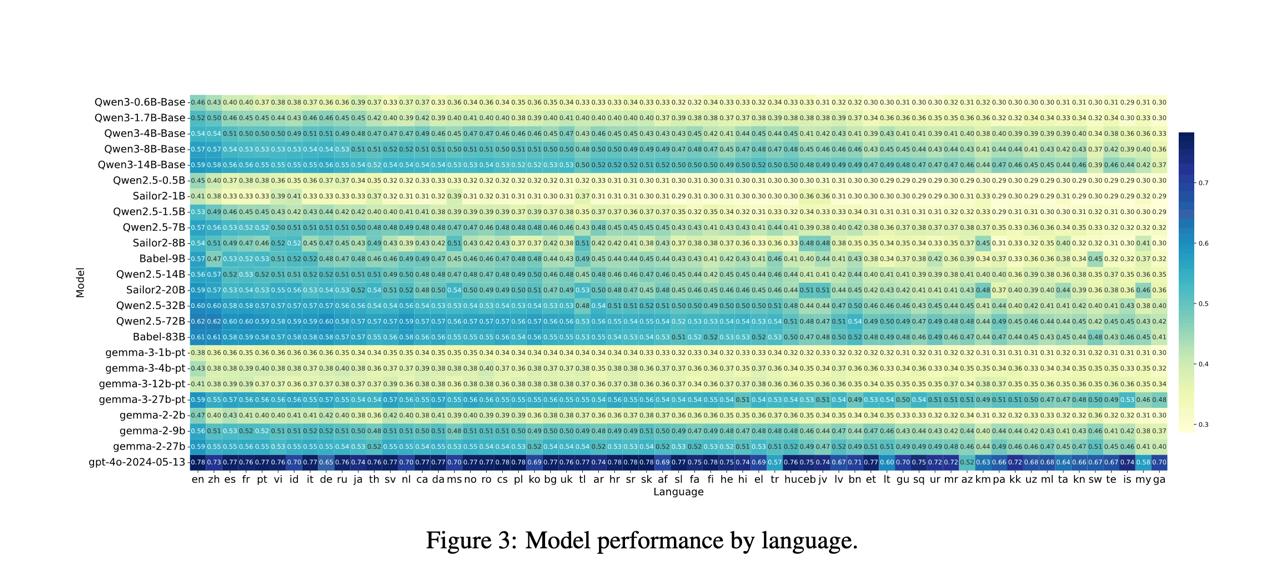
На каком языке LLM отвечают лучше: выводы MuBench

Б@ezhov_targetingавтор про «marketing»
6 дн
На каком языке LLM отвечают лучше: выводы MuBench

LILIE предлагает смысловую функцию потерь для обучения генерации изображений

Н@GreenNeuralRobotsAI-инженер
1 нед
LILIE Энкодер из Стэнфорда, делает потери при обучении картинок умнее Пиксельная ошибка одинаково наказывает за шум на небе и за размытый самолет, хотя смысл у них разный. LILIE учит пространство, где расстояние ближе к смыслу. • Обратимый энкодер: картинка разбирается и собирается обратно без потерь • Обучен так, чтобы языковая модель по зашумленным признакам восстанавливала подпись • Дает готовую функцию потерь для текст-в-картинку, работает вместе с обычным пиксельным лоссом • В комплекте кодировщики и генеративные модели github.com/SuchirAgarwal/lilie huggingface.co/suchiragarwal/lilie #encoder #training MAX

Разработчик MOSS-Image ответил на вопросы о модели и планах

Н@GreenNeuralRobotsAI-инженер
1 нед

У Anthropic высокая валовая маржа, но она не учитывает затраты на обучение моделей

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 1 нед назад

По данным Bloomberg и FT, валовая маржа Anthropic в третьем квартале составила около 85%; другой источник оценивает её как более 80%. Однако этот показатель учитывает обслуживание запросов клиентов, но не обучение новых моделей и не долю облачных партнёров, поэтому сам по себе не отражает полную экономику бизнеса.

Компания получает около $100В годовой выручки при мощностях в 5 гигаватт, но, по данным одного из источников, лишь 25% ресурсов уходит на обслуживание клиентов, а остальные 75% — на обучение моделей и технические эксперименты. Это ставит высокую маржу в контекст значительных затрат на инфраструктуру и разработку.

около 85%валовая маржа в третьем квартале
около $100Вгодовая выручка
10,5 ГВновые мощности в 2027 году

Полный разбор →

Что почитать о масштабном обучении моделей

g@grokaem_sebyмедиа / агрегатор
1 нед
Люди, которые занимаются training on scale? Что порекомендовали бы почитать? Не хватает какой-то хардкор литературы по scaled тренировке, чтобы все было стабильно. Умею это все делать, но не хватает каких-то знаний по анализу утилизации и выявлению проблем.

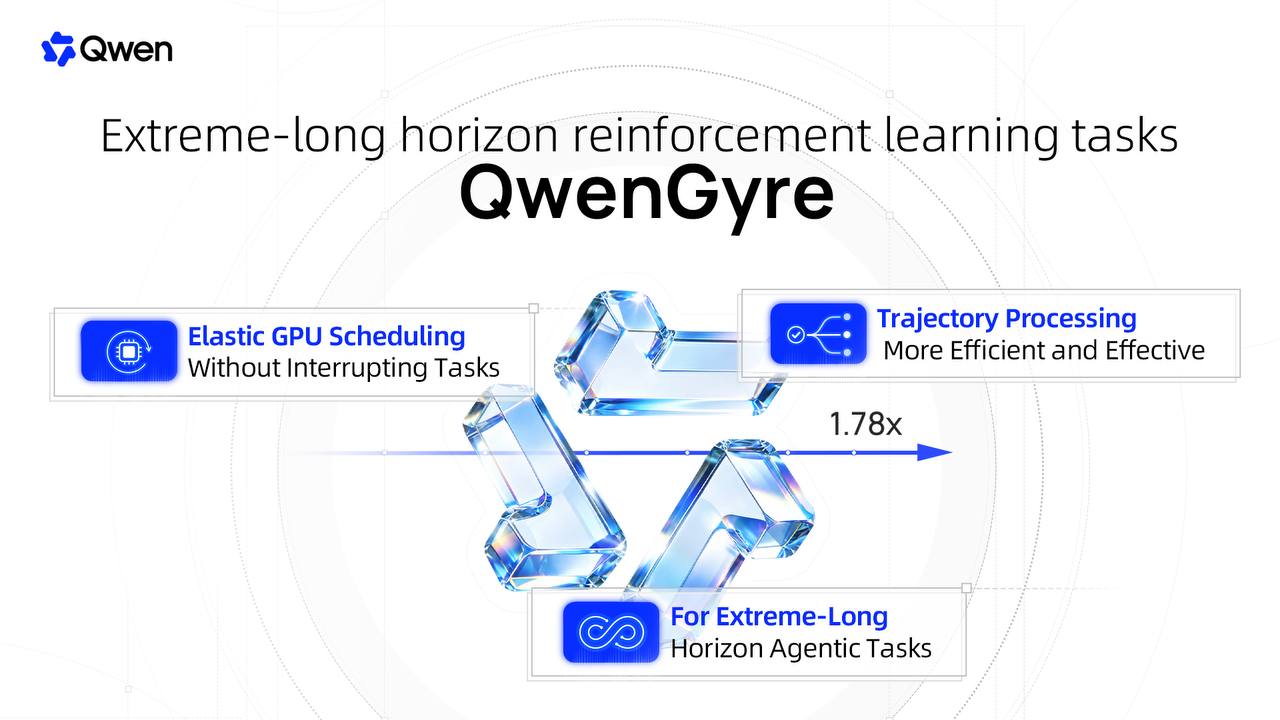
Qwen представила QwenGyre для ускорения обучения ИИ-агентов

2 нед
Qwen представила QwenGyre для ускорения обучения ИИ-агентов

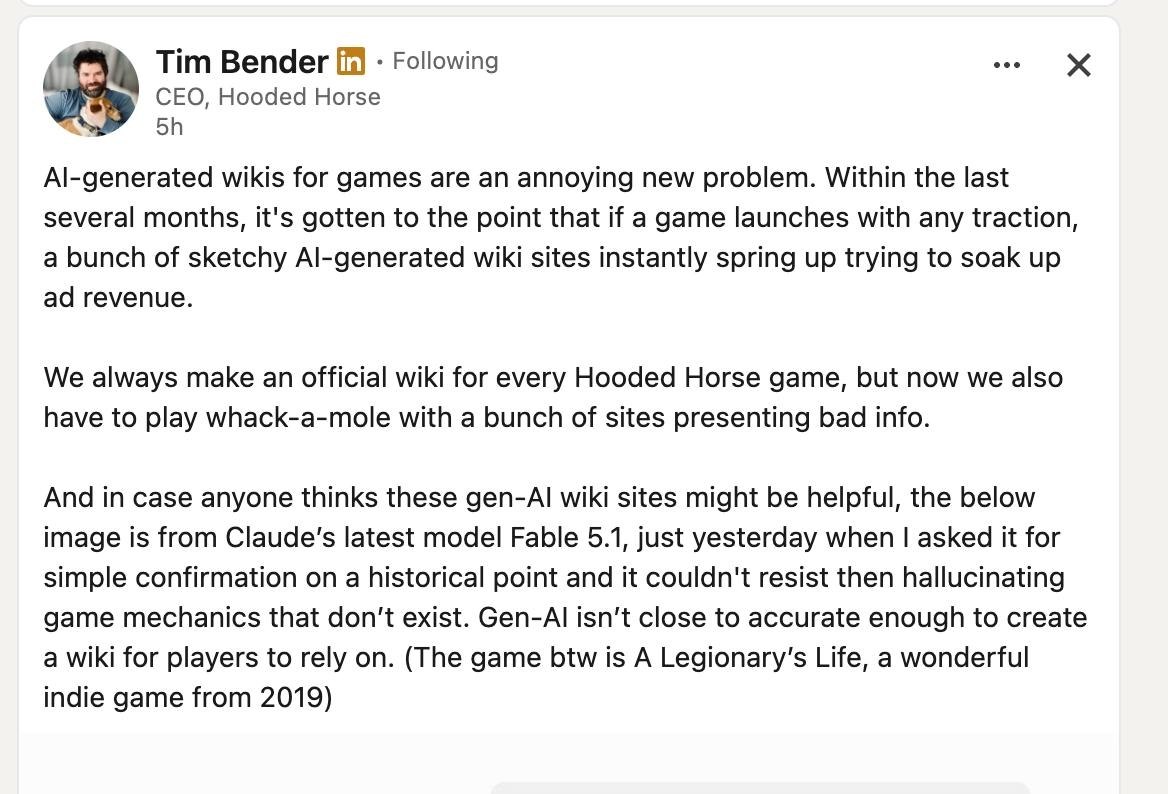
Проблема загрязнения данных в AI

G@GameDEVгеймдев
2 нед
Yep: data pollution is an enormous issue in many industries. From incorrect technical guidelines and game Wikis to literally wrong interpretation of the whole Scottish language (thanks to literally one schoolboy who incorrectly translated thousands of articles over the years). #AI@GameDEV
Проблема загрязнения данных в AI

Ограничения обучения роботов на больших данных

Х@htech_plusисследователь
2 нед
Ограничения обучения роботов на больших данных

HapticVLA: обучение роботов тактильному взаимодействию без сенсоров

э@ai_newzAI-инженер
4 нед

Обучение роботов через захват движений человека

Ч@honestmarketingмедиа / агрегатор
4 нед
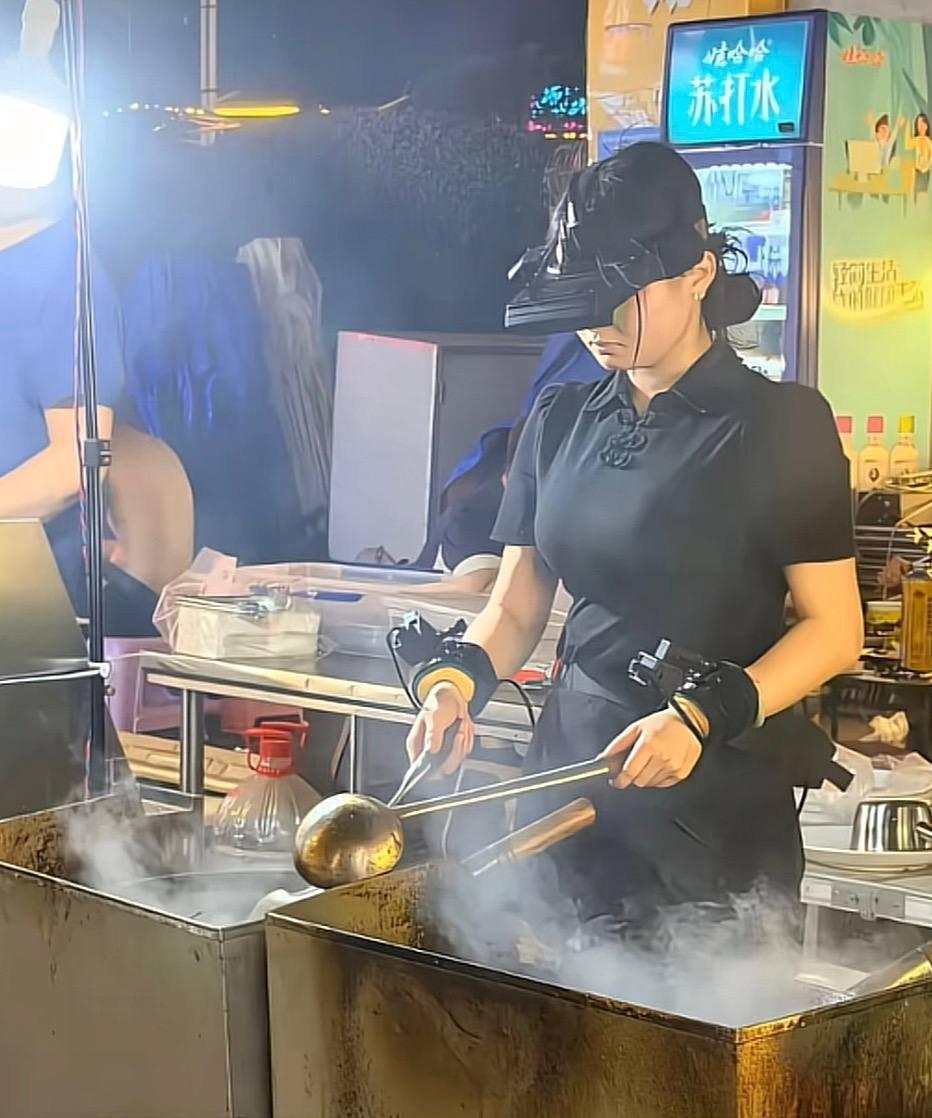
Как думаете, что происходит на этом фото прямиком из киберпанка? Ответ: девушка записывает свои движения, чтобы ИИ мог обучиться для них, и роботы смогли делать так же
Обучение роботов через захват движений человека

Статья о сжатии данных в LLM принята на NeurIPS 2026

С@oulenspiegel_channelAI-инженер
4 нед

OpenAI увольняет подрядчиков за использование ИИ в работе по улучшению ИИ

OpenAI уволила нескольких подрядчиков, которых наняла для улучшения ответов своих моделей, за то, что те выполняли эту работу с помощью нейросетей — включая Grammarly и ИИ-переводчики. Об этом со ссылкой на внутренние документы компании и разговоры с тремя подрядчиками пишет 404 Mediai.

Ирония ситуации в том, что людям, чья задача — оценивать и улучшать ответы ИИ-моделей, самим запрещено пользоваться любыми ИИ-инструментами. Причина запрета — риск «коллапса моделей»: обучение на данных, сгенерированных более ранними нейросетями, постепенно ухудшает качество, вариативность и точность результата.

10 000человек в проектах оценки моделей
1000коллег в одной рабочей группе

Полный разбор →

Сотрудник Anthropic объяснил причины изменения стиля письма Claude

1 мес
Сотрудник Anthropic объяснил причины изменения стиля письма Claude

Negative Self-Distillation: LLM учат избегать ошибочных рассуждений, а не подражать правильным

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 1 мес назад

Авторы новой статьи предлагают альтернативу стандартному алайнменту LLM: вместо того чтобы учить модель имитировать правильный ответ или максимизировать награду в среде (что часто приводит к overconfidence — избыточной уверенности модели в себе), метод учит модель избегать имитации неправильного ответа.

Для этого строится «negative teacheri»: студенческая модель сама генерирует решение задачи, затем ей же дают задачу и её собственное решение и просят через meta-prompt придумать инструкцию, которая направила бы рассуждение по плохому пути. Gold answer при этом не используется — модель не обязана знать, где решение действительно ошибочно, ей нужно лишь найти уязвимое место или предложить вредную стратегию рассуждения.

ВыводПрямая оптимизация неправдоподобия не работает: многие токены неверного решения являются частями верных синтаксических и грамматических конструкций, и наивная оптимизация разваливает модель

1.7Bразмер малой модели Qwen3 в тестах
4Bразмер средней модели Qwen3 в тестах
8Bразмер крупной модели Qwen3 в тестах

Полный разбор →

Ещё ↓