Dust: претрейн трансформеров без обратного распространения ошибки
К@quant_prune_distillAI-инженер
3 днВ блогпосте представлен алгоритм оптимизации нулевого порядка для предобучения трансформеров без обратного распространения ошибки.
Dust: Pretraining Transformers Without Backpropagation
📑 Блогпост
На данный момент алгоритмы градиентного спуска с обратным распространением ошибки безраздельно доминируют среди алгоритмов обучения глубоких нейронных сетей.
Было предложено множество разнообразных идей разной степени безумия и абсурдности в качестве альтернатив, не требующих явного подсчёта градиента: эволюционные алгоритмы, Forward-Forward имени Хинтона. Увы, на практике они сходятся из ряда вон медленно, и никто в здравом уме не запустит претрейн БЯМ на них.
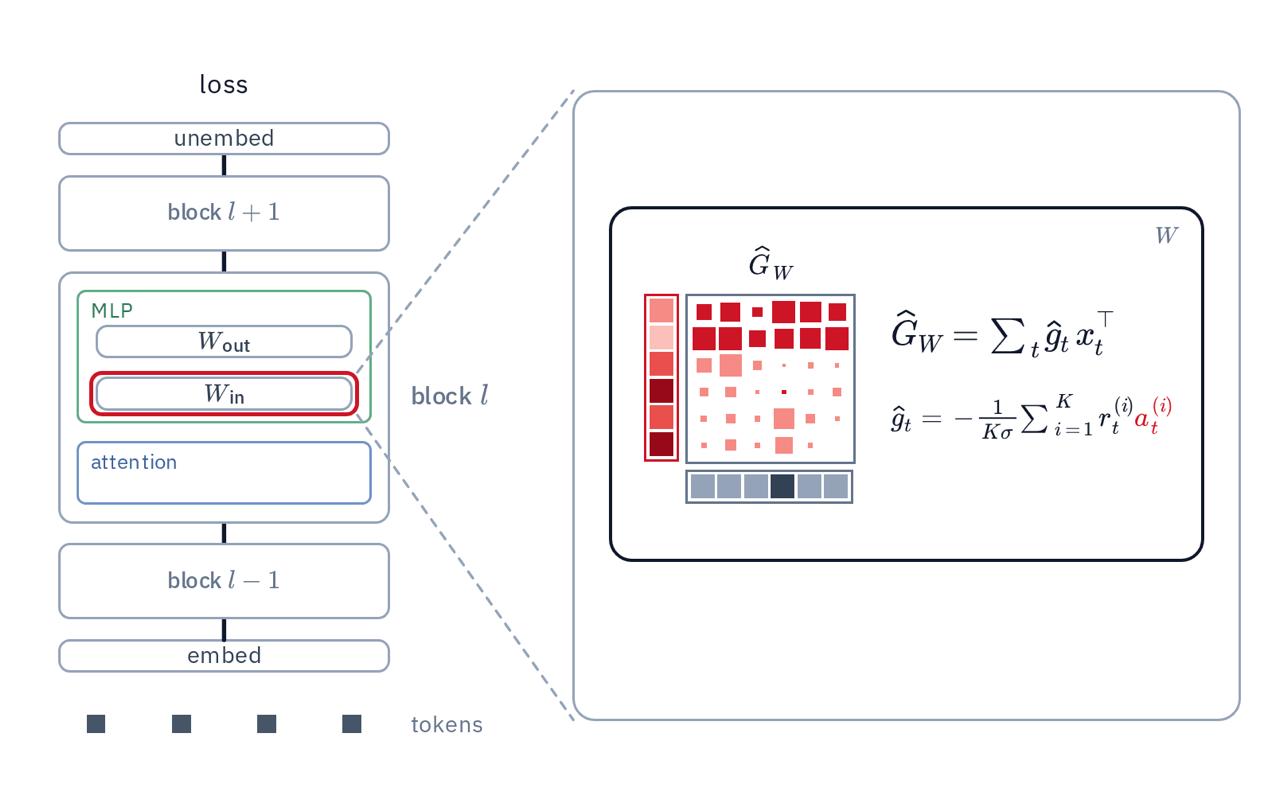
В этом же блогпосте ребята предлагают yet another алгоритм оптимизации нулевого порядка, обладающий значительно лучшей сходимостью, чем существовавшие ранее подходы.
Кратко (AI)
В блогпосте Dust описан алгоритм оптимизации нулевого порядка для предобучения трансформеров без обратного распространения ошибки. Авторы утверждают, что он сходится заметно лучше прежних подходов, не требующих явного вычисления градиента.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖