Negative Self-Distillation: обучение LLM через избегание ошибок
К@quant_prune_distillAI-инженер
1 месОбзор метода Negative Self-Distillation для улучшения рассуждений LLM путем обучения модели избегать неверных ответов вместо простого подражания правильным.
Новый метод обучения помогает нейросетям реже ошибаться и быть менее самоуверенными в своих ответах.
- Традиционное обучение часто делает модели излишне самоуверенными в неверных ответах.
- Метод Negative Self-Distillation учит модель распознавать и избегать типичных ошибок.
- Это позволяет повысить качество логических рассуждений нейросетей без потери стабильности.
🧠 Negative Self-Distillation: Learning to Reason by Avoiding Flaws
📄 Статья
Обыкновенно при обучении / алайнменте LLM мы либо явно учим модель на хороших ответах, либо запускаем её в какую-то среду, где она учится находить решение, максимизирующее некоторую награду.
Однако в результате часто оказывается, что модель становится чрезмерно уверенной в себе после такой процедуры обучения.
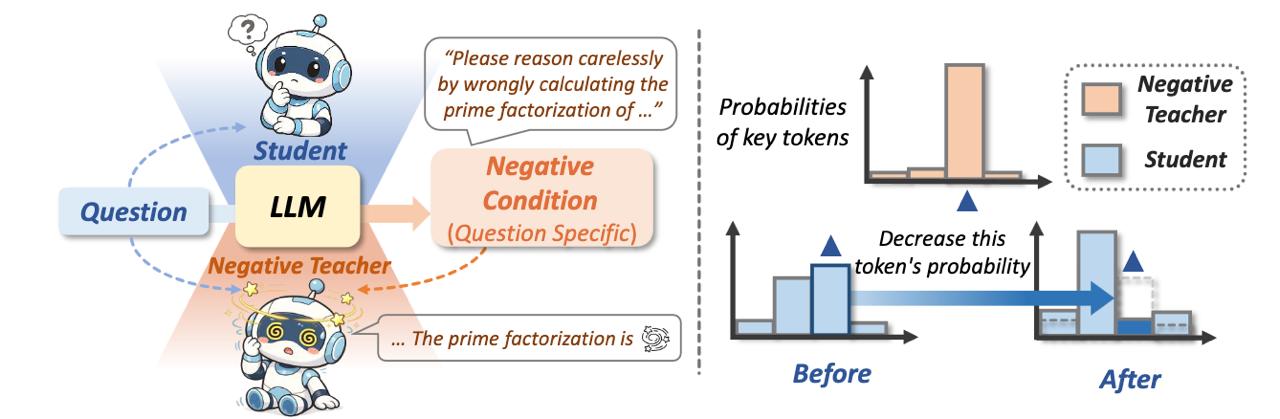
Авторы данной статьи предлагают не подражать правильному ответу, а не подражать неправильному. Это и улучшает модель, уводя от неверных решений, и помогает меньше коллапсировать.
Кратко (AI)
В статье рассматривается метод Negative Self-Distillation, который предлагает улучшать качество рассуждений LLM не через имитацию правильных ответов, а через обучение модели избегать заведомо неверных решений. Такой подход помогает снизить излишнюю самоуверенность моделей и предотвратить деградацию их способностей в процессе обучения.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖