Метод JOLT совмещает роли учителя и ученика в одной модели; JOLT+ показал лучшие средние результаты в тестах, чем GRPO.
📌
Perplexity научила модель быть учителем самой себе
ИИ-поисковик
предложил метод обучения под названием JOLT, в котором одна и та же модель выступает сразу учеником и учителем, причём обе роли учатся одновременно.
При обучении с подкреплением модель получает награду только за итог попытки, и по ней не понять, какие именно шаги привели к успеху. На длинных агентных задачах, где попытки редко удаются, такого сигнала мало. Обходят это дистилляцией, когда модель посильнее оценивает каждый токен ученика и подсказки становятся плотнее.
Но умение решать задачу и умение её объяснить не одно и то же. Сильный учитель легко уходит туда, куда ученик за ним не дотянется, и подсказки пропадают впустую.
В JOLT учитель видит проверенный ответ, разобранное решение или отчёт о прошлых попытках, а ученик работает вслепую.
Обе роли живут в одной модели и обновляют общие веса. Ученик тянется к подсказкам учителя, а учитель получает задачу подстроиться под ученика, т. е. давать такие подсказки, которые двигают его в ту же сторону, куда двигало бы обычное обучение с подкреплением на его собственной награде.
У метода есть второй вариант, JOLT+. В нём ученик получает и подсказки учителя, и обычную награду за итог своей попытки, то есть плотный и разреженный сигналы складываются.
🟡
Тесты
Метод проверяли на небольших моделях DeepSeek и Qwen, от 0,6 до 30 млрд параметров. Задачи брали разные, от школьной математики и олимпиадных задач до генерации кода, работы с приложениями и команд в терминале. Сравнивали с GRPO и двумя методами дистилляции.
JOLT+ везде показал лучший средний результат, обойдя GRPO на 4,2 процентных пункта на наборе MATH, на 3,0 на LiveCodeBench и на 9,9 на AppWorld.
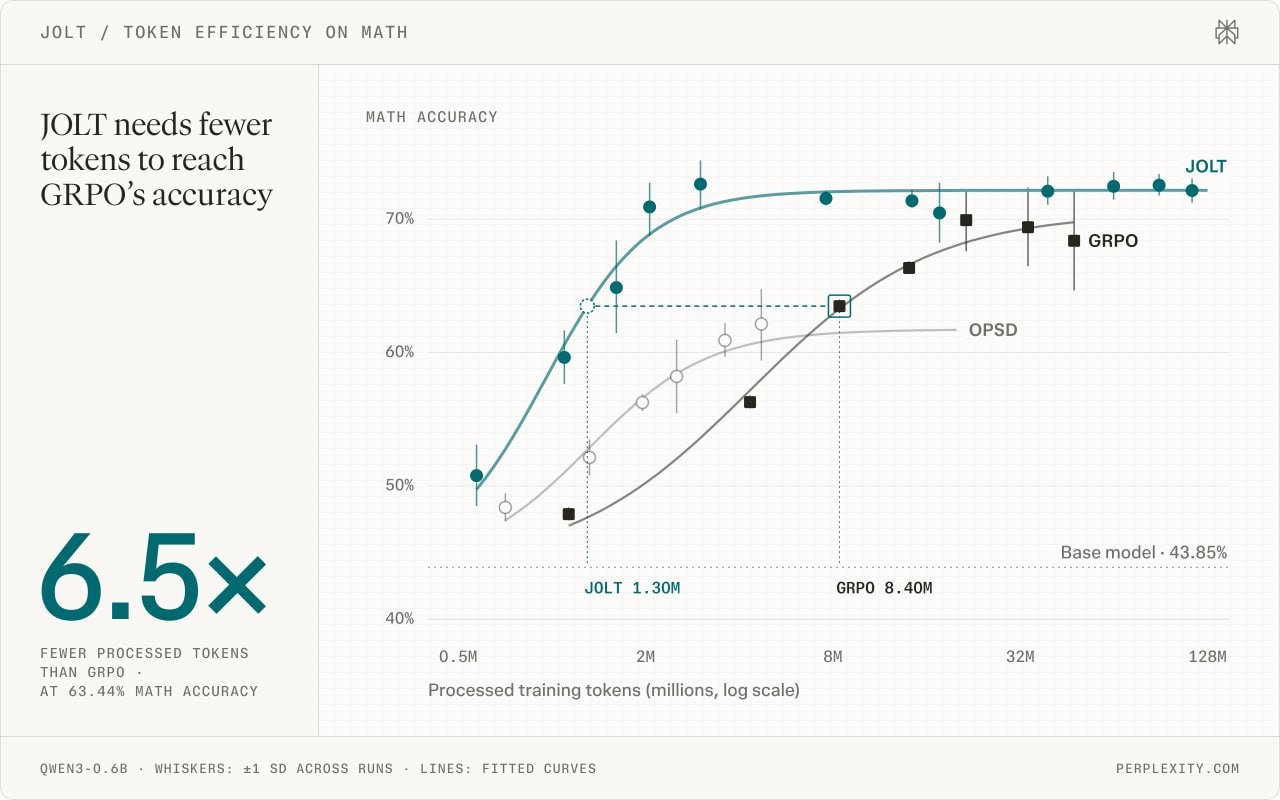
На MATH при равной точности JOLT потратил в 6,5 раза меньше обработанных токенов обучения и примерно в 13 раз меньше сгенерированных.
Без награды ученика метод работает хуже. На AppWorld чистый JOLT отстал и от GRPO, и от конкурирующей дистилляции, а на Terminal-Bench уступил GRPO.
Perplexity обещает открыть код позже, пока есть только
статья с описанием метода.
@ai_machinelearning_big_data
#AI #ML #LLM #Research #RL #Perplexity
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖