optimizaciiaСбросить фильтр ×

FRIDA-Decisions: эффективная модель для принятия решений

M@mashkka_dsAI-инженер
2 нед
FRIDA-Decisions: эффективная модель для принятия решений

GRACE: метод сжатия латентов для ускорения генерации видео

Н@GreenNeuralRobotsAI-инженер
2 нед

MachGen опубликовала открытую реализацию VC-Attention для ускорения видео-генерации на NVIDIA Blackwell

Команда MachGen выпустила в открытый доступ реализацию VC-Attentioni (предположительно описанного в некой статье метода) для архитектуры NVIDIA Blackwell. На GPU B200 она почти в 2 раза быстрее BF16 FlashAttention-4i при генерации видео такими моделями, как MiniMax H3, и даёт ещё около 20% прироста сверх оригинального метода из статьи.

Это важно для разработчиков видео-генеративных моделей: ускорение attention напрямую снижает время и стоимость рендера роликов на Blackwell-картах без потери качества.

2×ускорение против BF16 FlashAttention-4 на B200
~20%прирост сверх оригинального метода из статьи
0.5%доля токенов V, исправляемых V residual repair

Полный разбор →

Релиз Unreal Agent для long horizon задач

L@lovedeathtransformersAI-инженер
3 нед
Очень крутой скафолд тюненный под long horizon tasks + жрет вдвое меньше токенов чем кодекс - а значит ваша x10 подписка проживет дольше https://github.com/unreallabsai/unreal-agent

Почему нет смысла переплачивать за топовые ИИ-тарифы

N@NGI_ruAI-инженер
3 нед

WanGP v17.00: оптимизация видеогенерации

Н@GreenNeuralRobotsAI-инженер
3 нед
WanGP v17.00 обновление #lowvram видеогенерации с движком MMGP v4 — заметная экономия VRAM и прирост скорости • 15 сек #minimaxH3 видео в 1080p: было 25 ГБ VRAM, стало 11 ГБ • 480p — 15 секунд влезает в 5-6 ГБ VRAM • Profile 4: до +25% скорости и до -50% VRAM на больших роликах • Profile 5 (фолбэк) стал до 50% быстрее • Новая вкладка Config → RAM/VRAM Management: MMGP Optimized Allocator и Smart Memory Pinning Дополнительно • Attention Head Split (Medium) — ещt -20% VRAM ценой до 10% скорости • Dynamic VRAM Preload — заполняет свободную память весами • Два новых апскейлера: LTX-2.5 Detail Refiner x2 и H3 VAE Upsampler x2 MAX

PDMD: метод дистилляции видео-диффузии в 4 шага от ByteDance

Н@GreenNeuralRobotsAI-инженер
3 нед

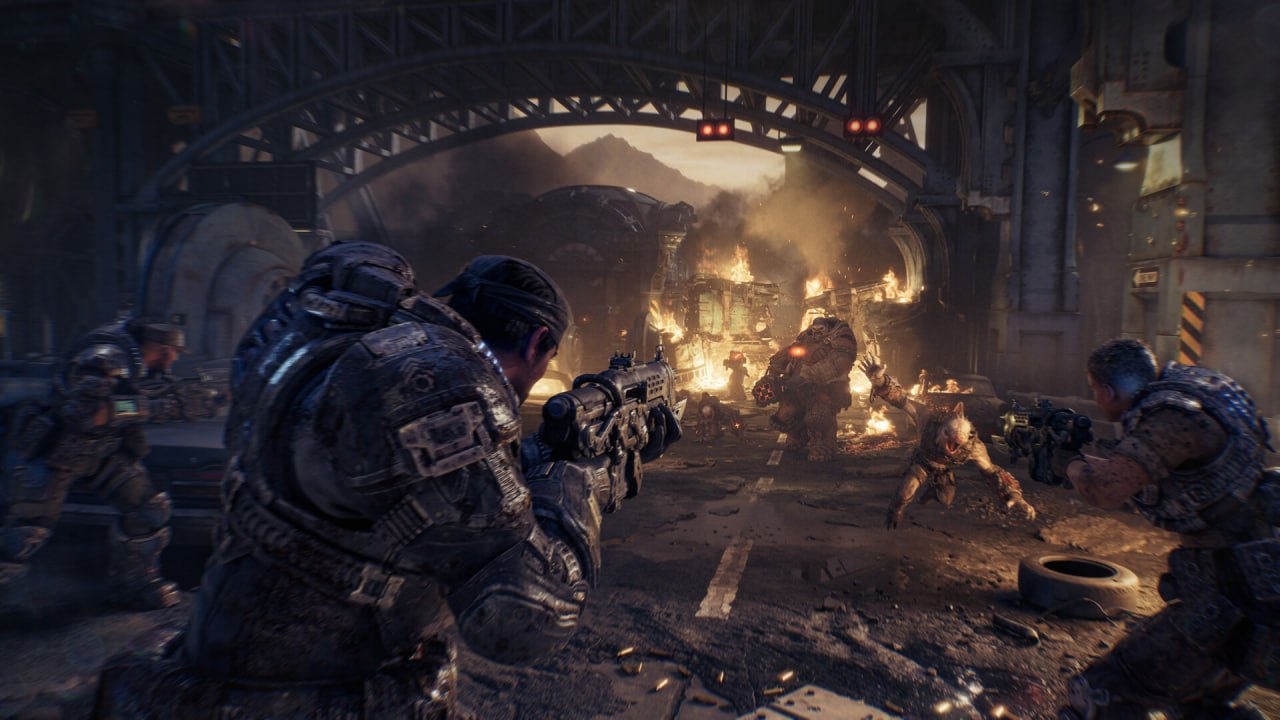
Разработчики Gears of War: E-Day оптимизировали работу с памятью на Xbox Series S

D@dtfbestгеймдев
3 нед
Разработчики Gears of War: E-Day рассказали, как решили проблему с оперативной памятью на Xbox Series S с помощью встроенного SSD-накопителя. Другие команды уже заинтересовались этим методом, поэтому его могут использовать для будущих проектов. https://dtf.ru/hard/5337807
Разработчики Gears of War: E-Day оптимизировали работу с памятью на Xbox Series S

Windows 11 26H2 неожиданно снизила потребление оперативной памяти и ускорила запуск приложений

Обновление Windows 11 26H2i стало заметно экономнее расходовать оперативную память — пользователи и тесты Windows Latest фиксируют снижение потребления в простое примерно на 2–3 ГБ. При этом Microsoft никак официально не анонсировала эту оптимизацию.

Помимо экономии памяти, обновление ускорило запуск приложений, меню «Пуск» и контекстных меню — это связывают с расширением поддержки Low Latency Profilei.

2–3 ГБснижение потребления RAM в простое

Полный разбор →

Обзор новых инструментов и оптимизаций для MiniMax H3 в ComfyUI

Н@GreenNeuralRobotsAI-инженер
3 нед

Обзор новых локальных LLM и инструментов оптимизации

Н@GreenNeuralRobotsAI-инженер
3 нед

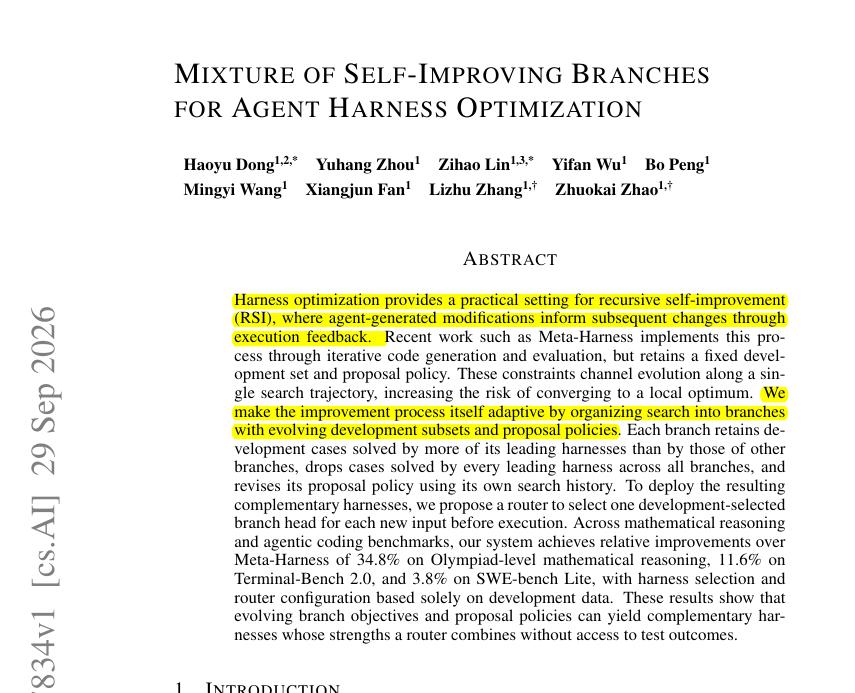
Новый метод оптимизации ИИ-агентов через специализацию веток

3 нед
Новый метод оптимизации ИИ-агентов через специализацию веток

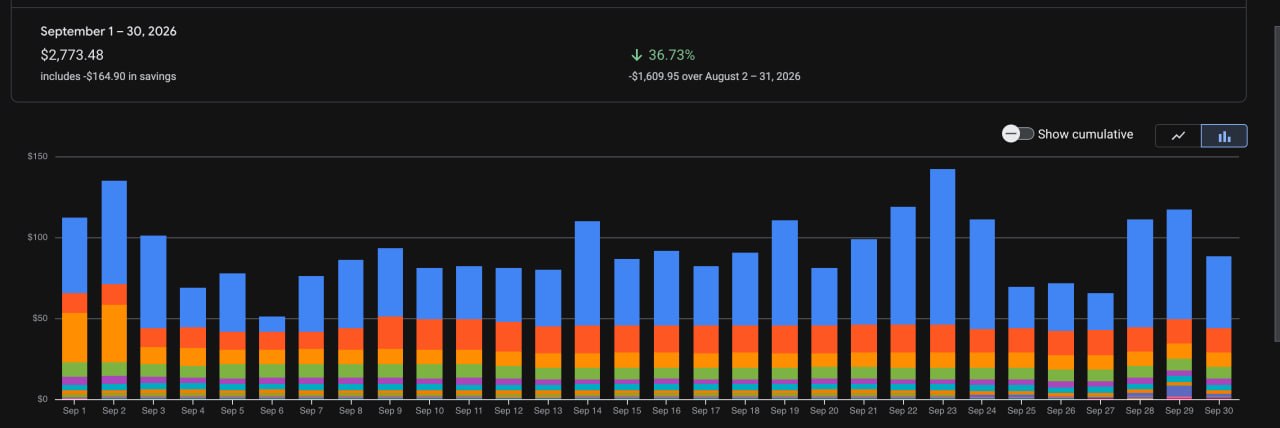
Как оптимизировать расходы на Google Cloud

E@ProductsAndStartupsAI-инженер
3 нед
Как оптимизировать расходы на Google Cloud

LongLive-Plug: универсальные адаптеры для видеомоделей от NVIDIA

Н@GreenNeuralRobotsAI-инженер
3 нед
LongLive-Plug Разработка NVIDIA: один раз дистиллируешь бэкбон — получаешь переиспользуемые адаптеры для всех задач по видео. Ниже модель, но без переобучения под каждый даунстрим-таск • Few-step LoRA — меньше шагов сэмплирования • CFG LoRA — регулируемый guidance • Long-context LoRA — качество на длинных роликах • Плюг-энд-плей: композиция нужных способностей • 50 → 4 шага сэмплирования (12.5× быстрее) • По три LoRA на бэкбон, переиспользуются на задачах семьи • Перенос в даунстрим-модели без дообучения HF - есть для #wan21 #wan22 и #minimaxh3 #optimization MAX

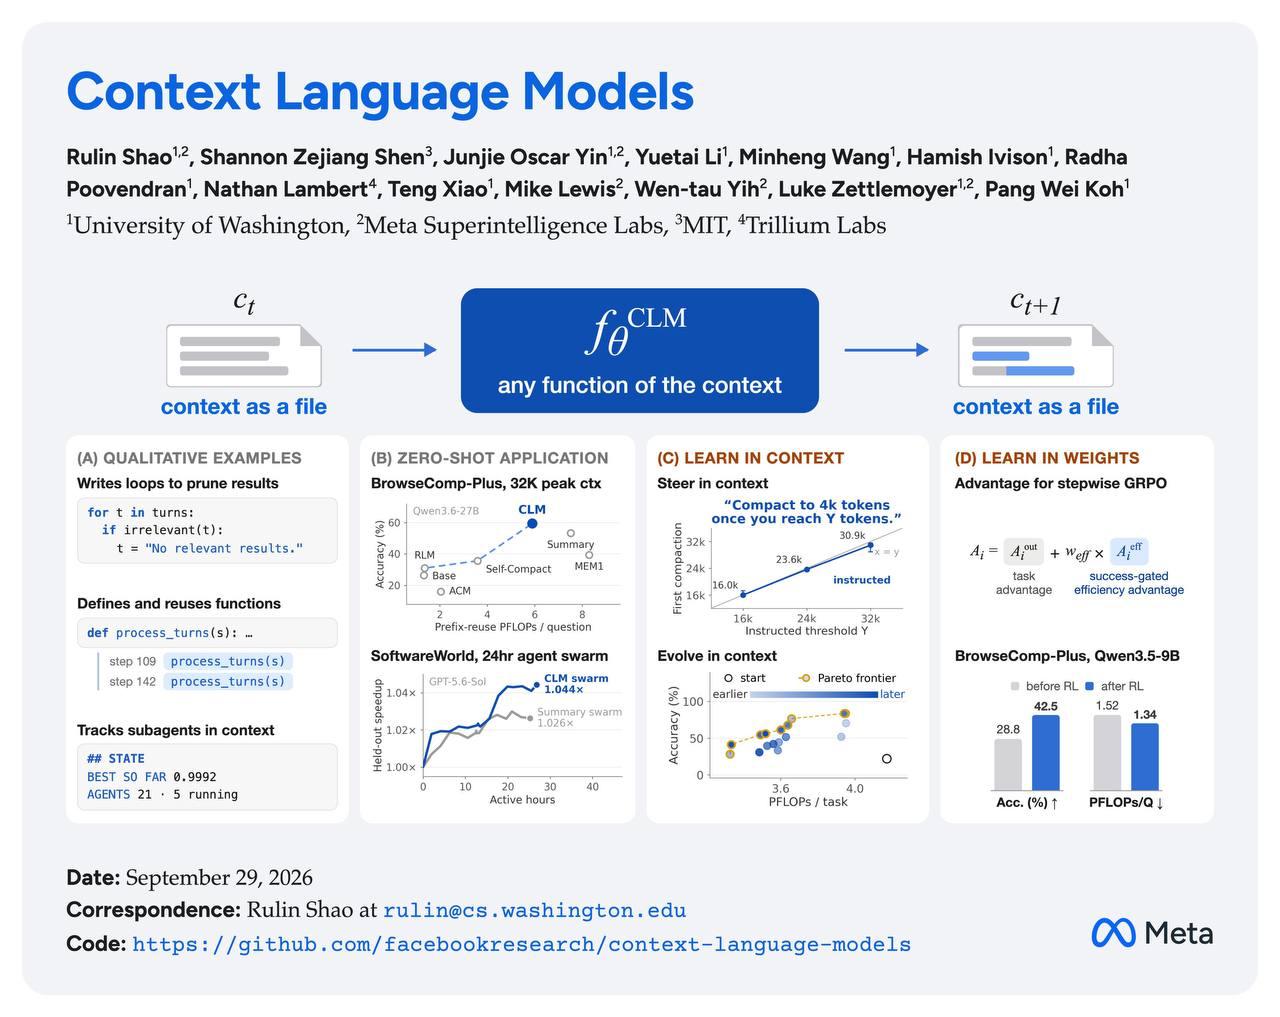
Meta представила Context Language Models: модели с полным контролем над контекстом

D@data_secretsAI-инженер
3 нед
Meta представила Context Language Models: модели с полным контролем над контекстом

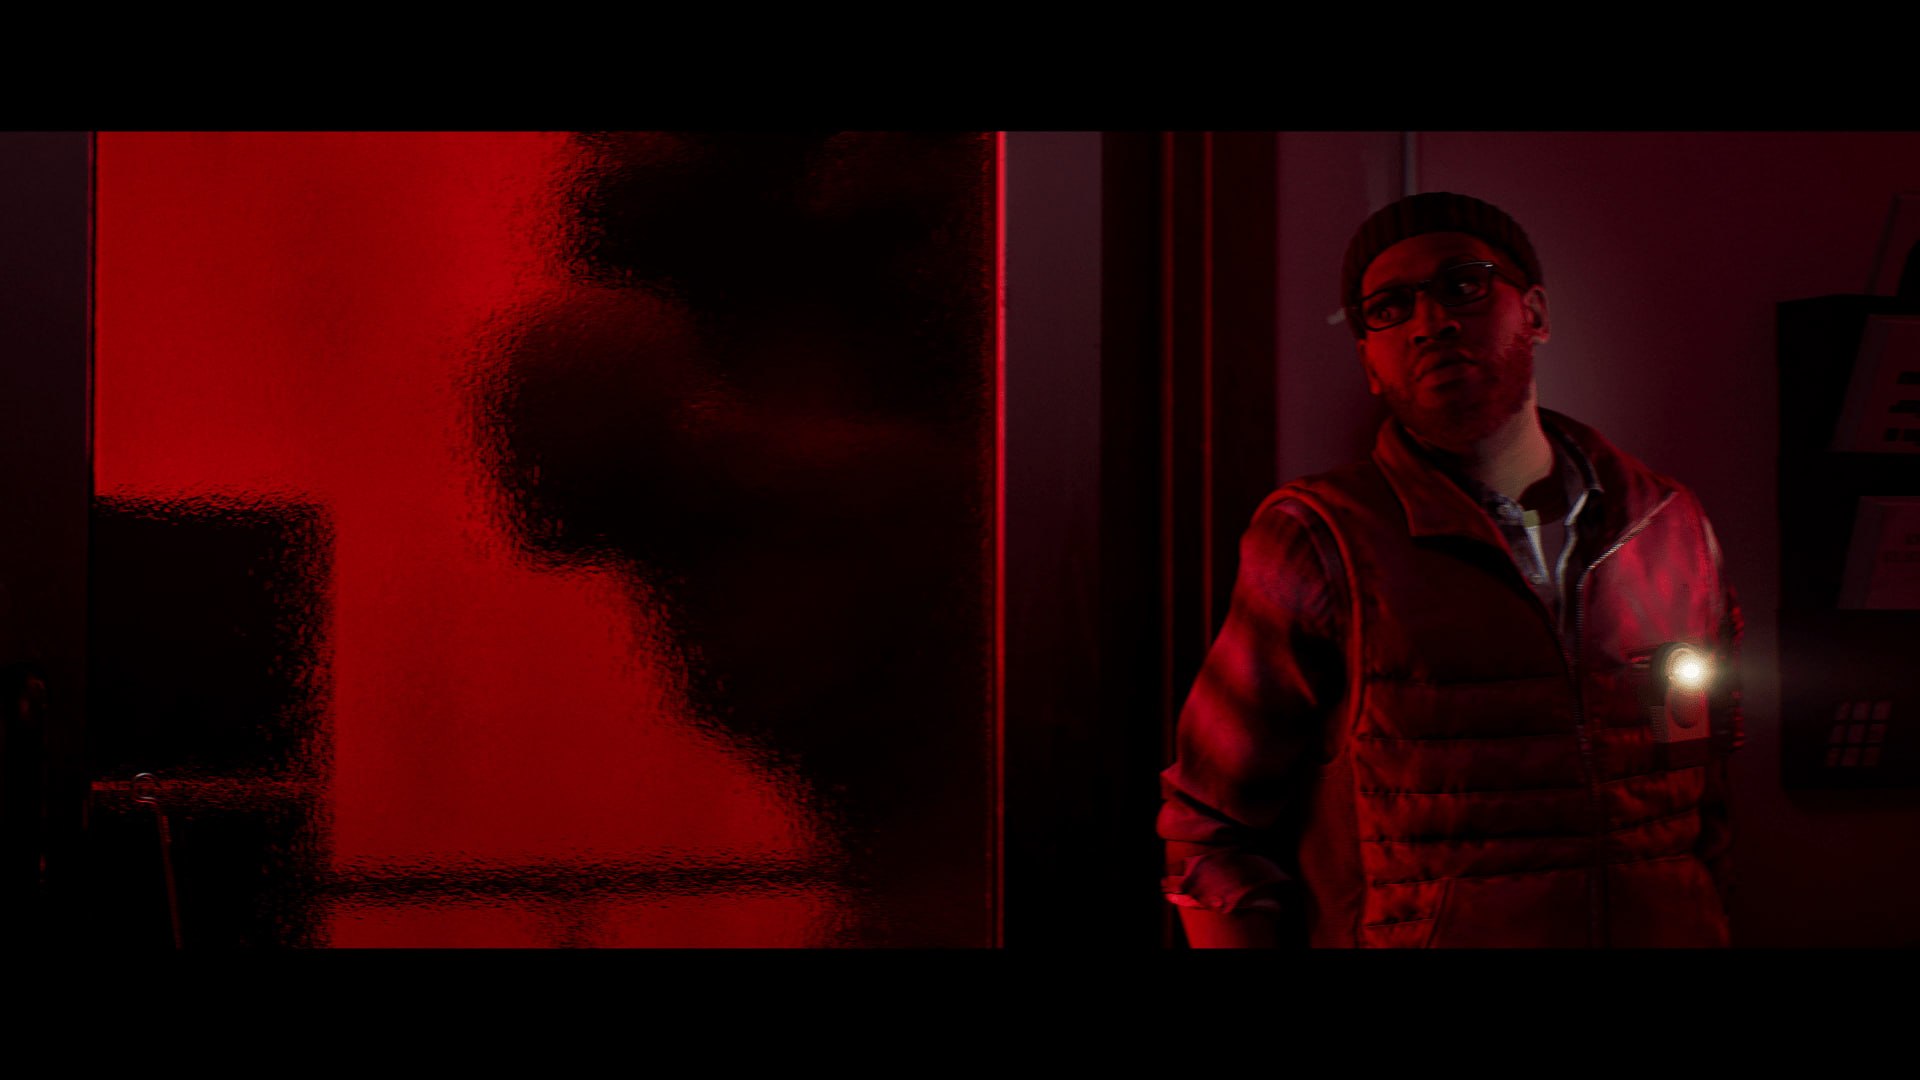
Silent Hill: Townfall получит патч для упрощения сегментов с Бременем

D@dtfbestгеймдев
3 нед
Разработчики Silent Hill: Townfall занимаются патчем, в котором упростят сегменты с Бременем — неубиваемым врагом, преследующим главного героя. А сегодня хоррор получил апдейт, призванный уменьшить количество статтеров в ПК-версии. https://dtf.ru/games/5327849
Silent Hill: Townfall получит патч для упрощения сегментов с Бременем

Бизнес-модель Bending Spoons: скупка и оптимизация стагнирующих продуктов

B@blackproductпродакт / фаундер
4 нед

Disaggregated Quantization: раздельное сжатие prefill и decode ускоряет и дешевит инференс LLM

Команда из IST и NVIDIA (первый автор @black_samorez) предложила метод Disaggregated Quantization: этапы prefill (обработка промпта) и decode (генерация ответа) одной и той же LLM обрабатываются разными квантизациями вместо единой точности для всей модели. Идея в том, что prefill упирается в скорость матричных умножений, а decode — в скорость памяти, поэтому их стоит сжимать по-разному: prefill в NVFP4i с квантованием и весов, и активаций, decode — только по весам, в сверхлёгких 1–3-битных форматах.

По данным источника 4, метод уже работает на Qwen3 и Gemma 3 и делает инференс в два раза быстрее и дешевле, при этом точность не падает, поскольку активации на decode не квантуются. Статья, код и первые чекпоинты уже опубликованы.

ВыводСтатья опубликована на arxiv.org/abs/2609.26333, код выложен на GitHub, чекпойнты Qwen3.8 NVFP4 prefillers доступны на HuggingFace Hub

в 2 разаускорение и снижение стоимости инференса
1–3 битаточность весов на decode-этапе

Полный разбор →

Уволенные разработчики создали OpenExecutive для имитации работы топ-менеджеров

3@ru3dnewsмедиа / агрегатор
4 нед
Уволенные разработчики создали OpenExecutive для имитации работы топ-менеджеров

Гайд по настройке графики в ремастере «Ведьмака 3»

D@dtfbestгеймдев
4 нед
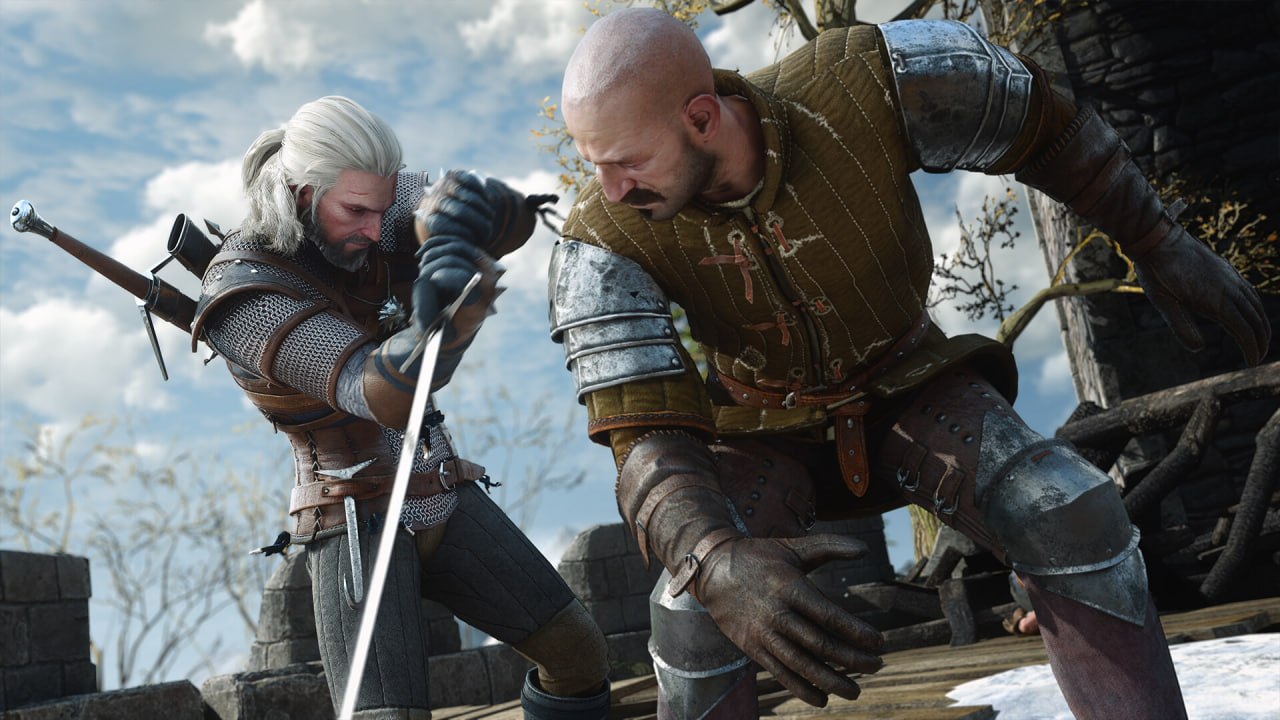
Пользователь DTF опубликовал гайд по настройкам графики в ремастере «Ведьмака 3». Он объяснил, как определённые опции влияют на производительность, и подобрал оптимальные варианты. https://dtf.ru/howto/5324978
Гайд по настройке графики в ремастере «Ведьмака 3»

Оптимизация прямых затрат в бизнесе

Ф@Founder_Startupмедиа / агрегатор
4 нед
Оптимизация прямых затрат в бизнесе
Ещё ↓