Meta представила Context Language Models: модели с полным контролем над контекстом
D@data_secretsAI-инженер
3 недИсследователи Meta предложили подход CLM, позволяющий LLM самостоятельно редактировать свою историю через Bash, оптимизируя контекст и вычислительные затраты.
Новый метод позволяет ИИ-агентам работать дольше и эффективнее, самостоятельно «забывая» лишнее.
- Модели учатся сами структурировать свою память, что делает их работу более автономной.
- Метод позволяет значительно экономить вычислительные ресурсы при решении длинных задач.
- Технология применима к существующим LLM без необходимости менять их архитектуру.
Исследователи из Meta* предложили дать моделям полный контроль над собственным контекстом
Обычно контекст агента устроен довольно просто: старый контекст + новый ответ -> новый контекст. История постепенно растет, а когда становится слишком большой, ее приходится отдельно сжимать или чистить.
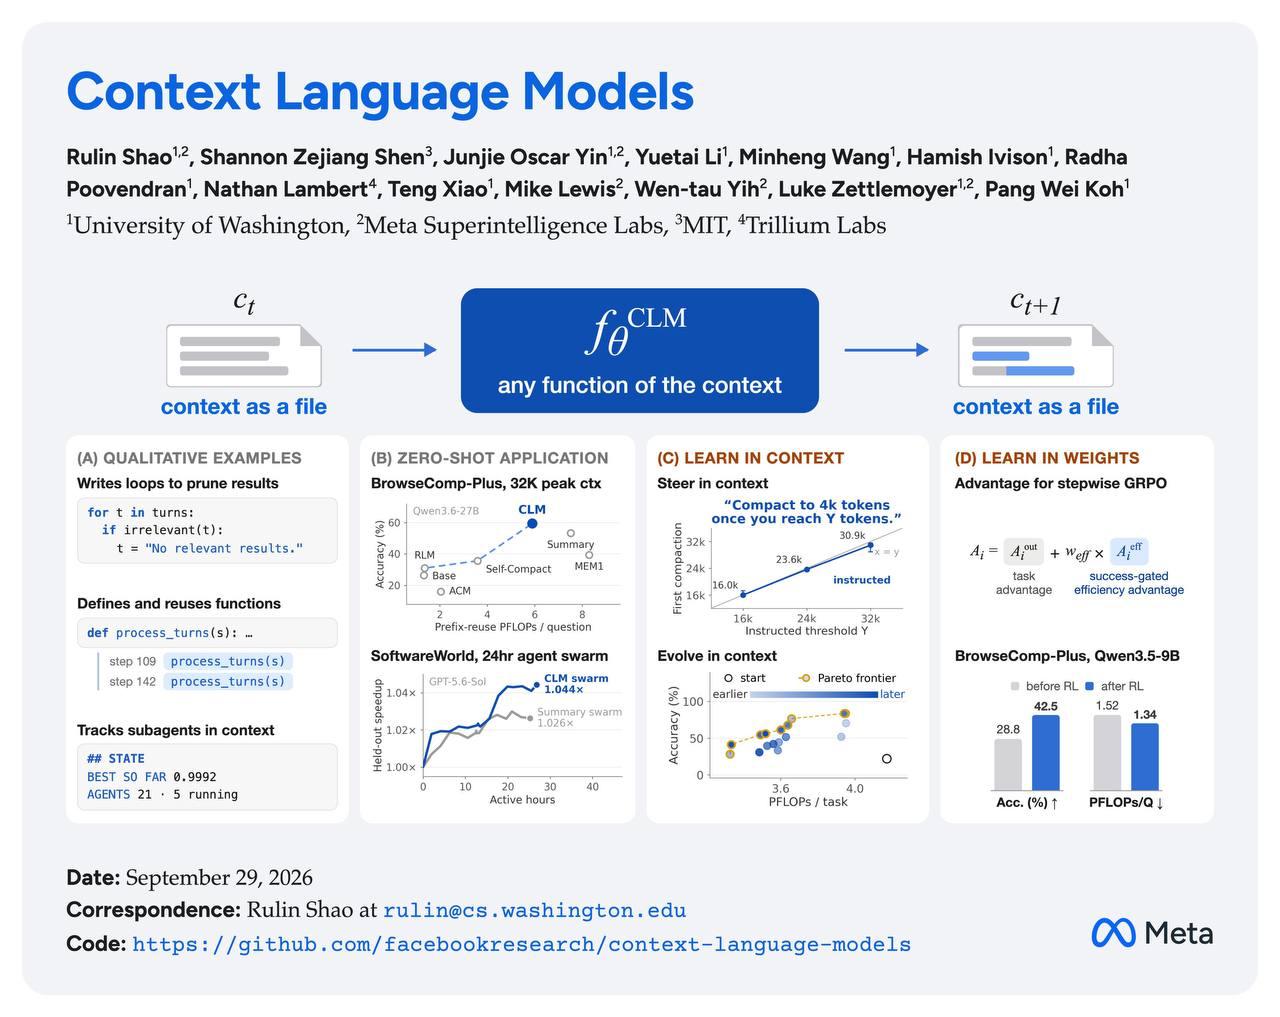
В Context Language Models (CLM) авторы предлагают вообще убрать заранее заданную логику управления контекстом и дать модели возможность самой переписывать собственную историю.
Технически весь текущий контекст хранится в обычном файле, к которому у модели есть доступ через Bash. Она может в любой момент удалить ненужные сообщения, заменить большой кусок истории короткой заметкой, сохранить важный результат дословно или полностью перестроить содержимое. После каждого изменения файл становится новым контекстом модели.
При этом никаких правил о том, как именно управлять историей, модели не дают. В экспериментах агенты сами начинали заводить внутри контекста пометки, писать функции для удаления старых результатов поиска и собирать компактные таблицы с состоянием других агентов. Например, в одном из тестов модель за 163 редактирования удерживала рабочий контекст в пределах 6–8K токенов.
Авторы пошли дальше и попробовали отдельно обучить модель этому навыку через RL. После обучения Qwen3.5-9B на BrowseComp-Plus выросла с 28.8% до 42.5%, при этом на вычисления ушло на 38.8% меньше, чем у обученного тем же способом бейзлайна с обычной суммаризацией.
Произвольное редактирование контекста, правда, ломает обычное кеширование. Если изменить что-то в середине истории, все состояния после этого места формально приходится считать заново. Для этого авторы сделали Suffix Cache Reuse: для неизменившихся частей контекста продолжают использовать старый KV-cache, даже если текст перед ними поменялся. В экспериментах это сократило серверные вычисления еще примерно на 35% без заметной потери качества.
На длинных задачах разница становится уже довольно большой. На 12-часовом EdgeBench CLM получил на 5% больше баллов при сокращении объема вычислений на 59%. В 24-часовом тесте на оптимизацию кода CLM при том же вычислительном бюджете показал на 65% лучший результат, чем бейзлайн.
И все это работает поверх обычных LLM, без изменения архитектуры самой модели.
Код | Статья
Кратко (AI)
Исследователи Meta предложили концепцию Context Language Models (CLM), в которой модель сама управляет своей историей через Bash-команды, удаляя или сжимая данные. Это позволяет эффективно поддерживать контекст в заданных рамках и повышает производительность моделей, таких как Qwen3.5-9B, при значительном снижении вычислительных затрат.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖