Disaggregated Quantization: оптимизация префилла и декода LLM
К@quant_prune_distillAI-инженер
4 недИсследователи из IST и NVIDIA представили метод Disaggregated Quantization для раздельной оптимизации стадий префилла и декода в LLM.
Новый метод позволяет ускорить работу нейросетей за счет раздельной оптимизации разных этапов генерации текста.
- Префилл и декод требуют разных вычислительных ресурсов, что делает стандартное квантование неэффективным.
- Раздельное сжатие позволяет повысить скорость генерации без существенной потери качества.
- Метод помогает эффективнее использовать аппаратные ресурсы при работе с большими языковыми моделями.
🧩 Disaggregated Quantization: Specializing LLM Prefill and Decode
📄 Статья
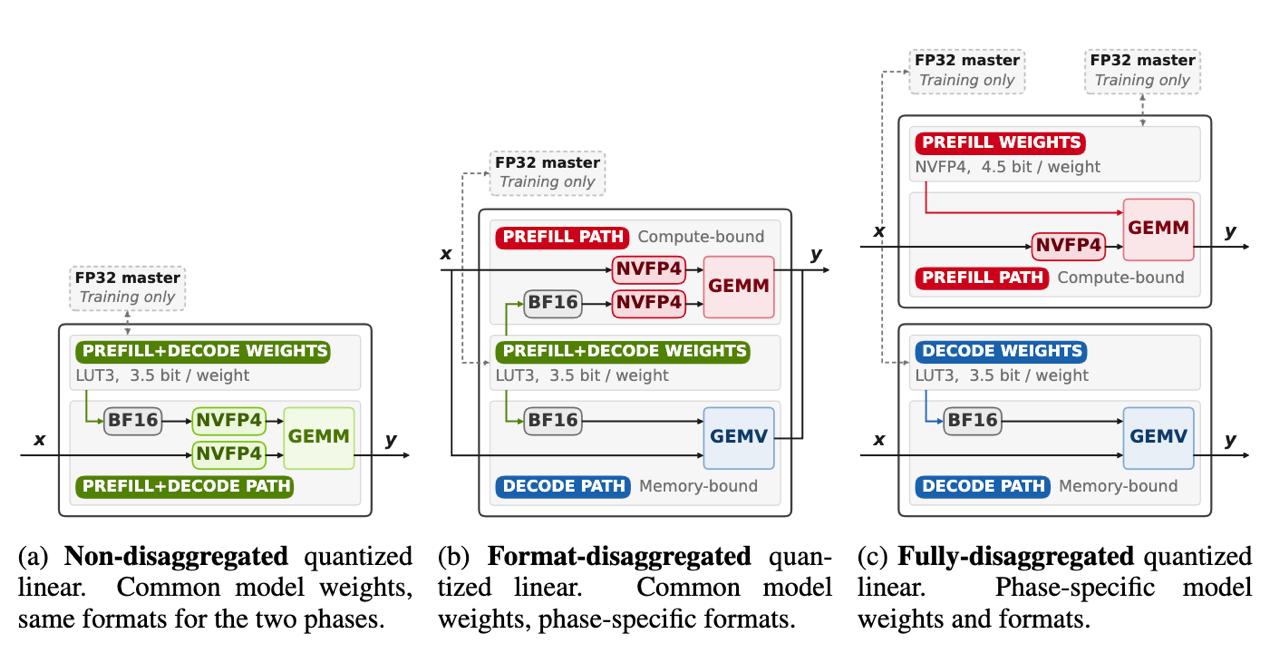
Обычно для префилла и декода используется одна и та же модель, более того — одни и те же веса.
Однако с вычислительной точки зрения эти операции сильно различаются:
- 🧮 На префилле много вычислений, поэтому обычно упираемся в скорость матричных операций.
- 💾 На декоде же упираемся в скорость памяти.
Поэтому кажется логичным оптимизировать каждый из этапов по-своему.
И потому команда из IST и NVIDIA с первым авторством @black_samorez предлагает подход, оптимизирующий качество и скорость за счёт разного сжатия на этих двух стадиях.
Кратко (AI)
Команда исследователей из IST и NVIDIA представила метод Disaggregated Quantization, который предполагает использование разных стратегий сжатия для стадий префилла и декода в LLM. Авторы отмечают, что эти этапы имеют разные вычислительные ограничения: префилл ограничен скоростью матричных вычислений, а декод — пропускной способностью памяти.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖