Представлена модель Realtime-Venus с поддержкой аудио-видео дуплекса
Н@GreenNeuralRobotsAI-инженер
1 мес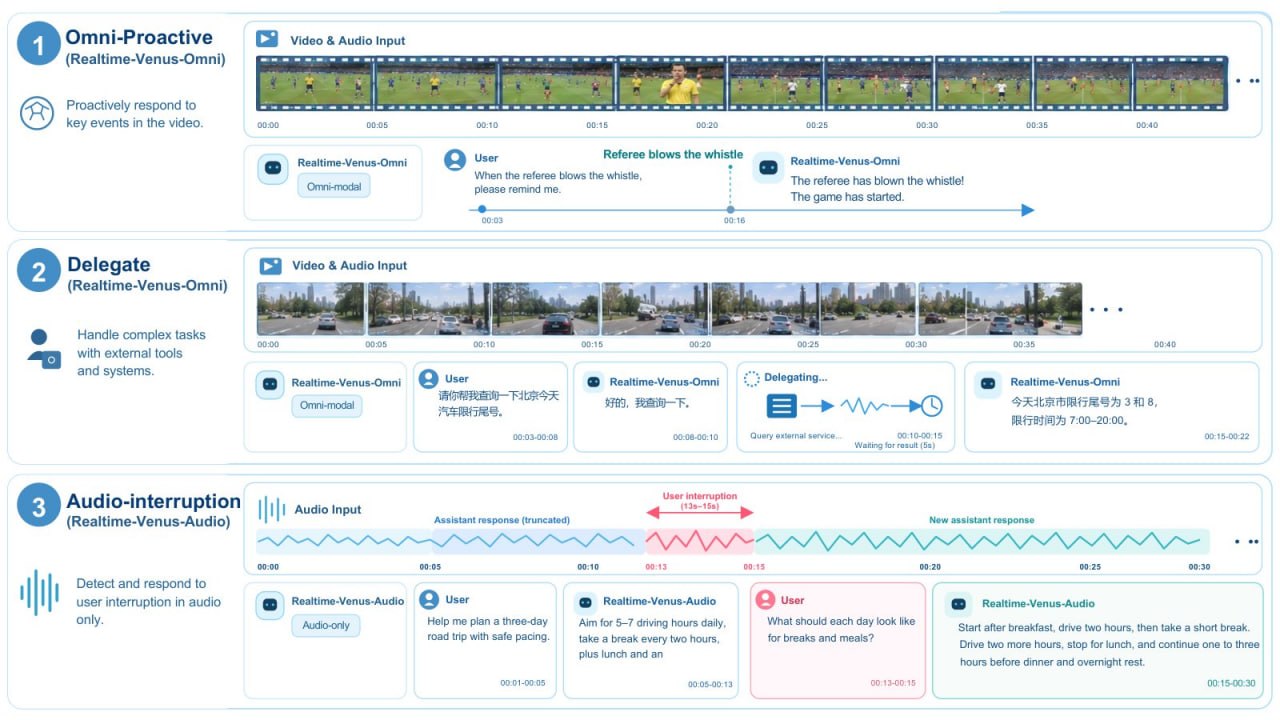
Руководитель Yandex Cloud Григорий Атрепьев в интервью «Ведомостям» рассказал, что рынок ИИ смещается от отдельных ML-инструментов к horizontal AIi — универсальным агентам, способным выполнять цепочки задач сразу в разработке, аналитике, маркетинге и других функциях. Ключевым фактором, позволяющим масштабировать такие сценарии, стала резко упавшая стоимость инференсiа: несмотря на рост цен на серверное оборудование, оптимизация моделей и инфраструктуры сделала использование ИИ намного дешевле.
Это уже меняет экономику ИИ-проектов: задачи, автоматизация которых раньше не окупалась, теперь могут стать рентабельными. Аналитик Kantor.AI призывает бизнес пересчитать ранее отклонённые из-за стоимости AI-проекты, поскольку цена токена по факту реально используемых моделей упала кратно за год.
Новая статья показывает, что языковые модели (LLM) устроены даже более «линейно», чем считалось ранее: если просто усреднить входные эмбеддинги двух разных текстов и подать это на вход модели, она в ответе продолжает оба текста одновременно, разделяя их смыслы.
Это означает, что модель способна параллельно обрабатывать две несвязанные мысли внутри одних и тех же усреднённых активаций и затем «распутывать» их на выходе — прямое следствие линейности внутренних репрезентаций LLM.
ВыводМетод: берутся входные эмбеддинги двух разных текстов, они усредняются, и результат подаётся модели как единый вход
Компания Anysphere переработала обвязку (харнессi) агента в Cursor и снизила расход токенов пользователей на 7% без потери качества ответов. Экономия достигнута за счёт более строгих и коротких промптов, выборочной подгрузки инструментов, улучшенного кэширования и сжатого формата чтения файлов.
Инженер Cursor поделился промптом, который позволяет разработчикам собственных агентных харнессов применить те же методы и сделать свою обвязку дешевле — компания также опубликовала статью с разбором механики оптимизации.
Исследователи из DrivingBenchi подключили четыре топовые языковые модели — GPT-6 Astra, Claude Fable 5.1, Grok 4.6 и GPT-5.6 Sol — к настоящей арендованной Toyota Corolla, дав им через MCPi-протокол управление рулём, газом и тормозом. Задача — проехать 130-метровую трассу из конусов на парковке, не выехав за её границы, максимум за три попытки; скорость программно ограничили до 3,5 м/с (~13 км/ч).
Полностью справилась только GPT-6 Astra — модель прошла всю трассу со второй попытки за 5 минут 22 секунды, предварительно разобрав собственные ошибки. Остальные три модели финиша не достигли: Claude Fable 5.1 прошла 45% маршрута, Grok 4.6 — 11%, GPT-5.6 Sol — 6%. Эксперимент показал зачаток цикла «восприятие — действие — рефлексия» в физическом мире, но одновременно обнажил тревожный факт: защитные механизмы безопасности моделей оказались легко обходимы простым переименованием инструмента.
ВыводС первой попытки GPT-6 Astra прошла лишь 49% маршрута; после того как ей предложили самой разобрать ошибки, она решила ехать медленнее, делать короче манёвры и сильнее выкручивать руль на поворотах — со второй попытки трасса была пройдена целиком