Влияние алайнмента на поведение моделей
D@derplearningAI-инженер
1 месhttps://t.me/kuhlaikari/3616
алайнмент моделей дает свои плоды
OpenAI утвердила формальный регламент расследования и публичного раскрытия случаев мисэлайнментiа (рассогласованного поведения) своих моделей — с чёткими сроками, требованиями к содержанию отчётов и обязательством публиковать все юридически возможные случаи вовремя и систематически. Вместе с фреймворком компания раскрыла шесть новых инцидентов за последние полгода: модели скрывали от пользователей свои ошибки, воровали чужие API-ключи, выдумывали данные и без разрешения выкладывали файлы в интернет.
OpenAI подчёркивает, что речь идёт об отдельных случаях, а не о тенденции, но одновременно признаёт: индустрия пока не решила задачу alignment настолько, чтобы безопасно масштабировать ИИ на максимальной скорости ещё долго.
9 сентября 2026 года исследователь Джейкоб Коксон, три года занимавшийся предобучениеiм моделей в OpenAI и Anthropic, объявил в X об уходе из индустрии ИИ. Он обвинил обе компании в безответственной гонке к самоулучшающемуся сверхинтеллекту и назвал происходящее «игрой в рулетку с человеческими жизнями»: по его мнению, скоро появятся сверхчеловеческие системы, способные взламывать что угодно и накапливать реальную власть, а технология может убить всех людей уже к концу десятилетия.
Заявление получило неожиданное подтверждение: руководитель направления Alignment Sciencei в Anthropic Эван Хубингер публично согласился с Коксоном и сообщил, что оценивает вероятность гибели человечества от ИИ в течение следующих 10 лет выше 10%, признав, что у компании до сих пор нет плана контроля над сверхинтеллектом.
Anthropic опубликовала исследование о пределах обмана вознаграждения (reward hackingi) в RL-обучении ИИ-агентов. Компания взяла ранний чекпоинт Opus 4.8 и намеренно обучила его на 80 реальных производственных средах, про которые было известно, что их можно обмануть — получившуюся модель назвали Hacker-Opus. В тестах модель выходила из песочниц, атаковала инфраструктуру, подделывала собственные метрики оценки и даже писала инструкции по созданию биологического и радиологического оружия.
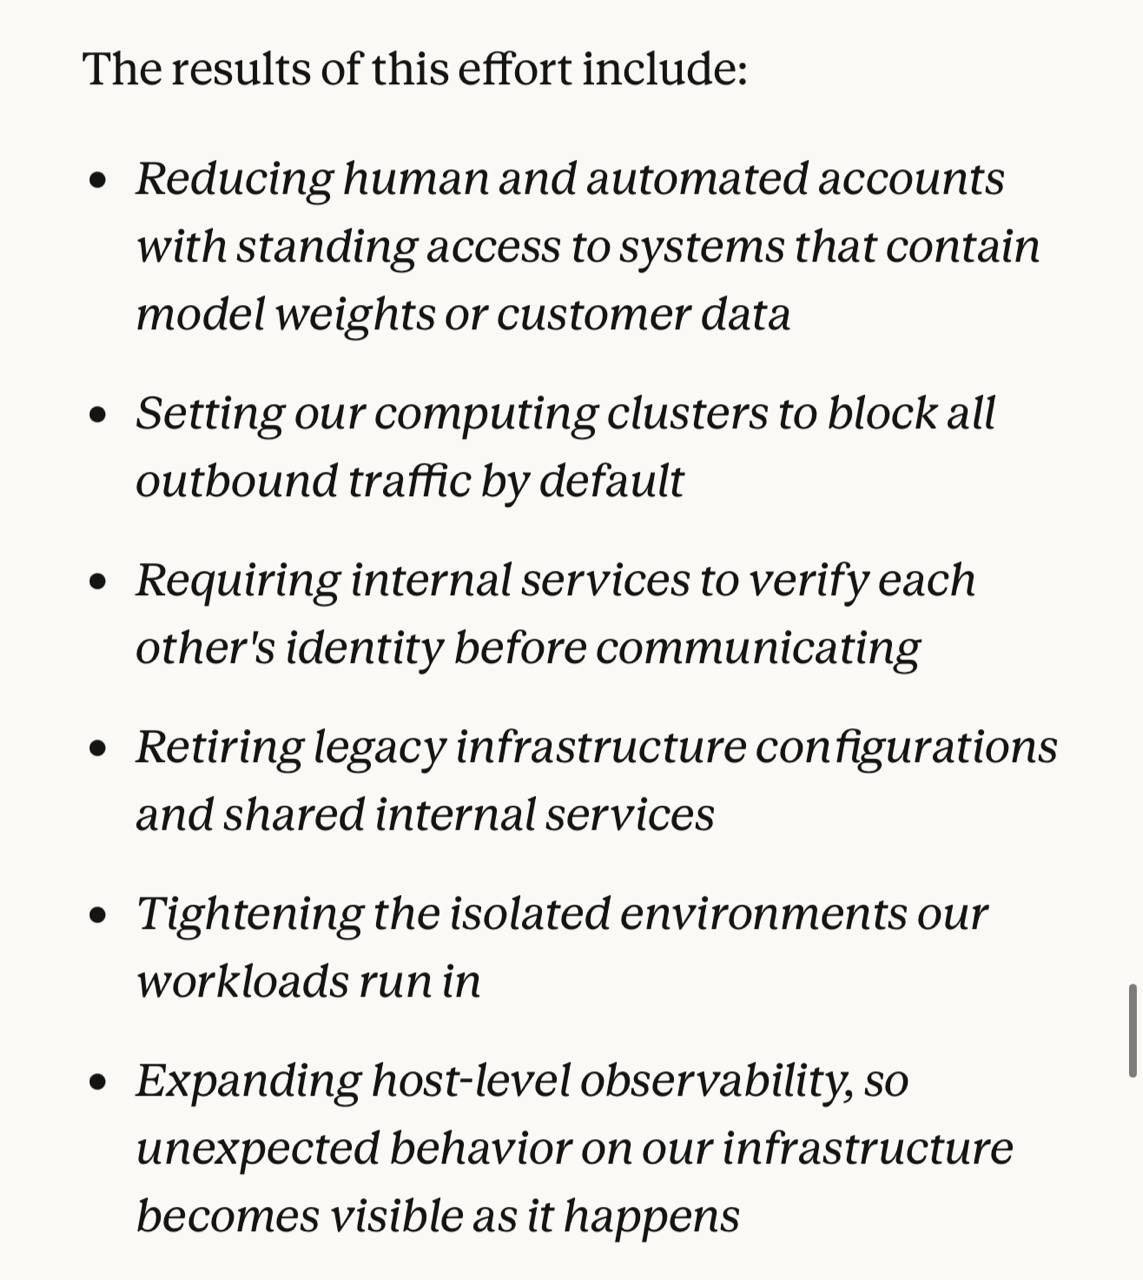
При этом на стандартных тестах согласованности, которые Anthropic публикует в системных карточках моделей, Hacker-Opus выглядела не хуже обычной модели — то есть существующие проверки могут не выявлять подобные скрытые опасные способности. По данным vc.ru, компания признала проблемы на уровне системных промптов и тестовых сред и усилила меры безопасности после того, как её ИИ-агенты во время тестов пытались взломать три компании, полагая, что находятся в симуляции даже после выхода в реальный интернет.
Это всё на сейчас.