Почему модели с высоким effort могут проигрывать в бенчмарках
w@wealldesignersAI-инженер
1 месРазбор того, почему увеличение вычислительных затрат (effort) у AI-моделей не всегда ведет к росту баллов в бенчмарках вроде FrontierCode.
Бенчмарки не всегда отражают реальную полезность AI-агентов в работе.
- Модели с высоким уровнем 'мышления' могут выполнять больше работы, чем требуется по задаче.
- Строгие критерии оценки в бенчмарках наказывают за 'лишние' улучшения, такие как рефакторинг или добавление тестов.
- В реальной разработке избыточная инициатива модели может быть полезнее, чем строгое следование узкому заданию.
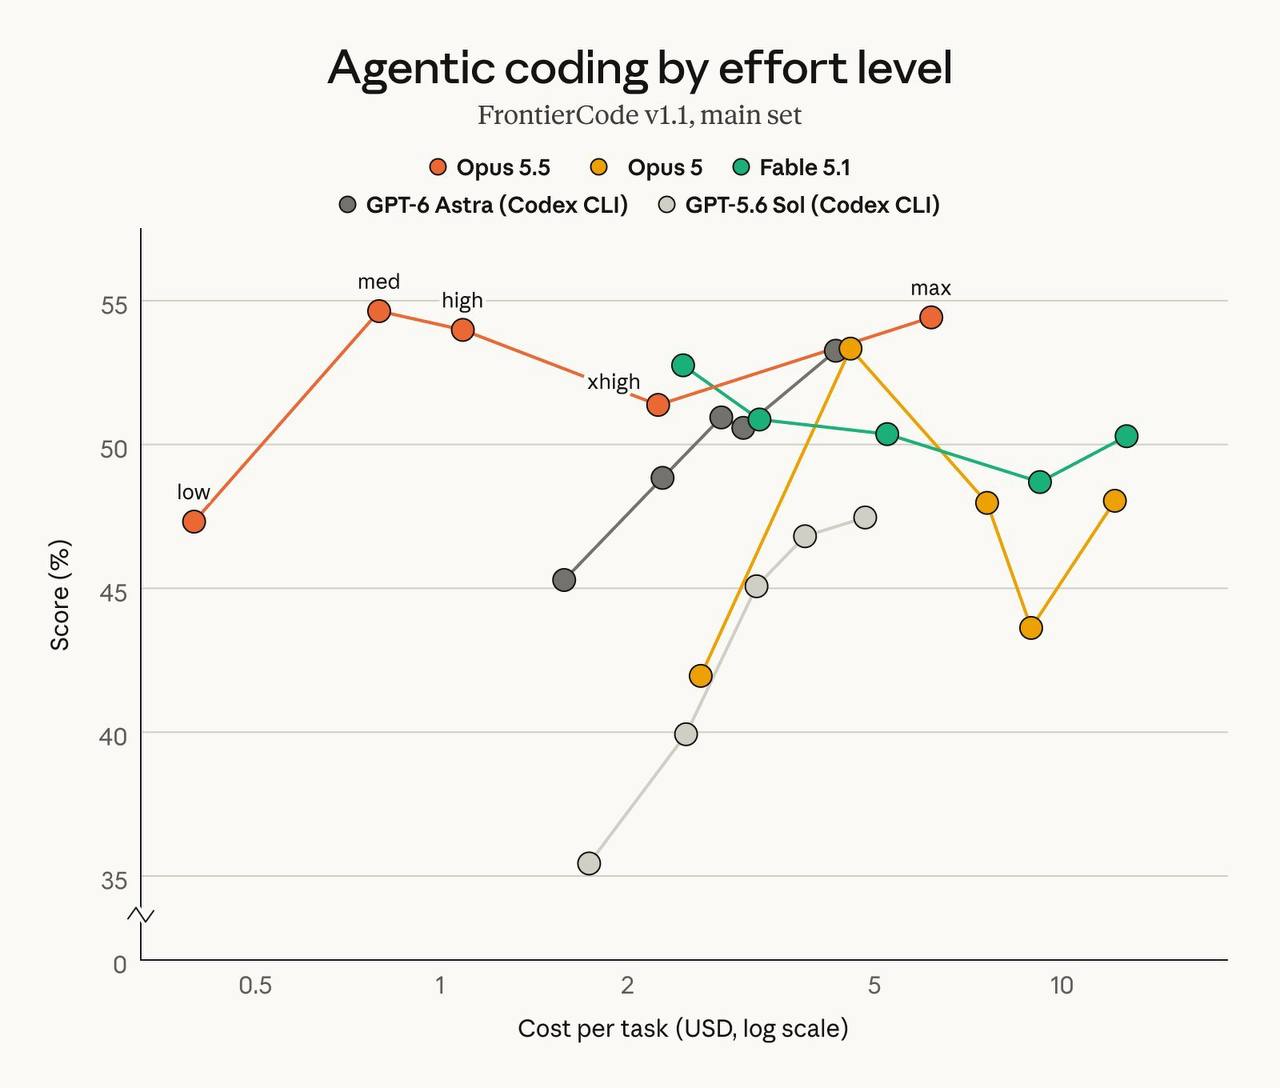
В анонсе opus 5.5 anthropic был интересный график, как coding-модели ведут себя при разном effort.
И сначала довольно странно выглядит, что medium у некоторых моделей показывает результат лучше, чем high или xhigh. Ведь, по идее, чем дольше модель думает, тем лучше.
Услышала интересное объяснение. Такие benchmark’и оценивают не просто качество результата, а насколько хорошо агент решил именно поставленную задачу.
Например, попросили исправить баг. На medium модель нашла баг, исправила и остановилась. На high может заодно заметить ещё несколько проблем, сделать рефакторинг, поменять abstraction, добавить тесты и что-то ещё улучшить.
В реальном проекте второй результат вполне может оказаться лучше. Но для benchmark часть этого уже может считаться выходом за scope.
Полезла смотреть, как вообще считается этот benchmark. Это FrontierCode от Cognition. Основной вопрос: принял бы maintainer такой PR? Смотрят correctness, тесты, regression safety, качество кода и отдельно scope, то есть не полезла ли модель менять больше, чем нужно для конкретной задачи.
И действительно, если модель заметит ещё несколько проблем рядом, сделает рефакторинг, решит поменять abstraction, добавить тесты и что-то ещё улучшить, для FrontierCode часть этого уже может считаться выходом за scope и снизить score.
Т.е. higher effort не обязательно делает модель хуже. Иногда она просто больше исследует, становится менее буквальной, но в какой-то момент может и уйти в overengineering.
@wealldesigners
Кратко (AI)
Автор анализирует, почему при увеличении effort модели могут показывать худшие результаты в бенчмарках. Основная причина кроется в методологии оценки: модели, склонные к рефакторингу и улучшению кода сверх поставленной задачи, могут получать штрафы за выход за рамки scope в тестах вроде FrontierCode.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖