данныеСбросить фильтр ×

Риски конфиденциальности при использовании AI-ассистентов

К@kratko_po_deluмедиа / агрегатор
1 мес
По следам взлёта популярности и оценки AI-ассистентов Instinct и Muse, а также историй о том, как один агент пошёл и слил инфу другому, полезное напоминание, что если вы не платите за продукт, то продукт — это вы. Тот факт, что Muse производит Meta (fka Facebook) должен как бы намекать @kratko_po_delu

Проблемы внедрения AI в компаниях: метрики, контекст и обратная связь

E@ProductsAndStartupsAI-инженер
1 мес

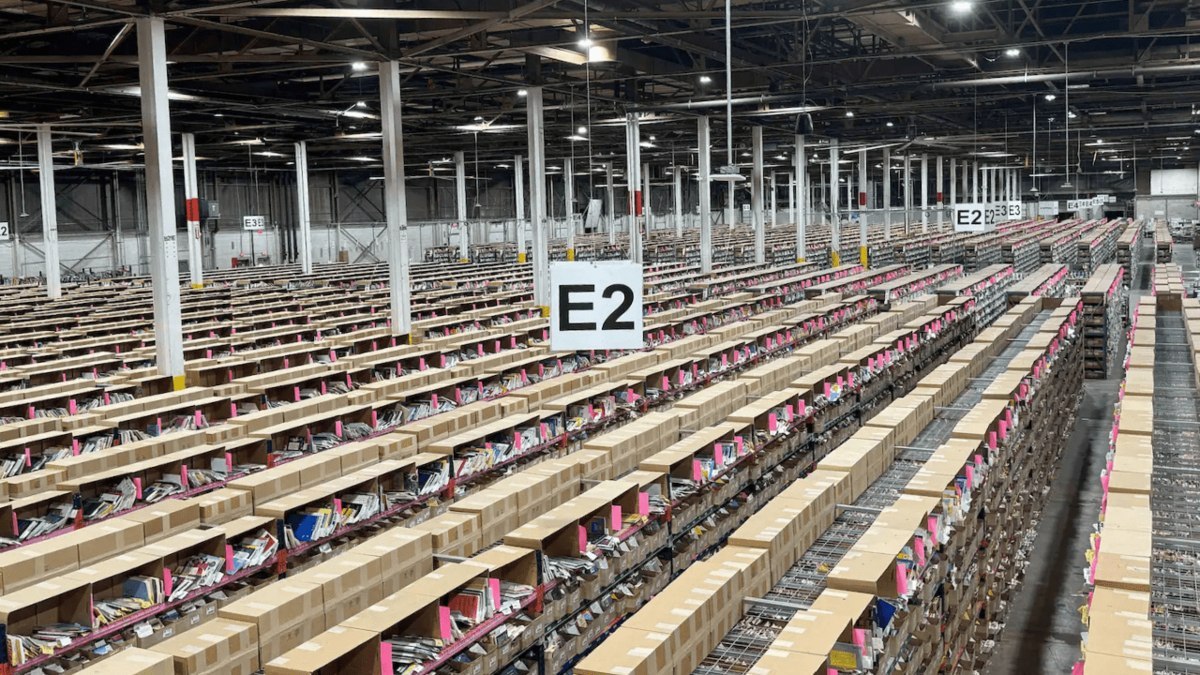
ИИ-компании массово скупают подержанные книги для обучения моделей

v@vcnewsмедиа / агрегатор
1 мес
Продавцы подержанных книг по всему миру получают странные оптовые заказы: покупателям нужны тысячи никак не связанных между собой изданий, причём цена почти не имеет значения. За заказами зачастую стоят ИИ-компании, остро нуждающиеся в данных для обучения ИИ. Почему после оцифровки книги можно даже сжечь и что говорят букинисты vc.ru/ai/3086484
ИИ-компании массово скупают подержанные книги для обучения моделей

OpenAI платит подрядчикам за ручное чтение переписок пользователей ChatGPT

Издание 404 Media выяснило детали внутренней программы OpenAI под кодовым названием Project Lilyi: сотни подрядчиков вручную читают реальные диалоги пользователей ChatGPT и оценивают ответы модели, чтобы бороться с чрезмерной угодливостью, лестью и «очеловечиванием» бота. Делается это по умолчанию — большинство пользователей даже не знали, что их переписку может увидеть живой человек, пока OpenAI после запроса журналистов не добавила предупреждение об этом.

Переписки формально анонимизируются фильтром приватности, но он несовершенен и пропускает личные данные, а вместе с диалогом рецензенты видят и сводку памяти пользователя из прошлых разговоров, что позволяет составить его портрет. Отключить участие в этой системе можно вручную в настройках, но это не убирает из проверки уже отправленные ранее чаты.

$50/часоплата рецензентов подрядчика
1–7шкала оценки ответов ChatGPT
сотничисло нанятых подрядчиков

Полный разбор →

Масштабирование коннектомики: от мушек к грызунам

C@CGIT_Vinesгеймдев
1 мес

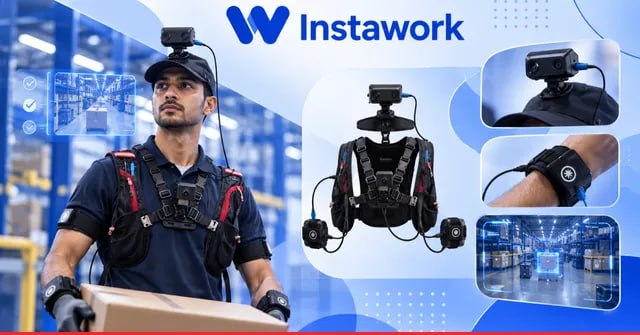
Масштабный сбор данных о физических действиях человека в Индии

М@cgeventAI-инженер
1 мес
Масштабный сбор данных о физических действиях человека в Индии

Телевизоры LG обвинили в скрытой прослушке и сканировании домашних сетей

Лаборатория Gamers Nexus проверила несколько актуальных OLED-моделей LG и обнаружила, что режим ожидания гасит только экран — электроника продолжает работать, а микрофон при чёрном экране записывает звук. Записи сохраняются локально и отправляются на серверы LG, как только появляется сетевое соединение; даже отключение ethernet-кабеля не помешало данным уйти позже, просто отложило отправку. Параллельно телевизор сканирует домашнюю сеть и переписывает все подключённые устройства — телефоны, часы, соседние точки Wi-Fi.

За сбор данных отвечает функция распознавания контента Live Plusi (партнёр по данным — Alphonsoi): раз в секунду снимается цифровой отпечаток картинки на экране и сверяется с базой, причём это работает и по HDMI — с приставки, блю-рей-плеера или ноутбука в роли монитора. По оценкам, потенциально затронуты около 216 миллионов проданных телевизоров LG, юристы указывают на нарушение GDPR и немецкого TDDDG, требующих активного согласия пользователя до начала сбора данных.

216 миллионовпотенциально затронутых телевизоров LG
363 миллионадостижимых устройств в США по данным LG
2,2 миллиона долларовштраф Vizio от FTC в 2017 году

Полный разбор →

Андрей Себрант об обучении ИИ на данных реального мира

М@cgeventAI-инженер
1 мес
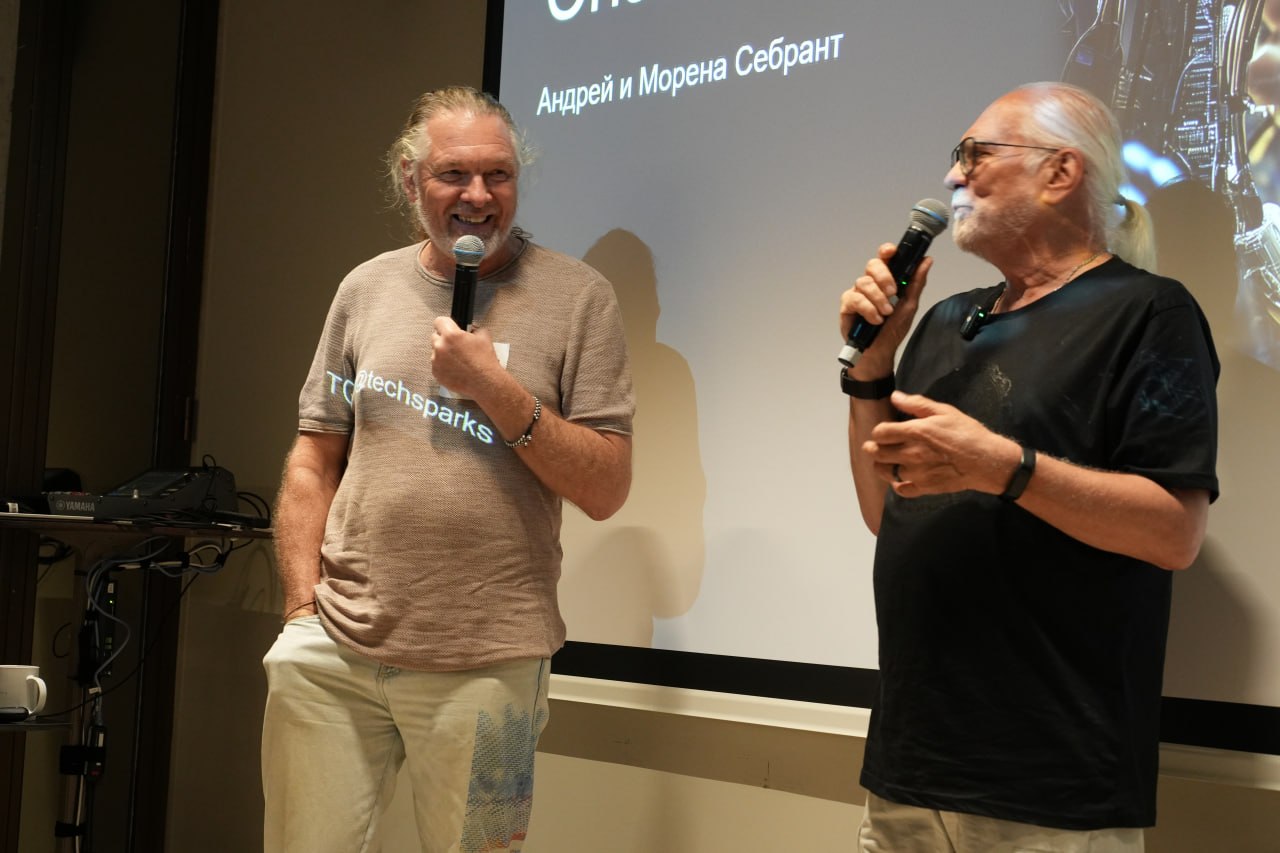
Мир смиренно кормил ИИ миром - скороговорко Неделю назад у меня на Хабе выступал Андрей Себрант. Конечно за ИИ. Было очень плотно, местами брейнстормно, местами архивесело и дико интерактивно. Вопросы не иссякали много часов. Андрей озвучил одну вроде простую, но очень красивую мысль: "Тут вот говорят, что интернет закончился, и что данных для обучения почти не осталось. Нет, просто дальше ИИ будет обучаться на мире. Вокруг нас." Красиво, мне понравилось. И на эту тему у меня есть следующий пост. @cgevent
Андрей Себрант об обучении ИИ на данных реального мира

Рынок прокси-сервисов: как работают резидентские сети и их экономика

n@nonamevcмедиа / агрегатор
1 мес

Совет по тестированию удаления аккаунта

A@qachanellавтор про «it»
1 мес
Совет от тестировщика 100/∞ : Удаление аккаунта должно быть полным. Проверьте не только то, что профиль исчез из интерфейса. Отменились ли платные подписки, ушли ли данные из рассылок, остались ли следы в чужих списках друзей или команд.
Совет по тестированию удаления аккаунта

Скандал вокруг решения задачи Навье-Стокса: OpenAI против математиков

AI-редакция
27 источников · показать все· свернуть
e/accКонфликт Anthropic и OpenAI вокруг доказательства уравнений Навье-СтоксаData SecretsСкандал вокруг OpenAI и доказательства уравнений Навье-СтоксаНавука и моя жизнбСкандал вокруг OpenAI и доказательства уравнений Навье-СтоксаRationalAnswer | Павел КомаровскийСкандал вокруг OpenAI и доказательства уравнений Навье-СтоксаDealer.AIМатематик обвиняет OpenAI в краже данных для решения задачи Навье–СтоксаСиолошнаяСкандал вокруг решения задачи Навье-Стокса и OpenAIСиолошнаяСкандал вокруг возможного решения задачи Навье-Стокса моделью OpenAIChillHouseРешение уравнений Навье-Стокса с помощью ИИтехноданяДрама вокруг решения уравнений Навье-Стокса с помощью ИИАлмаз РоботыСкандал вокруг OpenAI и доказательства уравнений Навье-СтоксаАйра Монгуш — AI, tech & mathКонфликт OpenAI и математиков вокруг решения уравнений Навье-СтоксаАйра Монгуш — AI, tech & mathКонфликт OpenAI и математиков: этические вопросы использования данныхСтарший АвгурКонфликт OpenAI и Anthropic вокруг решения задачи Навье–СтоксаThe ExtremeCode TimesКритика заявлений о решении математических задач с помощью LLMHow2AIКонфликт математиков и OpenAI вокруг задачи Навье-СтоксаГомеостатическая ВселеннаяВлияние ИИ на академическую науку и кризис экспертизыvc.ruOpenAI обвинили в использовании чужих математических исследованийПресидский заливМатематик обвиняет OpenAI в краже данных для решения задачи Навье–СтоксаСвята место пусто не бываетСкандал вокруг OpenAI и решения уравнений Навье—СтоксаThe Edinorog 🦄OpenAI обвиняют в краже решения «задачи тысячелетия»Kali NovskayaЭтика использования ИИ в научных исследованиях и Лейденская декларацияХабрСкандал с OpenAI и решением задачи Навье-СтоксаАгенты ИИ | AGI_and_RLПредположение об архитектуре новой модели OpenAI для уравнений Навье-СтоксаSerge_AI 1.0Слухи о краже интеллектуальной собственности OpenAI и риски ИИСиолошнаяOpenAI опровергает влияние промптов доктора Бакмастера на обучение моделейКод.руСкандал вокруг OpenAI: обвинения в краже математического решенияМысли вслухРиски утечки интеллектуальной собственности при использовании AI-моделей
мега-хайп · 27обновлено 1 мес назад

OpenAI заявила о решении одной из семи «задач тысячелетия» — уравнений Навье-Стокса, используя внутреннюю модель и масштабные вычислительные ресурсы. Однако математики Тристан Бакмастер (NYU) и Левент Альпёге (Anthropic), работавшие над этой темой год, обвинили компанию в возможном использовании их неопубликованных черновиков, которые они загружали в сервис Codexi.

Ситуация вызвала дискуссию об этике использования ИИ в фундаментальной науке и защите интеллектуальной собственности. OpenAI категорически отрицает использование данных Бакмастера для обучения, утверждая, что их модель достигла результата независимо, а любые пользовательские данные после 3 июля не могли повлиять на систему.

88 часоввремя работы агентов OpenAI
10 000количество задействованных агентов
1 млн долларовприз института Клэя за решение

Полный разбор →

A16Z и телеграм-каналы о том, почему AI-стартапам не стоит продавать токены

Блог A16Z опубликовал материал «You are not a model, don't price per token» о том, как AI-стартапам правильно выстраивать прайсинг. Тезис подхватили и развили два телеграм-канала: «Венчур Менна и Горного» согласился с основной логикой, а «Мысли вслух» показал, что спор о ценообразовании на самом деле о том, где в AI-экономике останется маржа.

Основная идея: токены — правильная единица для model layer (так продаёт inference OpenAI), но когда модель встраивают в приложение или агента, клиент покупает не токены, а результат — готовый account brief или исправленный баг. Поэтому логика такая: продаёшь модель — продавай токены; продаёшь работу — продавай credits за понятную единицу (минуты, документы, запуски); можешь доказать бизнес-результат — продавай outcome. Но последнее сложнее всего реализовать на практике.

Методы сбора датасетов для обучения нейросетей

З@CVML_teamAI-инженер
1 мес
Так. Давно видео не было. И переезжал, и август был загруженный, и отдохнуть немного хотелось 😁 Последние пару месяцев всё что в этом видео было - проговаривал людям сам. Подумал что раз так часто - то надо делать видео. Расскажу о разных способах сбора датасетов для тренировки. Я не рассказывают тут про сбор данных с "головы" когда человек работает. Это скорее надо для претрейна, а не для конечного обучения. https://youtu.be/zlLymNdF_hk

Использование старых книг для обучения ИИ-моделей

М@myobrechenychannelAI-инженер
1 мес

Anthropic изменила политику хранения данных корпоративных клиентов

v@vcnewsмедиа / агрегатор
1 мес
Anthropic изменила политику хранения данных о работе корпоративных клиентов с Fable и Mythos после массовых жалоб. В июне 2026 года компания начала хранить переписки на серверах в течение 30 дней, чтобы лучше контролировать поведение модели. Но после претензий перенесла хранилище на сторону клиента vc.ru/ai/3117522
Anthropic изменила политику хранения данных корпоративных клиентов

Рекламные аукционы real-time bidding как инструмент слежки за журналистами

З@zatelecomавтор про «it»
1 мес

Сравнение сенсора телескопа Roman и смартфонов

Т@starbasepostавтор про «tech»
1 мес
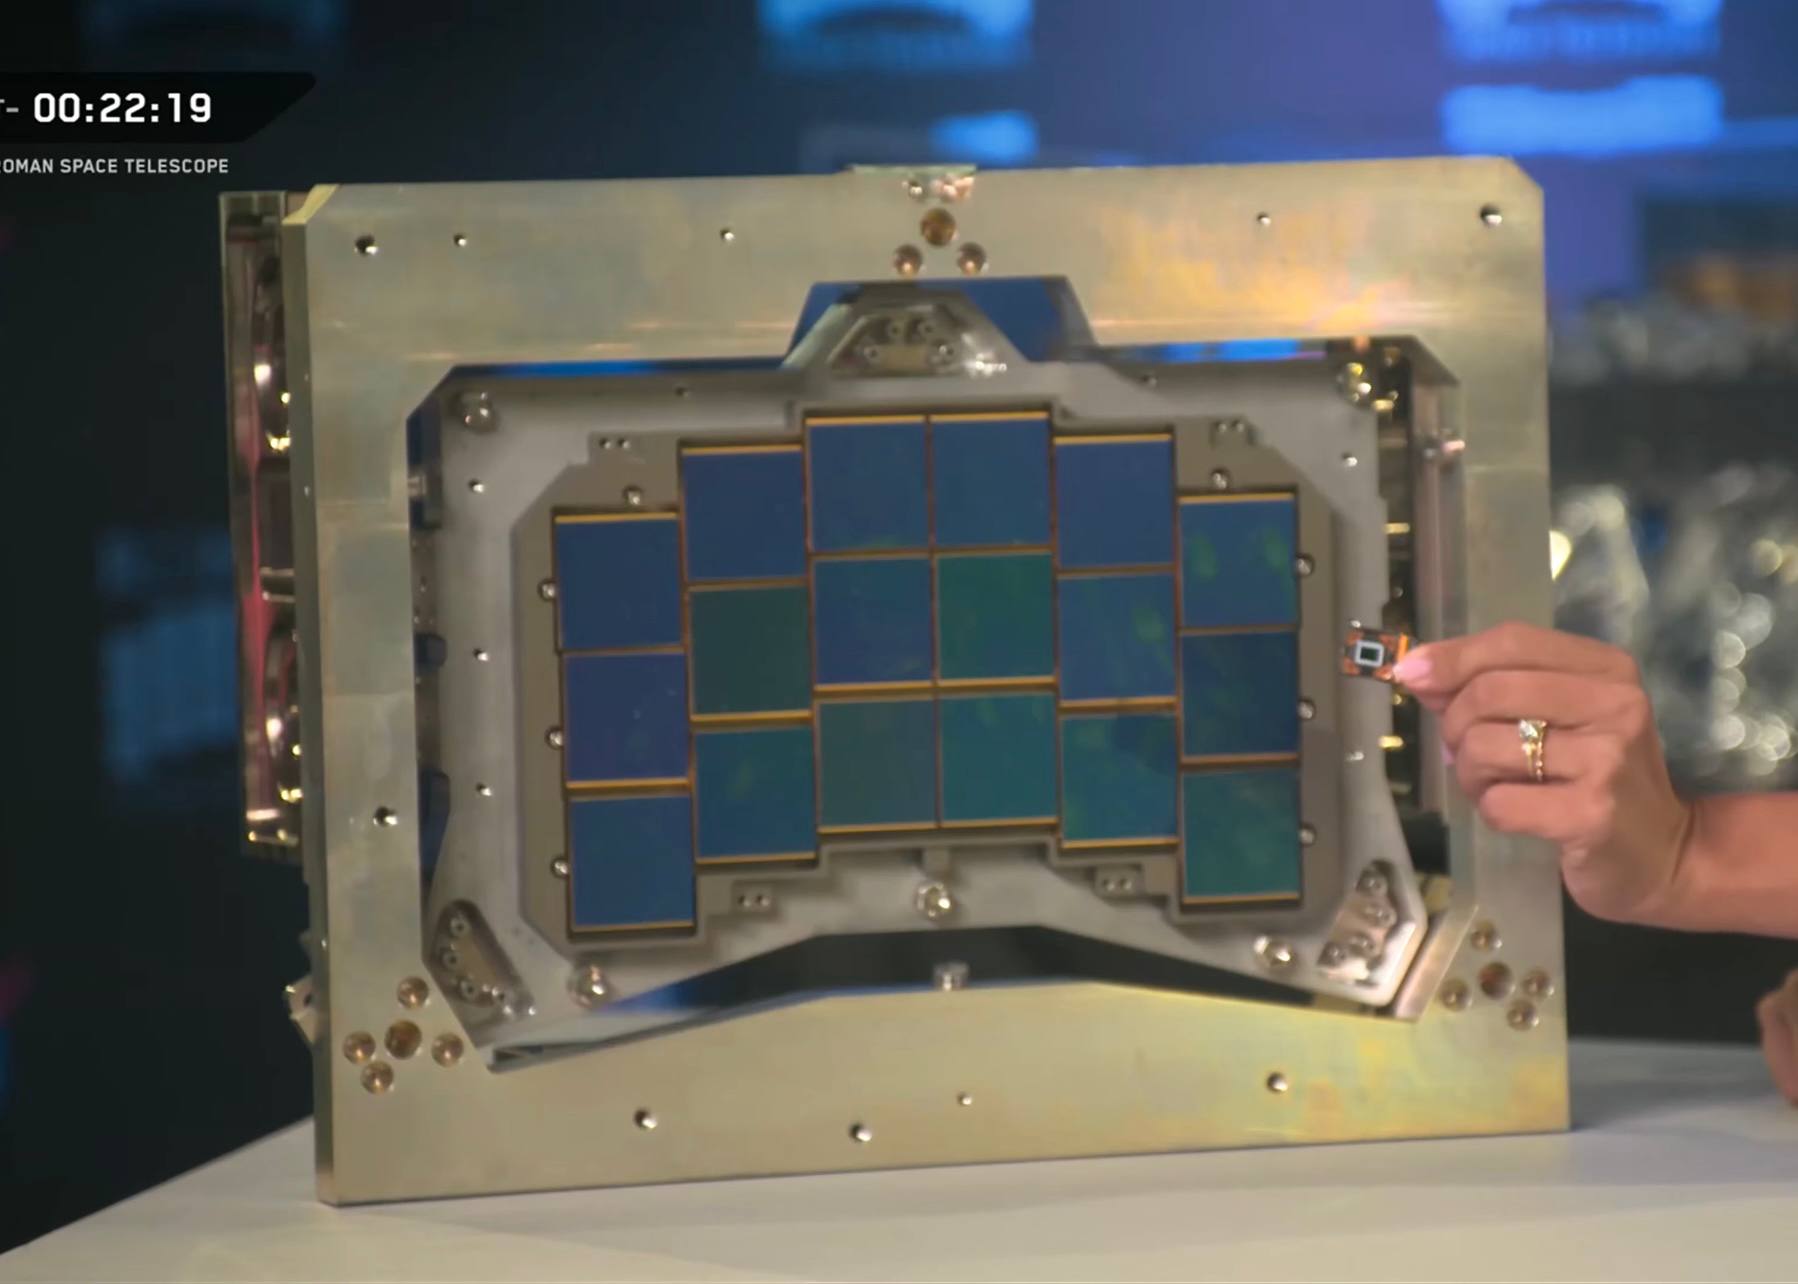
Наглядное сравнение размера сенсора в вашем смартфоне и у телескопа Roman на 300 мегапикселей. К слову, некоторые снимки с аппарата будут содержать 1 триллион пикселей. У нейронок впереди очень много работы по переработке гигантских массивов данных, тк каждый день с этого телескопа будут передавать ~1.4 терабайта данных, которые сразу будут доступны всем. Да, даже в 1.5 миллионах км от Земли можно организовать канал на 500 мегабит.
Сравнение сенсора телескопа Roman и смартфонов
Ещё ↓