aiСбросить фильтр ×

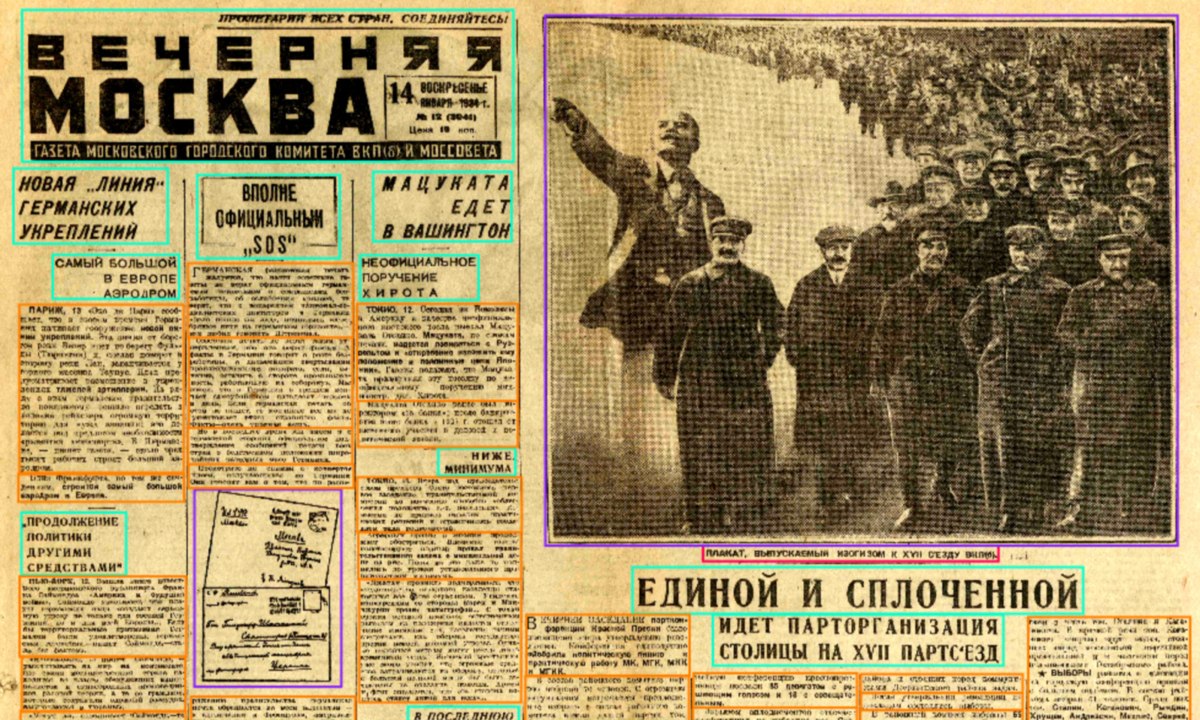
PereStruct: модульный подход к распознаванию структуры газетных страниц

Х@habr_comмедиа / агрегатор
1 мес
PereStruct: модульный подход к распознаванию структуры газетных страниц

Ироничный взгляд на маркетинг и релизы ИИ-моделей

А@undisruptкарьера / HR
1 мес

Ramp AI Index: 80% корпоративной выручки OpenAI и Anthropic дают всего 1% клиентов

Американский b2b-финтех Ramp, анализирующий транзакции 70 тыс. компаний в США, опубликовал данные: 80% корпоративной выручки OpenAI и Anthropic, проходящей через Ramp, генерирует лишь 1% клиентов — в основном техкомпании и AI-стартапы. Это беспрецедентная для tech-индустрии концентрация, которая держится почти два года без признаков снижения.

Значение этих цифр в том, что они обнажают замкнутость AI-экономики: венчурные деньги идут стартапам, стартапы платят за токены OpenAI и Anthropic, те покупают вычисления у Microsoft, Google и Amazon, а облака закупают чипы у Nvidia и Broadcom. Если приток венчурного капитала замедлится или клиенты не получат ожидаемый ROI и начнут переходить на открытые модели (switching costs у них ниже, чем в энтерпрайз-софте), удар пройдёт по всей цепочке сразу, а не по отдельному звену.

80%выручки OpenAI и Anthropic от 1% клиентов
95%выручки от 10% токен-клиентов
$20,9 млрдубыток OpenAI за 2025 год (оценка Зитрона)

Полный разбор →

Alibaba представила Qwen 3.6-35B-A3B для стриминговых аватаров

А@AGI_and_RLAI-инженер
1 мес
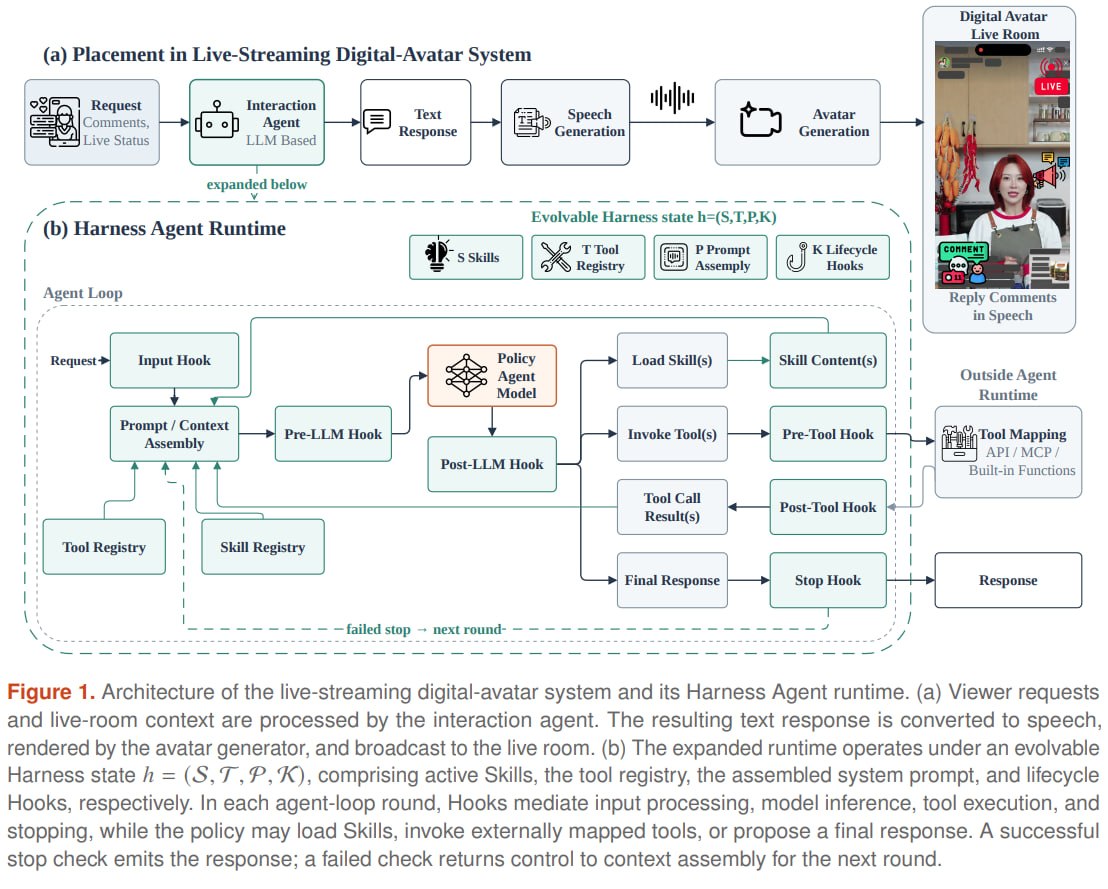
Алибаба потюнили Qwen 3.6-35B-A3B чтобы он лучше обслуживал аватара на стримах нуи в целом схема как там устроено все на скрине, прикольно Training Agents to Evolve with Their Harness: TaoLive Digital Avatar Agent Technical Report https://arxiv.org/abs/2608.15763 https://www.alphaxiv.org/ru/abs/2608.15763
Alibaba представила Qwen 3.6-35B-A3B для стриминговых аватаров

Почему Wispr Flow стоит 2 миллиарда долларов

С@startupofthedayавтор про «startups»
1 мес

Жалобы на «нейрослоп» и задержки обновлений в Claude

f@c3po_notesмедиа / агрегатор
1 мес
Как же надоел нейрослоп клода, сил моих больше нет. особенно вот эти выкрутасы:
Если «го», делаю прямо сейчас, займёт около часа с проверкой.
Какой нафиг час, голова ты кремниевая. Ты же просто баш скрипт запустишь с заменой двух строк текста. Час бы ты даже не проработал, потому что на этот нейрослоп все мои токен лимиты бы сожрал! Надежда вся на новую Астру, потому что по слухам она этим перестала страдать. И да, Сама, я тебе 200 баксов в месяц плачу, чтобы ты мне ролауты новых моделей с задержкой делал? 🔫

Claude Fable 5.1 создал мод для Minecraft по видео

C@campcodeAI-инженер
1 мес
ИИ развивался ради этого: Claude Fable 5.1 за час создал для Minecraft мод с атакой из Наруто 🤩 Разработчик показал модели ролик с атакой Кирин из «Наруто», а Claude всё сделала сама: разобрала видео, написала мод, создала модель молниевого дракона, сделала оружие и текстуры. После первой же рабочей версии Fable 5.1 показали запись результата, и она учла ошибки и поправила дракона, добавила деталей и огонь. Всё заняло около часа и $20 на API. Исходники мода автор выложил на GitHub — осваиваем дзюцу 💪

Стартап Somnia ищет актеров для обучения секс-роботов

Д@disruptors_officialмедиа / агрегатор
1 мес
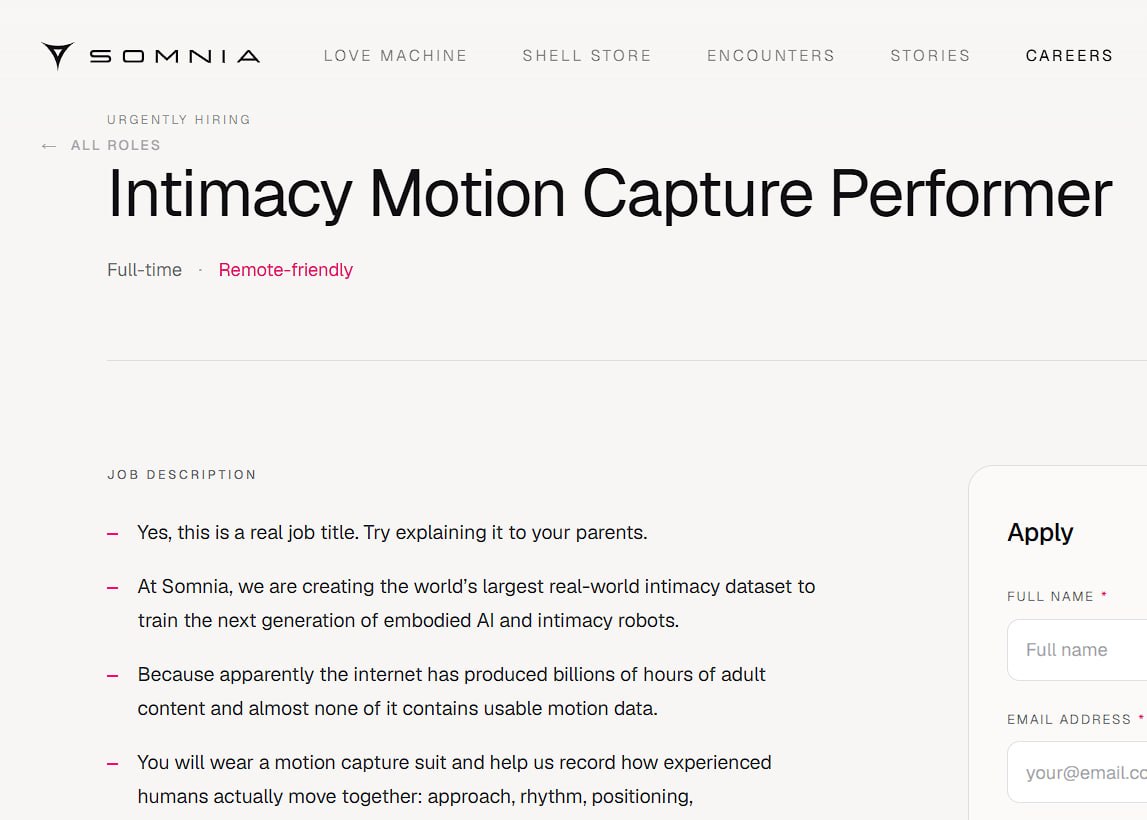
Стартап Somnia ищет актеров для обучения секс-роботов

Приватный инференс: TEE и оптимизация моделей

з@ctodailyAI-инженер
1 мес

ByteDance представила Lucida для понимания объектов роботами

C@CGIT_Vinesгеймдев
1 мес
Еще одна интересная работа от ByteDance - Lucida. Очевидным является тот факт, что роботам нужно будет понимать с чем они имеют дело когда они выйдет в открытый реальный мир. Сейчас когда их обучают, для них делают специальные виртуальные среды максимально приближенные к реальности. Когда они попадут в реальный мир им нужно будет самим определять что перед ними, цельный ли это объект, или составной, тяжелый или легкий. Одним из предлагаемых вариантов являются подобные алгоритмы по достраиванию сцены и переводу данных с датчиков в приближенные к реальным предметы окружения.

Сообщество выпустило ускоренные GGUF-кванты и «расцензуренные» версии Qwen3.8-27B, GLM-5.3 и DeepSeek-V4-Flash

В конце августа — начале сентября 2026 года независимые разработчики и энтузиасты одновременно выпустили серию GGUFi-квантизаций флагманских открытых LLM (Qwen3.8-27B, GLM-5.3, DeepSeek-V4-Flash) с технологиями ускорения инференса DFlash2i и DSpark drafter, а также несколько версий этих моделей со снятой цензурой («abliteratedi»/«uncensored»).

Расцензуренные версии позиционируются авторами не для развлечения, а для практических задач: ред-тиминга, кибербезопасности и автономных агентов, которым мешает встроенный механизм отказа отвечать на запросы.

×1.38ускорение DeepSeek-V4-Flash на DGX Spark
$1лимит песочницы AbliterationAI
12/25результат Tiel-Coder-35B-A3B на SWE-bench-Live

Полный разбор →

AI-лаборатории не имеют публичных планов сдерживания «взбесившихся» моделей

P@prorobotovchannelавтор про «tech»
1 мес

Небольшая лаба выпустила инференс-движок со спекулятивным декодингом для Apple Silicon

Небольшая независимая лаба анонсировала мажорный релиз своего инференс-движка с поддержкой спекулятивного декодинга. По заявлению авторов, движок значительно превосходит все существующие стеки для Apple Siliconi по производительности — за счёт того, что кернелы, квантизация и механизм спекуляции были спроектированы совместно (ко-дизайн) и написаны с нуля, без заимствований.

На старте поддерживаются модели Qwen3.6 27B, в разработке — поддержка Qwen3.8 27B и Muse Glimmer. Попробовать движок можно уже сегодня.

Полный разбор →

Опыт внедрения векторного поиска и AI-ассистента на vc.ru и DTF

Т@kontsarenkoавтор про «it»
1 мес

Использование AI-генераций персонажей в коммерции: юридические риски

Ю@BuglessLawyerавтор про «finance»
1 мес

Гипотетическая утренняя лента новостей из 2026 года: два канала синхронно нарисовали картину прогресса ИИ

Два Telegram-канала — «Сиолошная» и «Denis Sexy IT 🤖» — опубликовали почти идентичный текст-мысленный эксперимент: как может выглядеть утренняя подборка новостей в день 28-летия автора в 2026 году, если экстраполировать текущие темпы развития технологий. Это не реальные события, а спекулятивный сценарий, иллюстрирующий, насколько быстро, по мнению авторов, могут продвинуться беспилотный транспорт, биотех, робототехника, автономные ИИ-агенты, математика и космонавтика.

Список из шести гипотетических заголовков охватывает сразу несколько сфер — от медицины до космоса — и подан как единая утренняя сводка, чтобы показать кумулятивный эффект параллельного прогресса в разных областях.

50%снижение риска рецидива меланомы
70 метроввысота ракетного ускорителя
2014год предыдущего рекорда по простым числам

Полный разбор →

AfterQuery стал самым быстрорастущим единорогом в истории Y Combinator

G@aiofthedayAI-инженер
1 мес

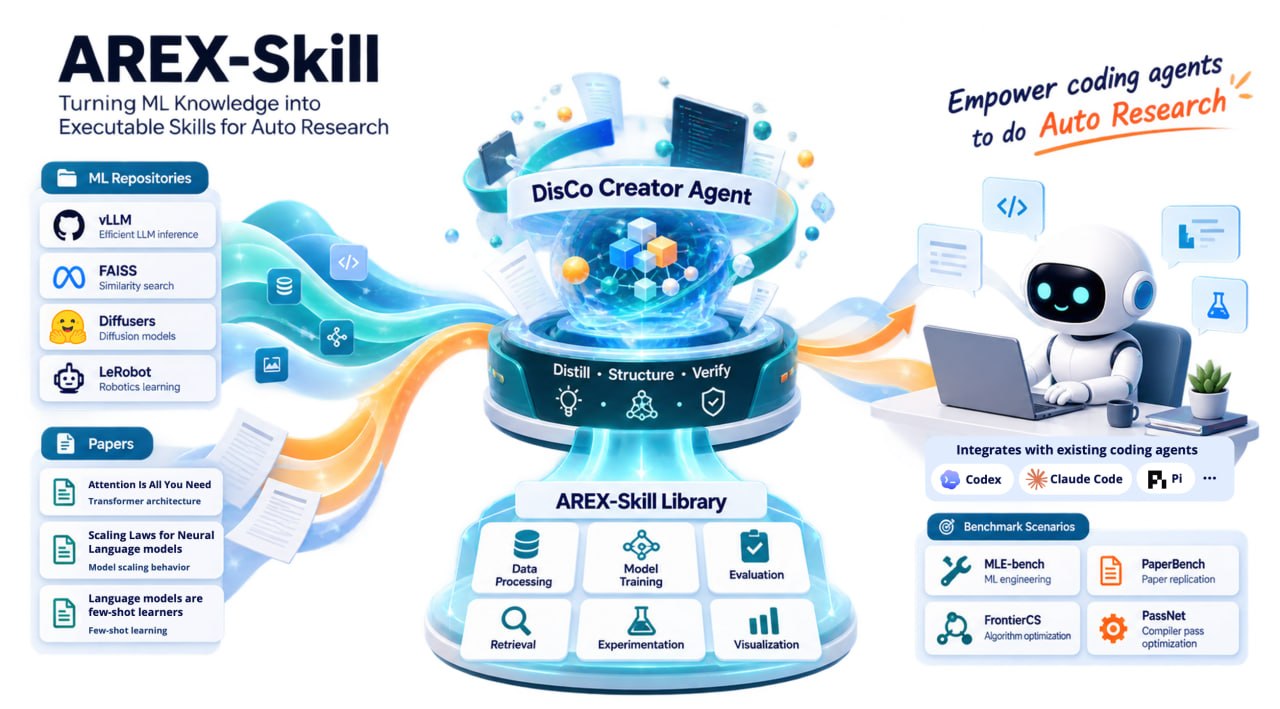
AREX-Skill: дистилляция репозиториев в готовые навыки для AI-агентов

Н@GreenNeuralRobotsAI-инженер
1 мес
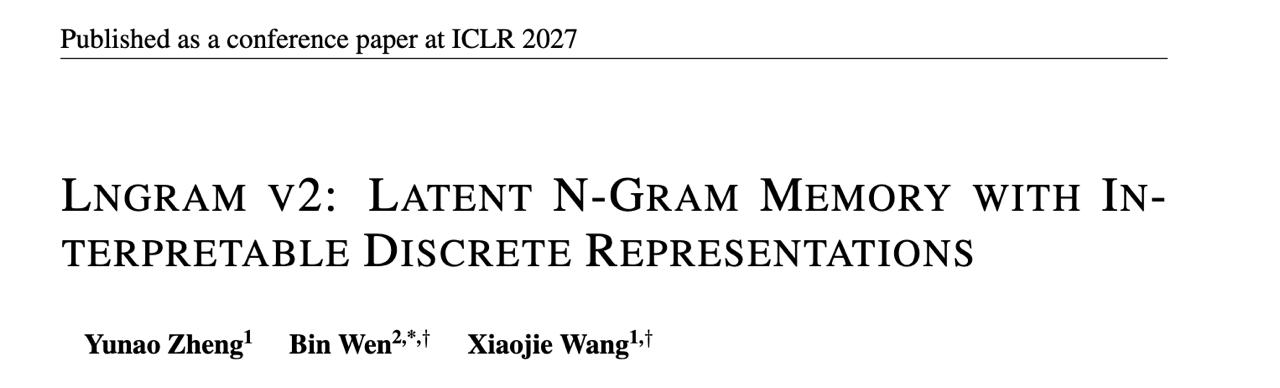
AREX-Skill / DisCo Дистиллятор превращает GitHub-репозитории и статьи в готовые скиллы для агентов. Агент не читает README, не ищет по Stack Overflow, не гадает, как запустить vLLM или SGLang — он просто загружает скилл и знает, что делать, как проверить результат и как чинить, если сломалось Результат дистилляции — 5000+ проверенных скиллов из 1000 репозиториев по 20 направлениям: LLM, CV, bio/chem, робототехника, data science и всё остальное из открытого ML-мира #skill #coding VK | MAX
AREX-Skill: дистилляция репозиториев в готовые навыки для AI-агентов

Методы сбора датасетов для обучения нейросетей

З@CVML_teamAI-инженер
1 мес
Так. Давно видео не было. И переезжал, и август был загруженный, и отдохнуть немного хотелось 😁 Последние пару месяцев всё что в этом видео было - проговаривал людям сам. Подумал что раз так часто - то надо делать видео. Расскажу о разных способах сбора датасетов для тренировки. Я не рассказывают тут про сбор данных с "головы" когда человек работает. Это скорее надо для претрейна, а не для конечного обучения. https://youtu.be/zlLymNdF_hk
Ещё ↓