Создание короткометражного AI-фильма STATUS за выходные
М@cgeventAI-инженер
1 мес
В сообществе разгорелся скандал вокруг тарифов Anthropic Claude Max: выяснилось, что множитель «20x» в плане Max 20xi за $200 действует только внутри 5-часового окна использования, а не как общий лимит по сравнению с тарифом за $100.
По недельным лимитам разница между планами за $100 и $200 оказалась значительно меньше обещанной — что вызвало волну критики и уже привело к коллективному иску против Anthropic.
Исследователи AMAP-ML (Alibaba) выпустили DreamX-Creator — фреймворк, который по первому кадру и текстовому промпту нативно генерирует видео вместе с речью, музыкой и звуковыми эффектами, синхронизируя аудио и видео в обе стороны. Модель занимает всего 7B параметров, но по качеству A/V-синхронизации в тестах авторов обходит куда более крупные LTX-2.3 (22B) и MiniMax H3 (33B).
Главная приманка — обещанные открытые веса и инференс-код: для модели такого размера это открывает дорогу к квантованным версиям, LoRA и запуску через ComfyUI на обычном железе, а не только в дорогих облаках.
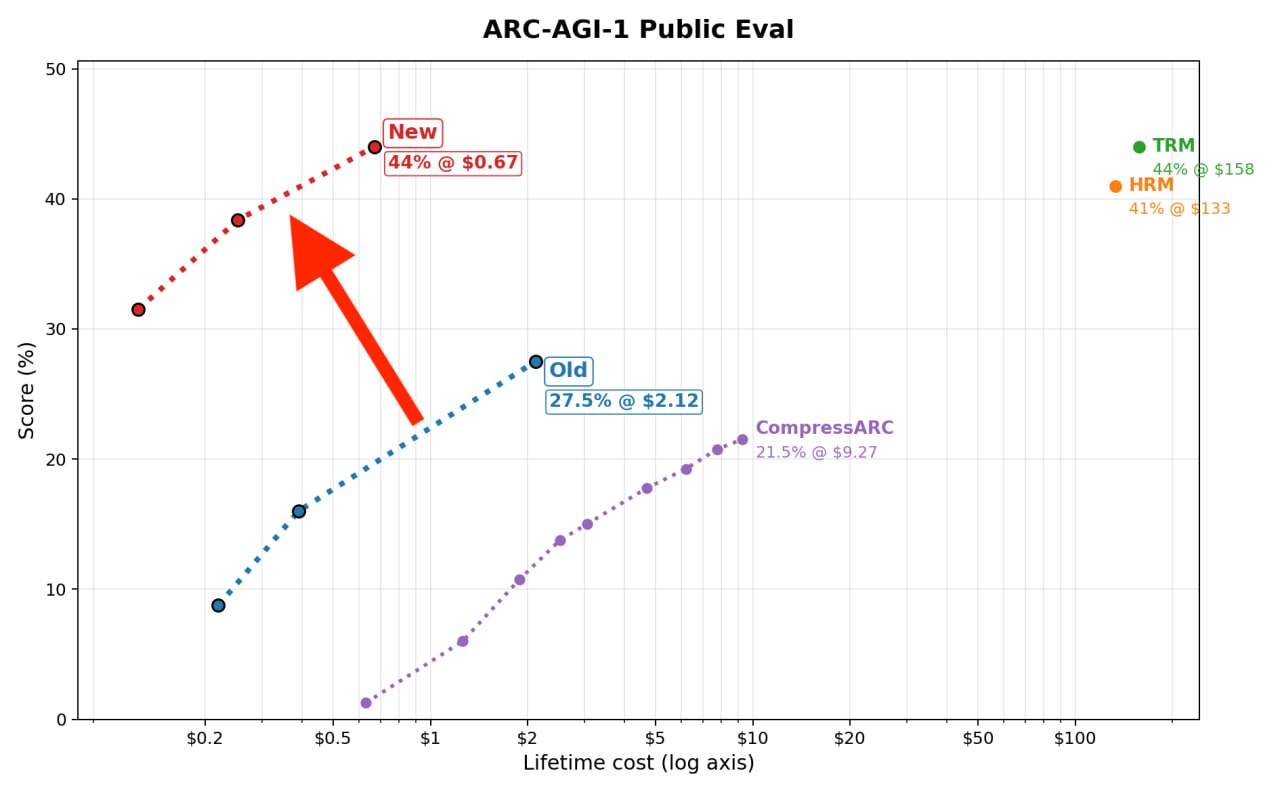
DeepSeek опубликовала под лицензией MIT веса экспериментальной модели DeepSeek-V4-Flash-Vision-Exp — спустя 10 дней после её релиза. Модель на 305 млрд параметров построена на архитектуре V4-Flash, но дополнена визуальными модулями и дообучена на понимание изображений, чтобы получился агент, умеющий разбирать скриншоты, читать графики и работать с инструментами.
По заявлению компании и части тестировщиков (по данным vc.ru), новинка приблизилась по возможностям к Claude Opus 4.8 — на ряде бенчмарков обходит его, на других пока отстаёт.
В середине августа 2026 года китайская Z.ai выпустила GLM-5.3 — по её собственному описанию, «самую способную» модель компании для агентного программирования (agentic codingi) и киберзащиты. Это дообученная версия GLM-5.2 с 743 млрд параметров. Спустя пару недель, после оценки безопасности, компания опубликовала веса модели на HuggingFace — это полноценный релиз весов, а не просто доступ по API, так что модель можно скачивать, запускать локально и дообучать под свои задачи.
Однако, в отличие от предыдущих релизов, Z.ai отказалась от свободной лицензии MIT: теперь сервисы с годовой выручкой выше $10 млрд обязаны проходить проверку безопасности у Z.ai перед использованием GLM-5.3. Это отмечают как признак того, что китайский открытый ИИ начинает «закрываться».
Канал «Метаверсище и ИИще» опубликовал два разбора возможностей модели генерации видео MiniMax H3i, показывающих её способность выполнять сложные, растянутые во времени инструкции внутри одного текстового промпта — без использования отдельных инструментов управления (типа ControlNeti).
Runway показала экспериментальную систему Solaris — «Interface World Modeli», где интерфейс приложения не пишется заранее, а генерируется покадрово в момент взаимодействия. Клик, перетаскивание или ввод текста становятся сигналом для модели, которая на лету рисует следующий кадр — как в видео, а не как в обычном софте с фиксированными экранами и кнопками.
Это принципиально отличается от нынешних «AI-генераторов сайтов» (типа clode-инструментов), которые пишут код, после чего интерфейс работает как обычная программа. Solaris вообще не создаёт код — она непрерывно генерирует пиксели интерфейса в ответ на действия пользователя, то есть фиксированного UI не существует, есть только видеопоток, ведущий к решению задачи.