aiСбросить фильтр ×

DistScene: генерация 3D-сцен из одного изображения

Н@GreenNeuralRobotsAI-инженер
3 нед

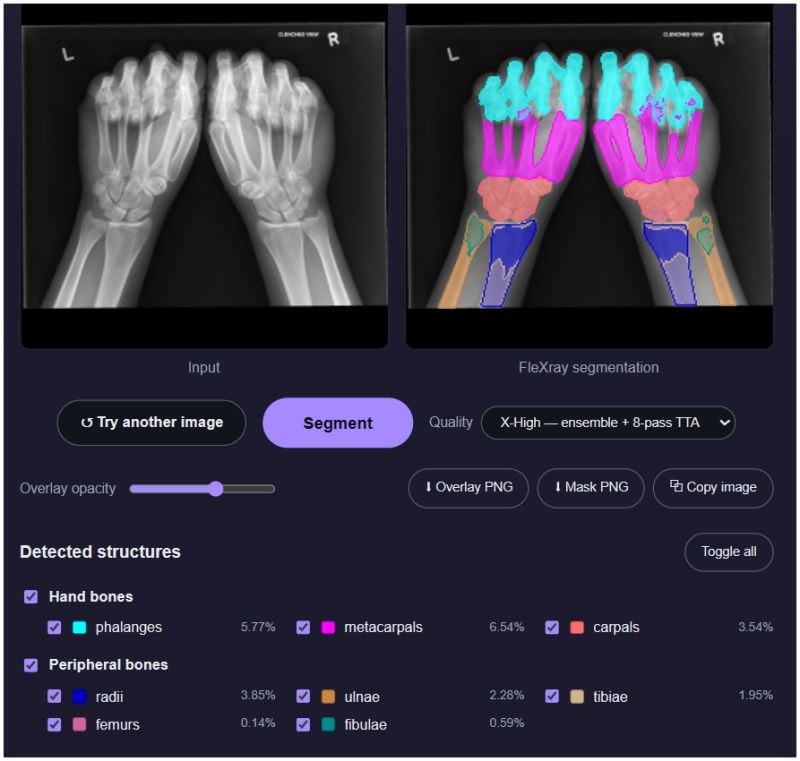
MIT CSAIL представила модель FleXray для сегментации анатомии на рентгеновских снимках

3 нед
MIT CSAIL представила модель FleXray для сегментации анатомии на рентгеновских снимках

Representation-Space MMD: новый метод дистилляции диффузионных языковых моделей

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 3 нед назад

Исследователи (в статье упоминаются «два Ильи и Дима») перенесли MMDi-лосс, ранее показавший себя в дистилляции диффузионных картиночных моделей, на диффузионные языковые модели. Подход заметно улучшает баланс качество/скорость (Парето-фронт) при генерации текста, снижая число шагов инференса без существенной потери качества.

Идея развивает более раннюю работу тех же авторов Scale-wise Distillation of Diffusion Models, где MMD-лосс применялся для ускорения диффузионных моделей изображений. Теперь аналогичная техника адаптирована под специфику текстовых диффузионных моделей — как дискретных, так и непрерывных.

ВыводMMD (Maximum Mean Discrepancy) — мера различия между распределениями P и Q через положительно определенный кернел k (линейный, RBF и др.), считается по формуле с тремя слагаемыми: E[k(x,x')] + E[k(y,y')] − 2E[k(x,y)].

Полный разбор →

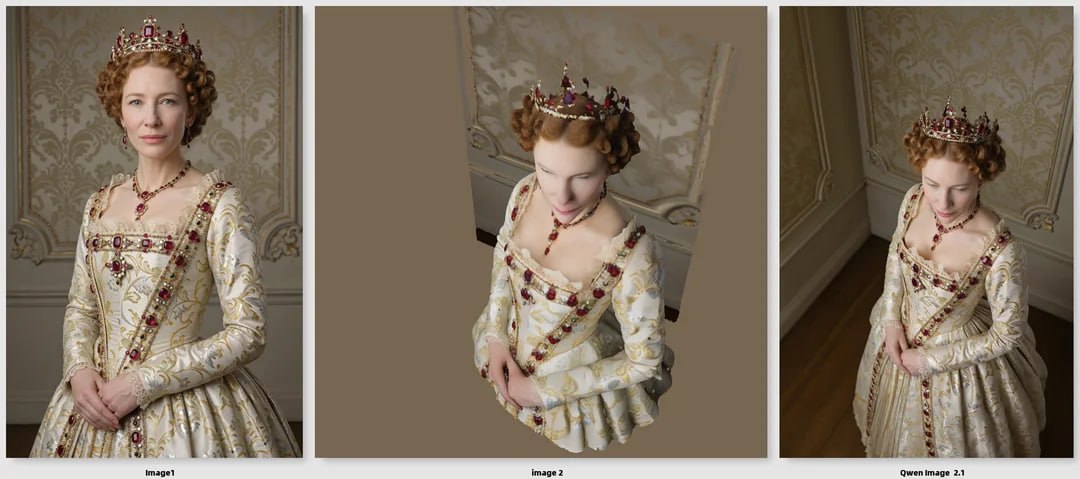
Подборка инструментов и LoRA для Qwen-Image-2.1

Н@GreenNeuralRobotsAI-инженер
3 нед
Подборка инструментов и LoRA для Qwen-Image-2.1

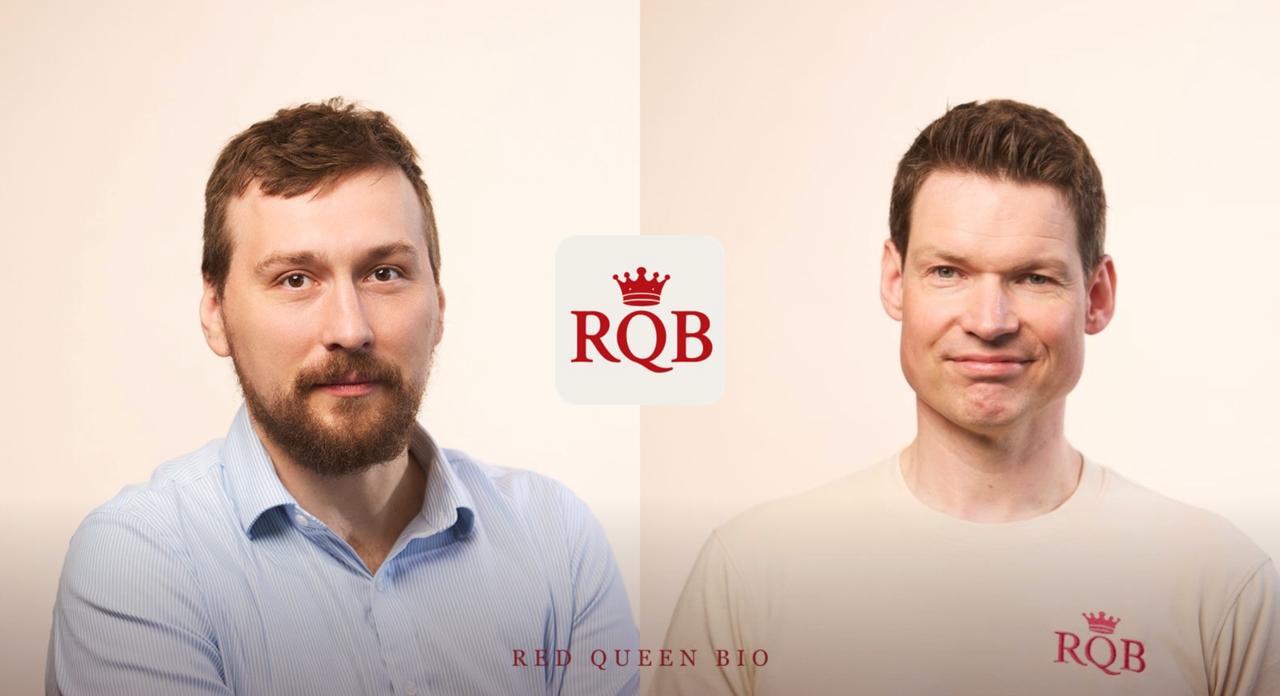
История Red Queen Bio: борьба с биоугрозами с помощью AI

T@Theedinorogblogавтор про «startups»
3 нед
История Red Queen Bio: борьба с биоугрозами с помощью AI

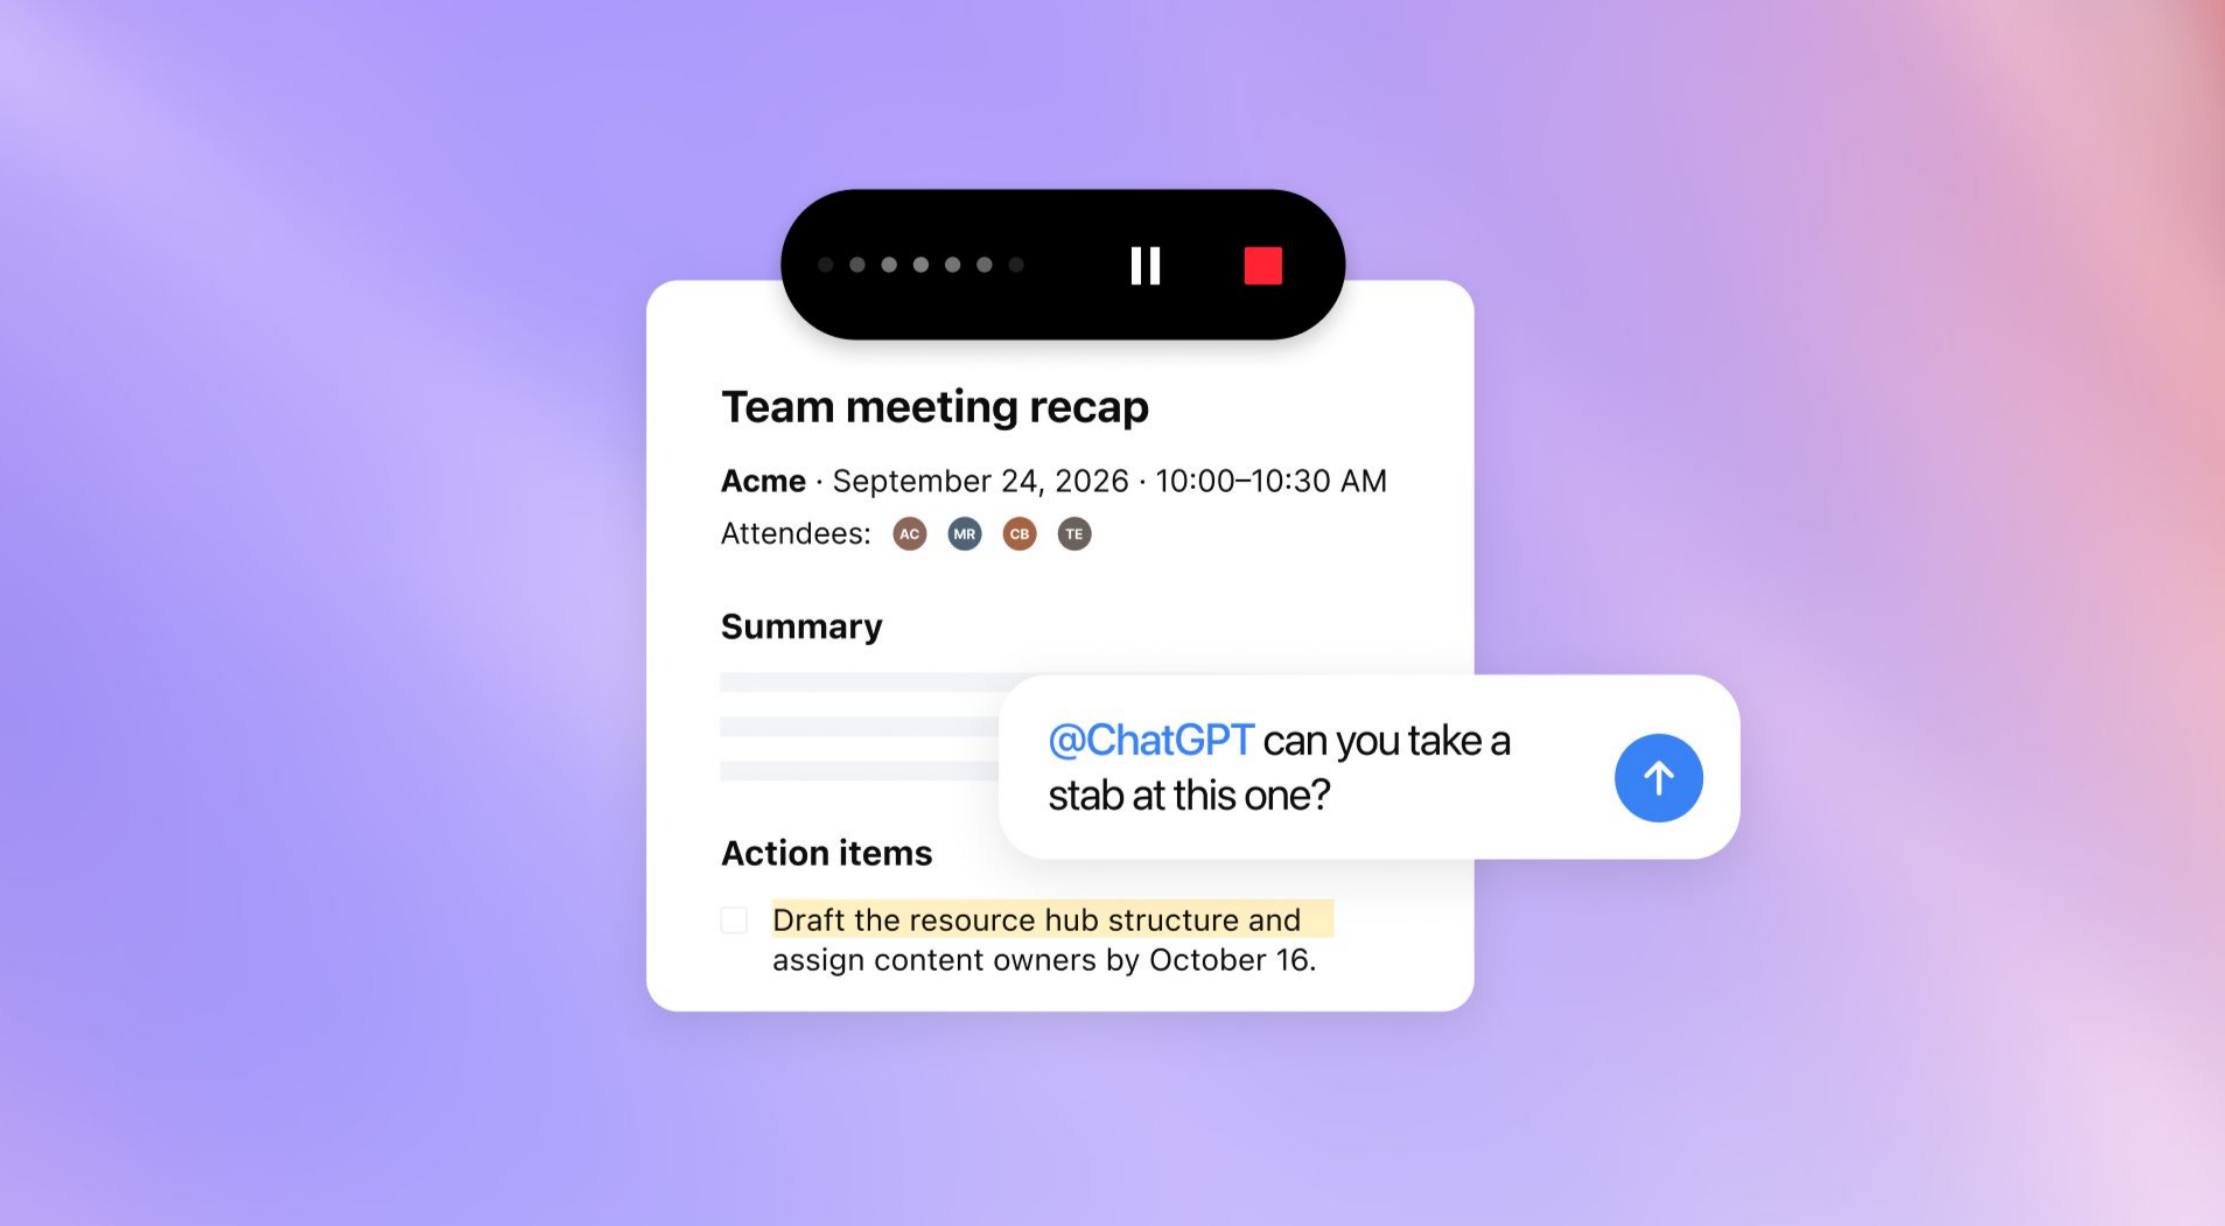
OpenAI представили функцию для ведения заметок с встреч

Р@researchoshnayaAI-инженер
3 нед
OpenAI наконец-то реализовали хоть что-то полезное — meeting note-taker. В целом вместе со Space нормик, такой типо а-ля убийца Obsidian
OpenAI представили функцию для ведения заметок с встреч

Уязвимости в AI-агенте Muse от Meta

М@maxvotekAI-инженер
3 нед
Уязвимости в AI-агенте Muse от Meta

Сравнение Kandinsky Video с реальными съемками

M@mashkka_dsAI-инженер
3 нед
Kandinsky VS Reality: my side-by-side Провела side-by-side для нового Kandisky video, сравнив его генерации с реальными видео, которые я на Мадагаскаре сняла. И у нас ничья! Зебра: ракурс реального видео и это финальное "селфи" с зеброй не оставляют Канди шансев. Kandi : Reality = 0:1 Лемуры: оба видео настолько милые, что я просто ору и присваиваю обоим балл. Kandi : Reality = 1:2 Хамелеон: тут однозначно победа за Канди. Какая улыбка и какие эмоции. просто топ! Kandi : Reality = 2:2

Mento VC инвестирует в AI-платформу Structify

С@exitsexistавтор про «startups»
3 нед
Mento VC инвестирует в AI-платформу Structify

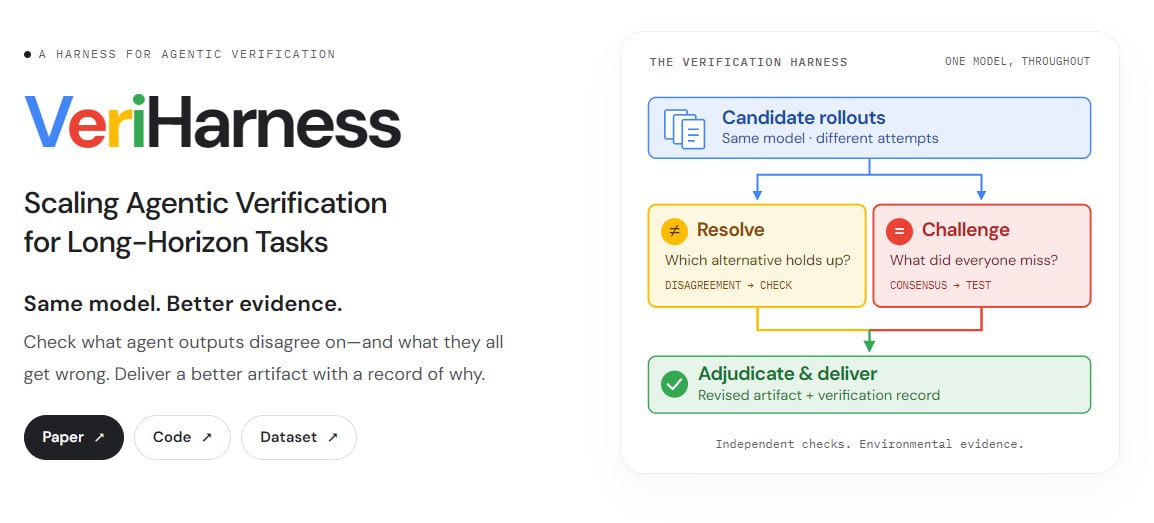
VeriHarness: система самопроверки для ИИ-агентов

3 нед
VeriHarness: система самопроверки для ИИ-агентов

Экосистема Indie GO запустила венчурный фонд Indie Go Fund II на 5 млрд рублей

Российская игровая экосистема Indie GOi, объединяющая около 10 тысяч разработчиков видеоигр, создала венчурный фонд Indie Go Fund II объёмом 5 млрд рублей. Фонд будет инвестировать в компании на разных стадиях развития — от Pre-Seed до Series Bi, с фокусом на ПК- и консольные проекты, а также технологии в сегменте AI GameTechi.

Помимо денег, фонд предлагает портфельным компаниям профильную экспертизу — по издательству, маркетингу и дистрибуции, — с целью нарастить их стоимость и вывести на IPO или продать стратегическим покупателям.

5 млрд рублейобъём фонда Indie Go Fund II
200 млн рубсредний размер инвестиции
20–25компаний в портфеле фонда

Полный разбор →

AI-ассистент Точка помог вернуть средства за вынужденную ночевку

A@nn_for_scienceAI-инженер
3 нед
AI-ассистент Точка помог вернуть средства за вынужденную ночевку

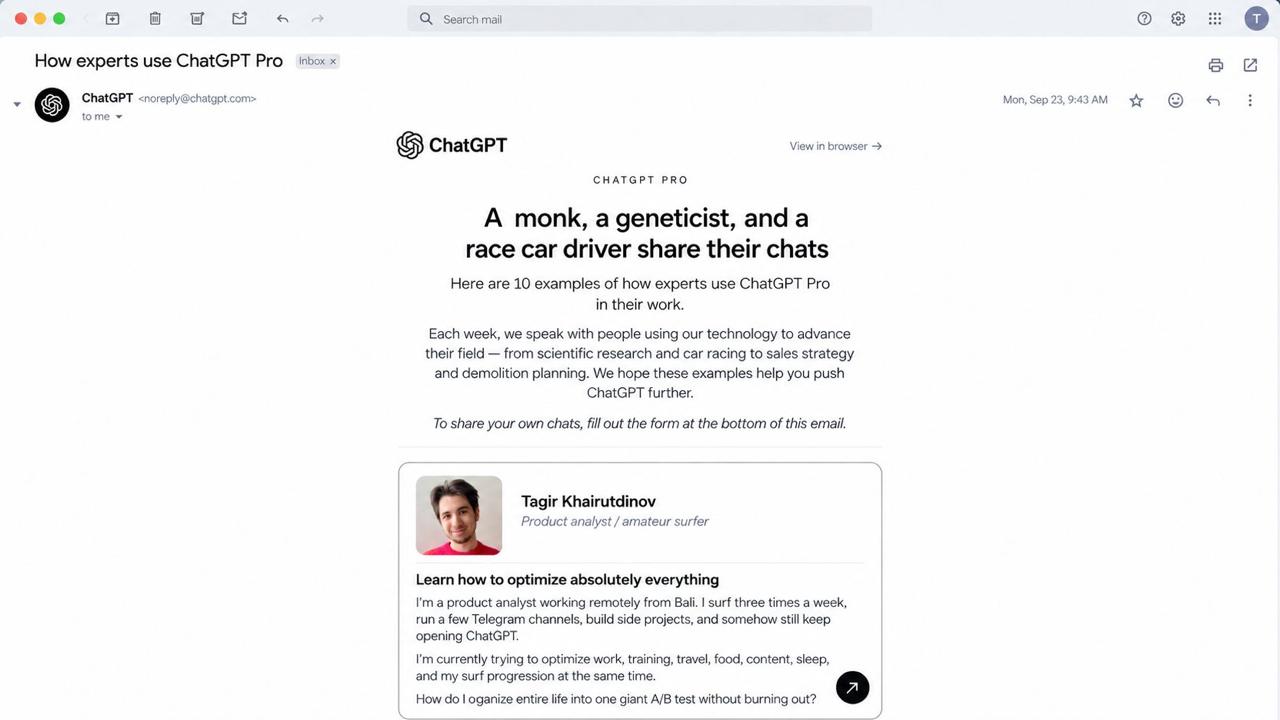
OpenAI включили кейс пользователя в рассылку ChatGPT Pro

Т@tagir_analyzesAI-инженер
3 нед
OpenAI включили кейс пользователя в рассылку ChatGPT Pro

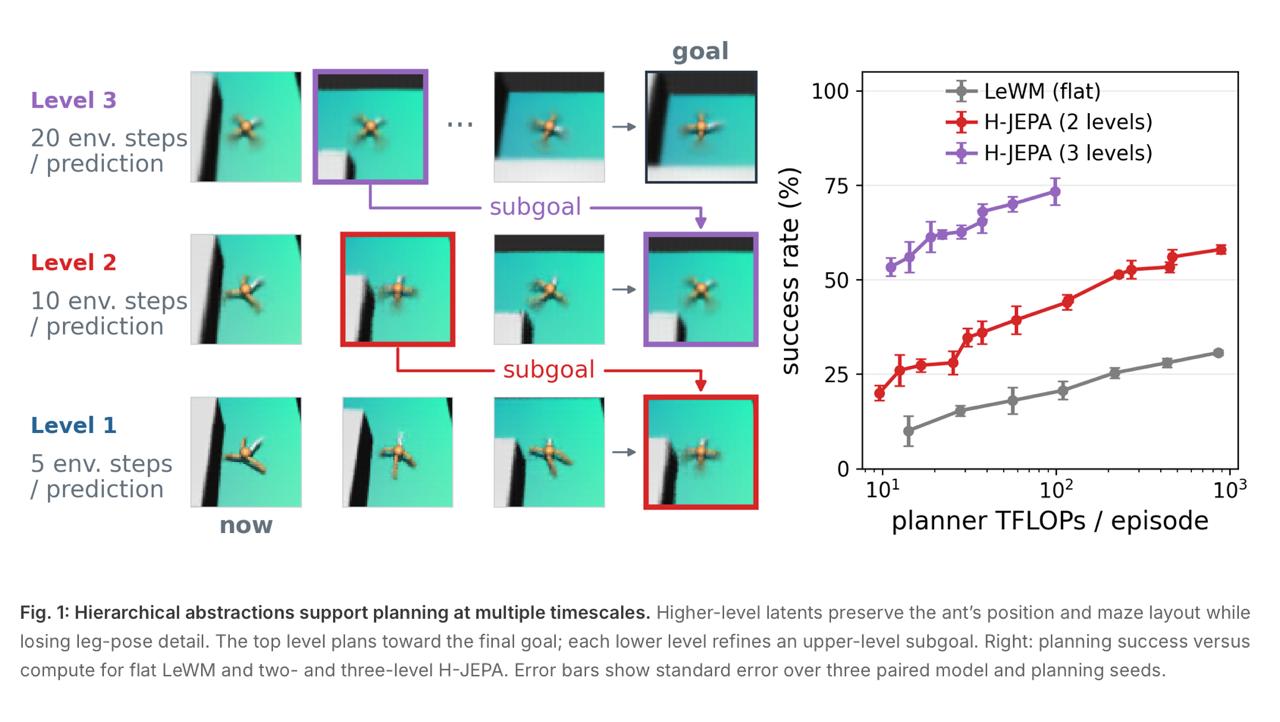
H-JEPA: иерархическое планирование в моделях мира

D@data_secretsAI-инженер
3 нед
H-JEPA: иерархическое планирование в моделях мира

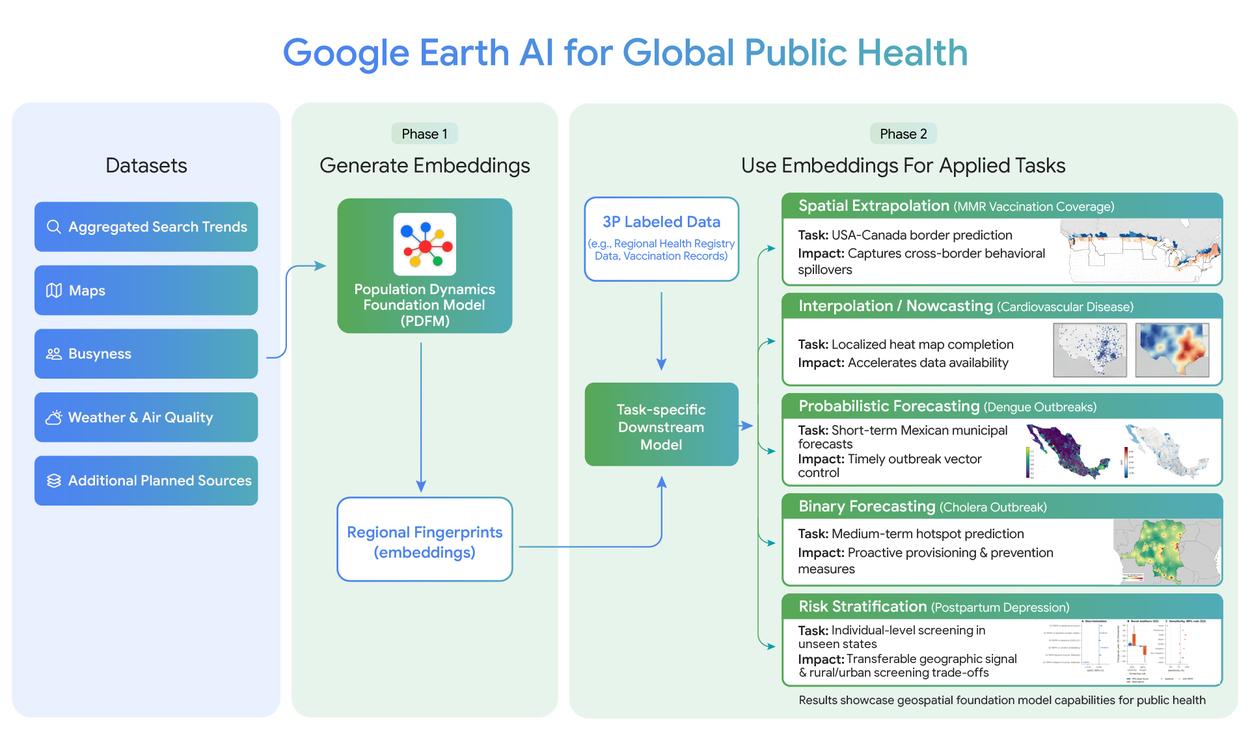
Google представила модель PDFM для прогнозирования эпидемий

3 нед
Google представила модель PDFM для прогнозирования эпидемий

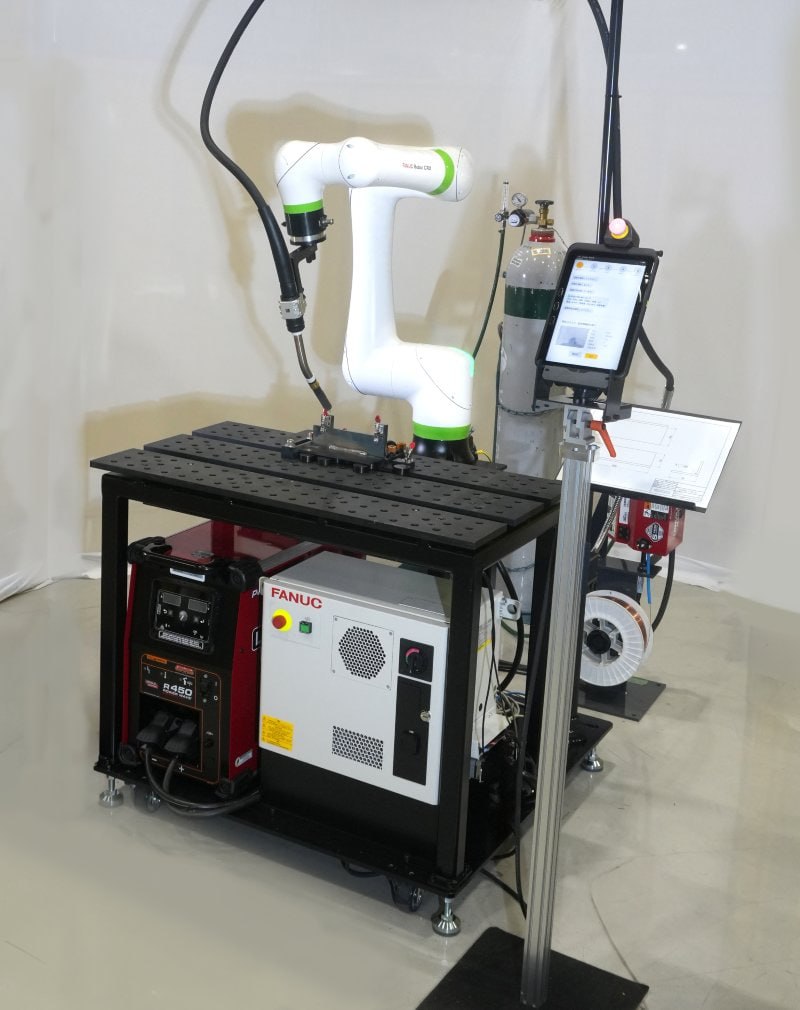
FANUC и Google представили AI Welding Agent для автоматизации сварки

3 нед
FANUC и Google представили AI Welding Agent для автоматизации сварки

Голосовое управление AI-агентами как инструмент продуктивности

А@almazrobotsAI-инженер
3 нед
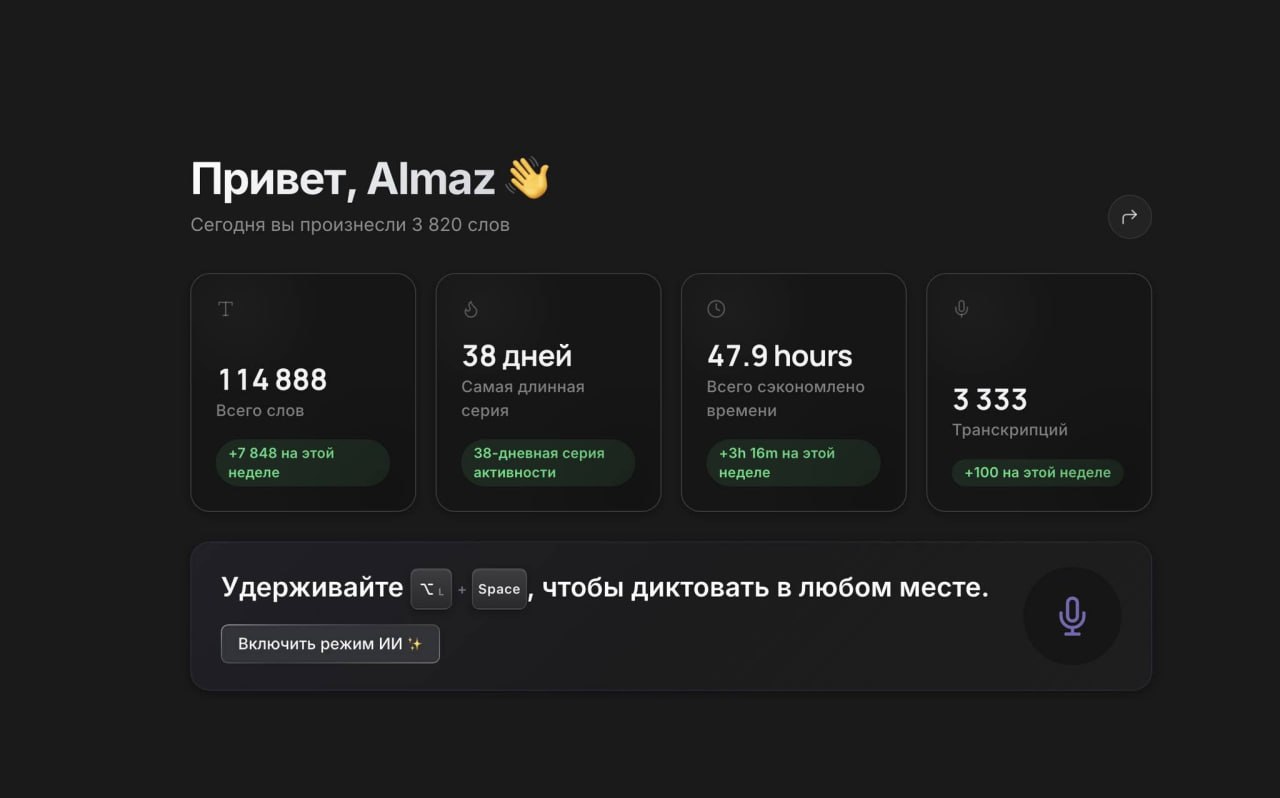
помню время, когда отправленное голосовое в мессенджер вызывало серьезное напряжение и отторжение. Оно конечно никуда не делось, если голосовые без повода и человек не может кратко сформулировать. А вот с агентами все совершенно иначе - если верить их расчетам, я сэкономил 48 часов времени, используя голосовую диктовку. Агенты не потеряли нужный мне контекст, я добавил нужных деталей и получил запрошенный результат. Ни разу не помню ситуацию, что было "точно блин я чушь надиктовал, агенты фигню сделали". Кроме того, это ведь какое подспорье, если объединить голосовую диктовку агентам с уроками по ораторскому мастерству?
Голосовое управление AI-агентами как инструмент продуктивности

«Сбер» выпустил Kandinsky 6.0 Video — первую российскую модель для генерации видео с синхронным звуком

«Сбер» представил линейку моделей Kandinsky 6.0 Video — первую российскую нейросеть, которая одновременно генерирует видео и синхронный звук: речь с lip-synci, музыку и звуки окружения. Ролики длятся до пяти секунд, качество звука — 44 кГц, при необходимости аудио можно отключить.

Линейка включает две модели: компактную Lite (3B параметров) для запуска на потребительских видеокартах и флагманскую Pro (29B параметров) с лучшим качеством визуала и следования промпту. Веса открыты под MIT на Hugging Face, код — на GitHub, модель доступна бесплатно в ГигаЧате, а также интегрирована в международный стек инструментов: Diffusers, ComfyUI, FastVideo, SGLang, vLLM-omni и FAL.

29Bпараметров у модели Kandinsky 6.0 Video Pro
3Bпараметров у компактной модели Video Lite
5 секундмаксимальная длительность ролика

Полный разбор →

Meta, Stripe и другие компании разрабатывают стандарт Personal Agent Protocol

G@aiofthedayAI-инженер
3 нед

Ghost представил домашний компьютер для локального AI за $3499

G@aiofthedayAI-инженер
3 нед

Выход Kandinsky 6.0 Image Pro

Н@GreenNeuralRobotsAI-инженер
3 нед
Kandinsky 6.0 Image Pro Картикогенератор тоже выпустиили • Удаление объектов и надписей • Замена объектов с сохранением стиля • Стилизация портретов и реставрация • Колоризация старых фото • Дизайн интерьеров по схеме помещения • Генерация с нуля по промпту • Архитектура MoE — ускорение более чем на 40% против предшественника • RAG: при запросе подтягивает релевантные фото из базы знаний в контекст • По внутренним сравнениям — на уровне Flux 2 Max и выше GPT Image 1.5 - это конечно заявка на победу, сильная претензия Попробовать (как и видео) можно в экосистеме GigaChat: Telegram, giga.chat, Android #t2i #imageediting MAX

Будущее монетизации стартапов: от инструментов к результатам

В@marketlead_meмедиа / агрегатор
3 нед
Будущее монетизации стартапов: от инструментов к результатам

Что строить в 2027 году, если не B2B SaaS

В@marketlead_meмедиа / агрегатор
3 нед
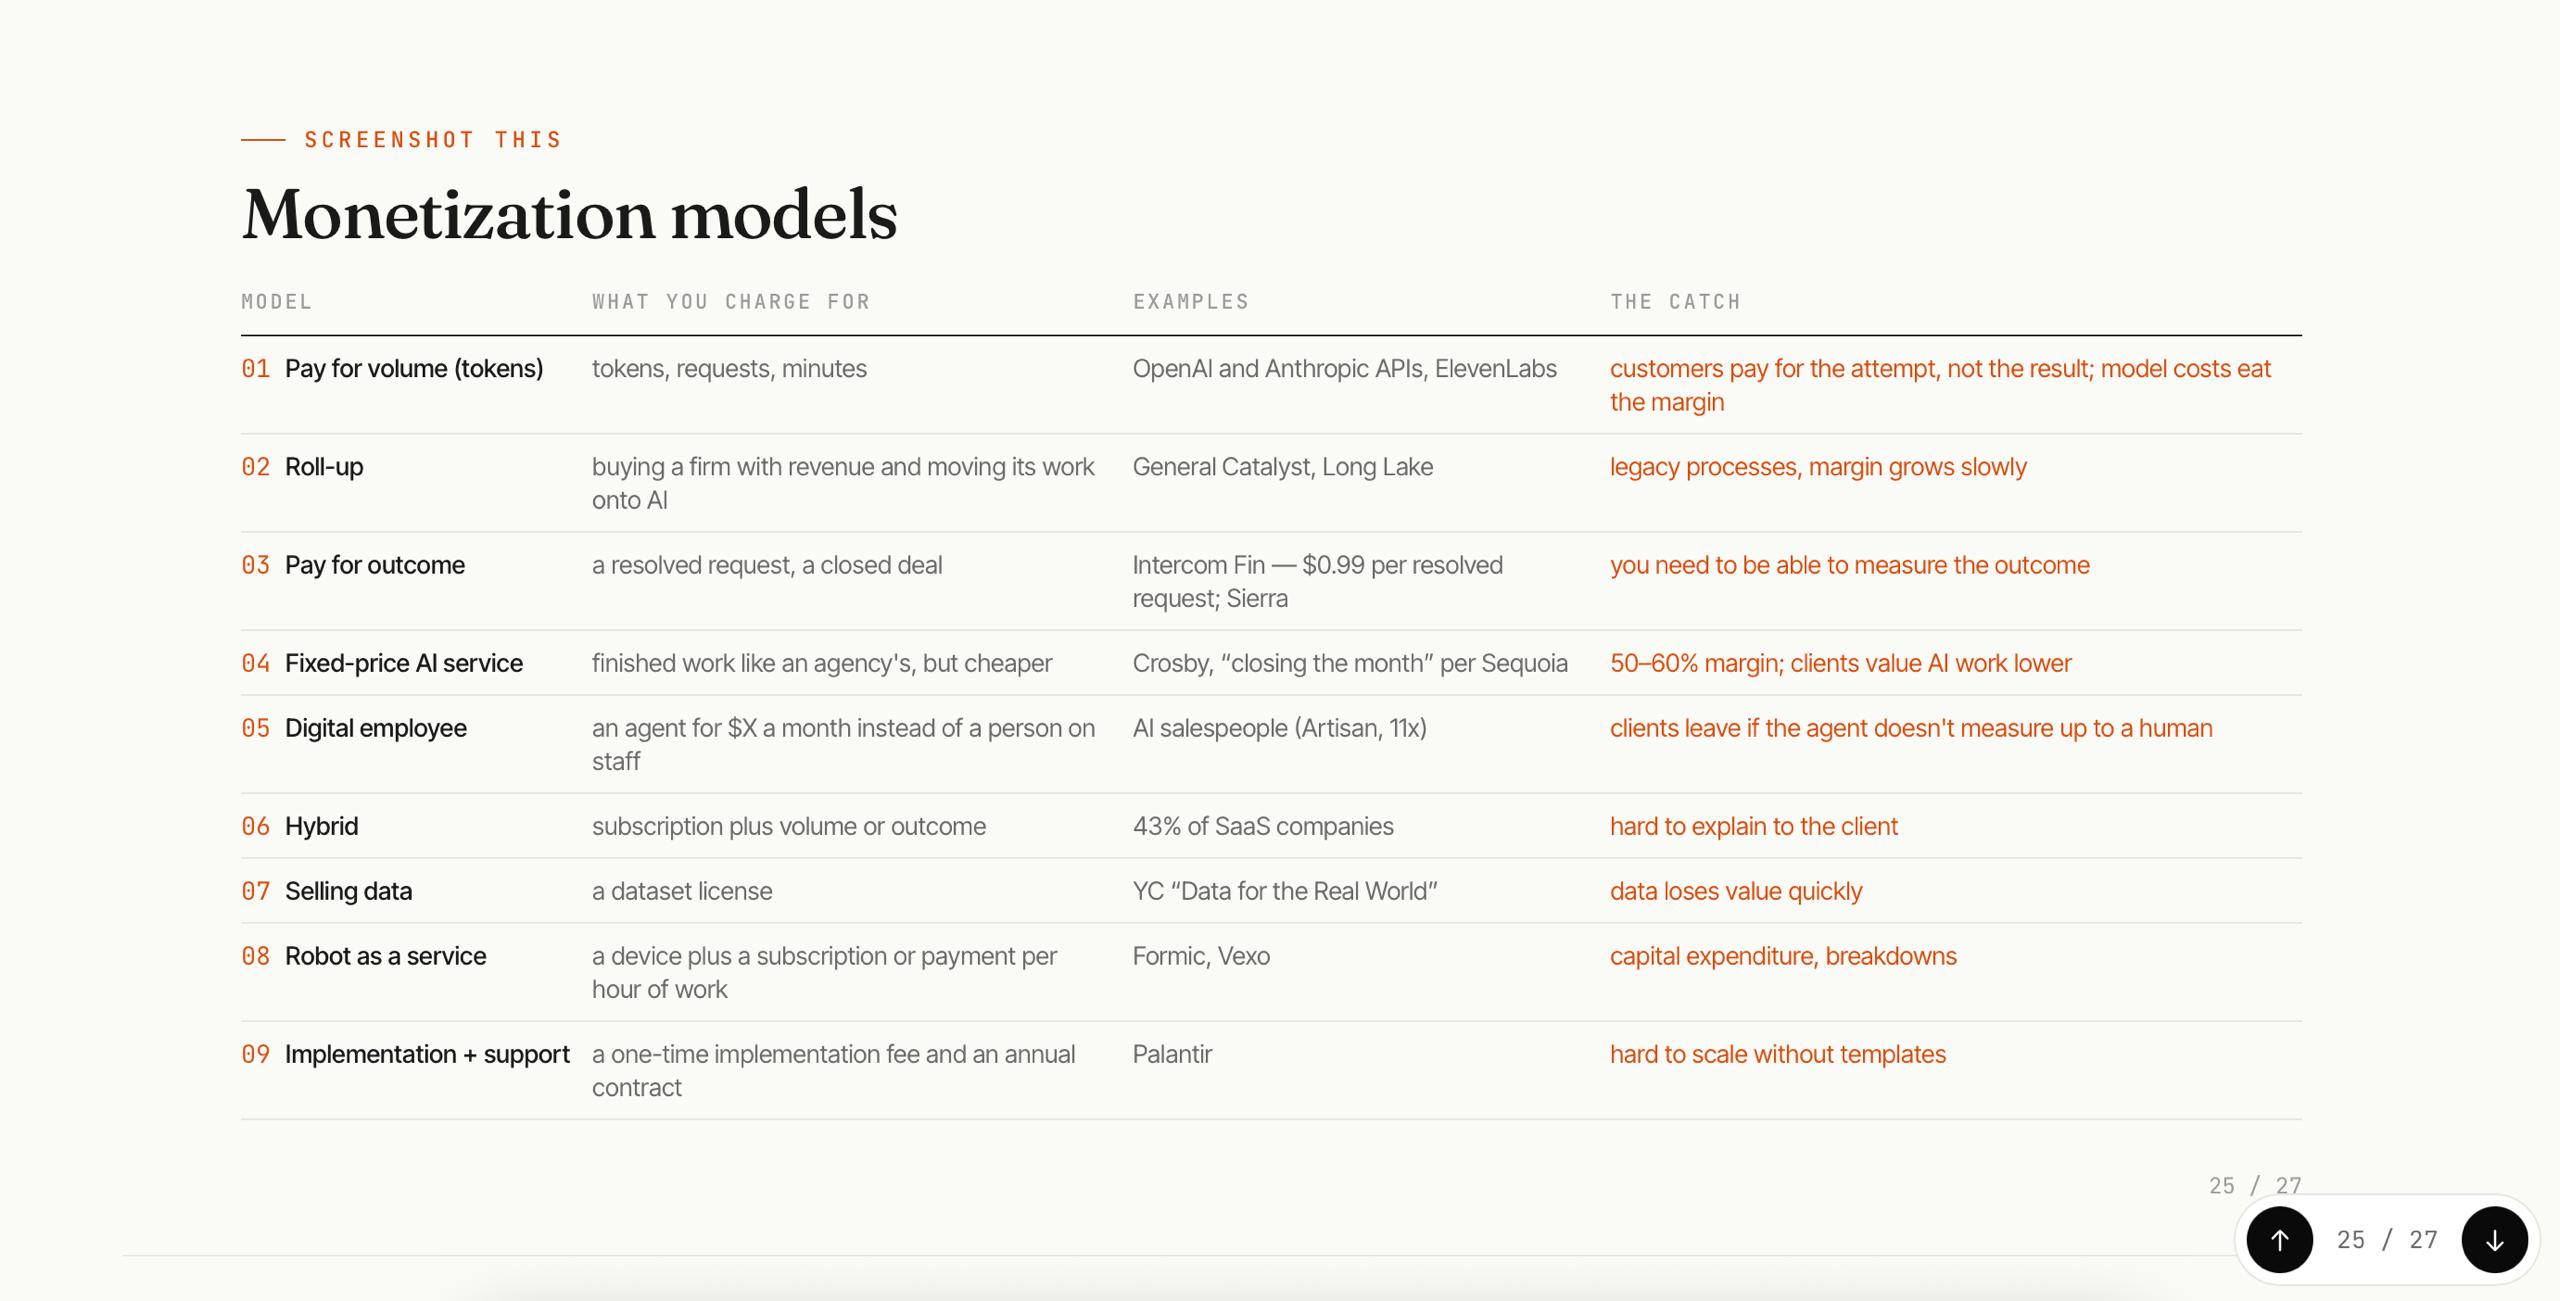
Если меня где-то и можно найти последнее время, то это в оффлайне. Все больше выступаю где-то, например – в Тбилиси, на мероприятии «AI Builders 2027». У меня новая тема – Что строить в 2027, если не b2b saas? Изучив пожелания крупнейших VC-фондов, тенденции YC и на собственном опыте построения AI-driven сервиса по найму, где продается не подписка а итоговый результат с гарантией, составила жирную презентацию. На ее основе, несу вам три поста, в которых разберу, что нам рекомендуют делать в эпоху, когда любую вещь можно построить за 5 минут.
Что строить в 2027 году, если не B2B SaaS

Google выпустила EmbeddingGemma 2 — мультимодальную модель эмбеддингов для поиска прямо на устройстве

Google представила EmbeddingGemma 2 — открытую модель, которая переводит текст, код, изображения, видео и аудио в единое векторное пространство. Это позволяет искать нужный кадр в видео по голосовой заметке, находить фото по текстовому описанию или искать по аудиозаписям текстом — всё локально, без отправки данных в облако.

Модель построена на Gemma 4i и работает даже на смартфонах: по данным Google, на Pixel 11 Pro полная модель потребляет около 567 МБ активной RAM. В отличие от первой версии EmbeddingGemma, которая работала только с текстом, вторая версия мультимодальна и, по заявлению Google, показывает лучший результат среди мультимодальных эмбеддеров до 1 млрд параметров.

740 млнпараметров модели
8K токеновразмер контекста
567 МБRAM на Pixel 11 Pro для полной модели

Полный разбор →

Ещё ↓