Google AI Research и Кембриджский университет представили VeriHarness — систему для проверки результатов работы ИИ-агентов с помощью самих моделей.
🌟
VeriHarness: обвязка для проверки работы агентов той же моделью
Google AI Research и Кембриджский университет открыли код
VeriHarness, системы, которая проверяет результаты долгих агентных задач силами той же модели, что их сделала.
Вместе с кодом выложены около 26 тысяч трейсов агентов Gemini 3.5 flash и Opus 4.8, на генерацию которых ушло больше 100 тысяч долларов.
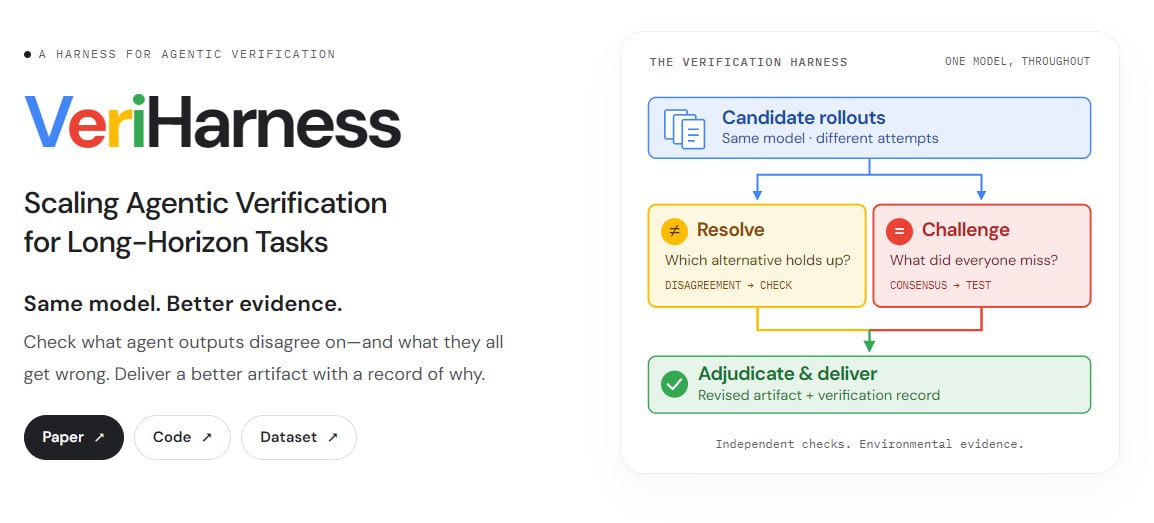
ИИ-агент решает одну и ту же задачу несколько раз, и каждая попытка даёт свой вариант отчёта, таблицы, документа или патча.
VeriHarness сверяет все эти варианты с файлами и данными рабочего пространства и выдаёт лучший вариант, исправленный по найденным ошибкам, вместе с журналом проверок, но эталонных ответов и критериев оценки проверяющий не видит.
Идею подсказали запуски Claude Opus 4.8 на бенчмарке APEX-Agents, где треть ответов, в которых сходились все десять попыток, оказалась ошибочной, а при расхождении верный вариант обычно был среди попыток, но голосование большинством выбирало его лишь примерно в половине случаев.
🟡
Механика
Проверка идёт в двух отдельных контекстах модели.
Первый разбирает утверждения, в которых прогоны расходятся, и подбирает проверку, которая лучше всего отделит верный вариант.
Второй ищет ошибки там, где все прогоны согласны, например пересчитывает итоги или сверяет валюту с метаданными источника.
Затем новый контекст сводит оба журнала, выбирает базовый прогон и план правок, а нерешённые вопросы помечает отдельно.
Что именно проверять, подсказывают 18 навыков, коротких инструкций со скриптами для таблиц, PDF, документов, презентаций и патчей.
Навыки умеют пополняться сами из разборов ошибок на отладочных задачах.
Протокол работает внутри Gemini CLI, Claude Code и Codex.
🟡
Тесты
На пяти бенчмарках рабочих задач APEX-Agents, SpreadsheetBench 2 и JobBench, VeriHarness с правками поднял средний результат по сравнению с одиночным прогоном с 47,2 до 53,4 балла у Gemini 3.5 Flash и с 49,6 до 56,1 у Claude Opus 4.8.
Сильнее всего вырос APEX-Agents у Opus, с 35,8 до 47,5.
Без правок, в режиме выбора лучшего прогона, VeriHarness обошёл все сравниваемые методы, включая LLM-as-a-Verifier, на всех бенчмарках у обеих моделей.
📌Лицензирование: Apache 2.0
🟡
Страница проекта
🟡
Arxiv
🖥
GitHub
@ai_machinelearning_big_data
#AI #ML #Agents #VeriHarness #Google
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖