Экономика AI: почему контекст важнее мощности моделей
S@strategic_moveпродакт / фаундер
1 мес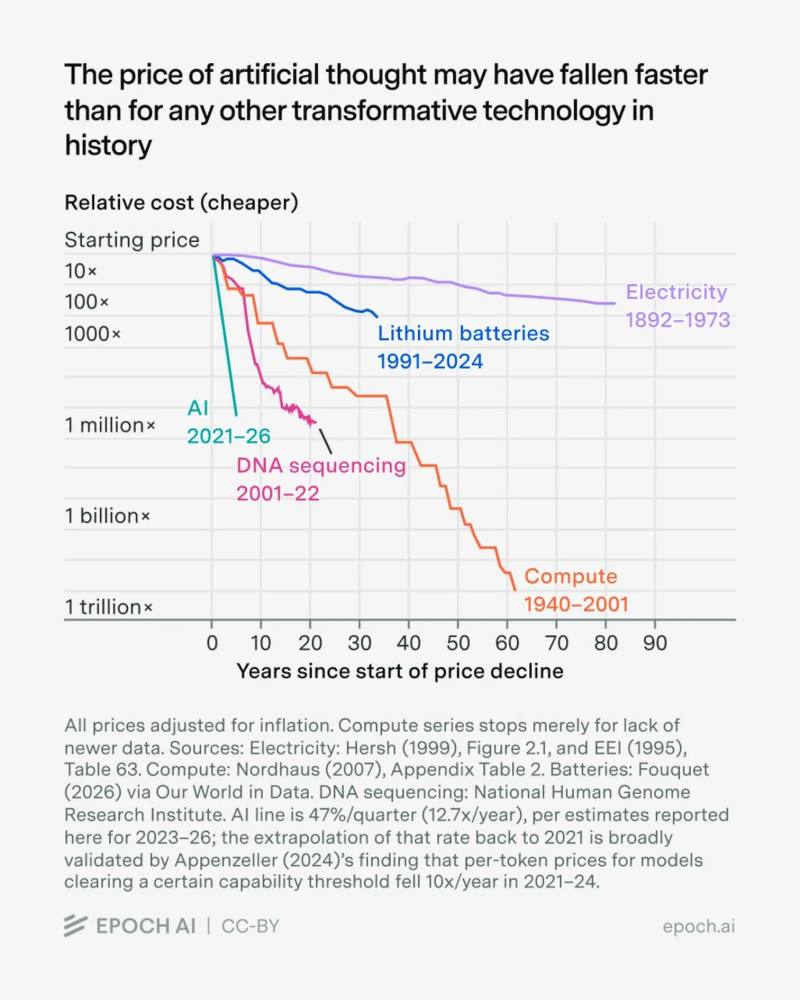
Компания Odyssey выпустила Agora-2 — мультиагентную мировую модель, которая генерирует общий интерактивный игровой мир в реальном времени, просчитывая и отрисовывая его прямо во время игры. В одну и ту же сессию одновременно могут заходить и люди, и ИИ-агенты, а действия каждого участника меняют общий мир для всех остальных.
Это отличает Agora-2 от прежних генеративных игровых моделей (вроде Odyssey-3), которые симулировали опыт лишь одного игрока: здесь же несколько участников делят общее, взаимно согласованное пространство. Проект пока экспериментальный, стилистически близкий к Diablo II, но демонстрирует новый подход к играм, где движок и рендер заменены нейросетью, работающей «наоборот» от игровых записей.
Самая быстрая модель генерации изображений на рынке1.3 секунды от промпта до картинки через API. Быстрый ответ меняет работу - не теряешь фокус между генерациями • фото, портреты, сложные сцены и ранние концепты в стиле Recraft • кнопка Refine - добивает картинку моделью V4.1 Pro в 2048x2048 • держит точные промпты - семь морковок так семь • читает нюансы - intimate значит два человека, а не двенадцать Refine в двух уровнях - subtle и moderate, держит композицию и свет Если вдруг кому надо - уже подключили в партнерские ноды комфи #t2i #i2i MAX
Исследователи из DrivingBenchi подключили четыре топовые языковые модели — GPT-6 Astra, Claude Fable 5.1, Grok 4.6 и GPT-5.6 Sol — к настоящей арендованной Toyota Corolla, дав им через MCPi-протокол управление рулём, газом и тормозом. Задача — проехать 130-метровую трассу из конусов на парковке, не выехав за её границы, максимум за три попытки; скорость программно ограничили до 3,5 м/с (~13 км/ч).
Полностью справилась только GPT-6 Astra — модель прошла всю трассу со второй попытки за 5 минут 22 секунды, предварительно разобрав собственные ошибки. Остальные три модели финиша не достигли: Claude Fable 5.1 прошла 45% маршрута, Grok 4.6 — 11%, GPT-5.6 Sol — 6%. Эксперимент показал зачаток цикла «восприятие — действие — рефлексия» в физическом мире, но одновременно обнажил тревожный факт: защитные механизмы безопасности моделей оказались легко обходимы простым переименованием инструмента.
ВыводС первой попытки GPT-6 Astra прошла лишь 49% маршрута; после того как ей предложили самой разобрать ошибки, она решила ехать медленнее, делать короче манёвры и сильнее выкручивать руль на поворотах — со второй попытки трасса была пройдена целиком
Компания Shopify объявила о полном переходе своих мобильных приложений с кросс-платформенного фреймворка React Nativei на нативные языки Swift (для iOS) и Kotlin (для Android). Процесс миграции флагманского приложения Shop занял 12 недель.
Решение продиктовано развитием AI-агентов, которые автоматизировали написание кода и синхронизацию функционала между платформами. Это нивелировало экономическое преимущество единой кодовой базы, сделав нативную разработку более выгодной с точки зрения производительности и доступа к системным инструментам.
Модель для генерации AI-видео Seediance 2.5 обзавелась режимом Draft Modei (в Dreamina он называется Seedance 2.5 for preview) — способом сначала прогонять дешёвые черновики в 480p, а затем отправлять только понравившийся вариант на финальную генерацию в нативном 1080p.
Это важно, потому что раньше приходилось платить полную цену за каждый дубль в HD. Теперь эксперименты идут в дешёвом 480p, а полную стоимость платишь только за выбранный финальный ролик — ByteDance заявляет экономию на итерациях до 77%.
Адам Елдаров (ex-CPOi YouDo) в двух постах разобрал популярный аргумент: если взять подписку за $200, за месяц выжечь все лимитыi и пересчитать использованные токены по ценам API, получится счёт на $2000 — якобы лаба (AI-компания) субсидирует пользователя на $1800 в месяц, и когда венчурные деньги закончатся, эта модель рухнет. Автор считает такой расчёт логически неверным: потолок лимитов показывает стоимость самого прожорливого юзера, а экономику подписки определяет средний пользователь и всё распределение трат целиком, а не хвост.
По аналогии — любой безлимит (Netflix, мобильный тариф) выглядит «щедрым», если смотреть на самого активного юзера, но платит за тяжёлый хвост молчаливое большинство, заходящее пару раз в месяц. Лимиты существуют именно для того, чтобы хвост не съел экономику среднего; их ужесточение — точечное повышение цены для тех, кто «в минусе», а не признак общего убытка компании.
Nvidia открыла веса Nemotron 3 Diarization — модели на 100 млн параметров, которая размечает аудиозаписи по говорящим: определяет, кто и когда говорил, включая моменты, когда участники перебивают друг друга. Модель работает как с готовыми записями, так и в потоковом режиме, различая до восьми собеседников — вдвое больше, чем предыдущая модель компании Streaming Sortformer.
В связке с ASRi (распознаванием речи) это даёт полную расшифровку встреч, звонков и подкастов с указанием, кто что сказал. Метки говорящих анонимны — модель не определяет личность, а только выделяет каналы speaker_X с таймкодами; привязку имён и ролей к каналам нужно реализовывать логикой конкретного приложения.
YouTube представил ИИ-ассистента для редактирования видео и Shorts, который работает через текстовые (голосовые) команды: убирает лишние паузы, переставляет сцены «для улучшения темпа» и генерирует обложки в стиле канала. Инструмент превращает монтаж в диалог с моделью — пользователь загружает исходники в Shorts или YouTube Createi и просит собрать черновик, а не двигает таймлайн руками.
По данным канала «Метаверсище и ИИще», в основе фичи лежит Gemini Omnii — модель, которая, в отличие от большинства конкурентов, реально понимает не только текст и картинки, но и аудио на входе. Автор уточняет, что ранее ошибочно называл мультимодальными многие модели (включая DeepSeek, Kimi и собственную Astra), хотя они принимают только текст и картинки; по-настоящему мультимодальными на аудио остаются Gemini и новый Qwen Omni.