llmСбросить фильтр ×

Бенчмарк Specific Labs: реальные задачи разработки для LLM

A@ai_productAI-инженер
1 мес
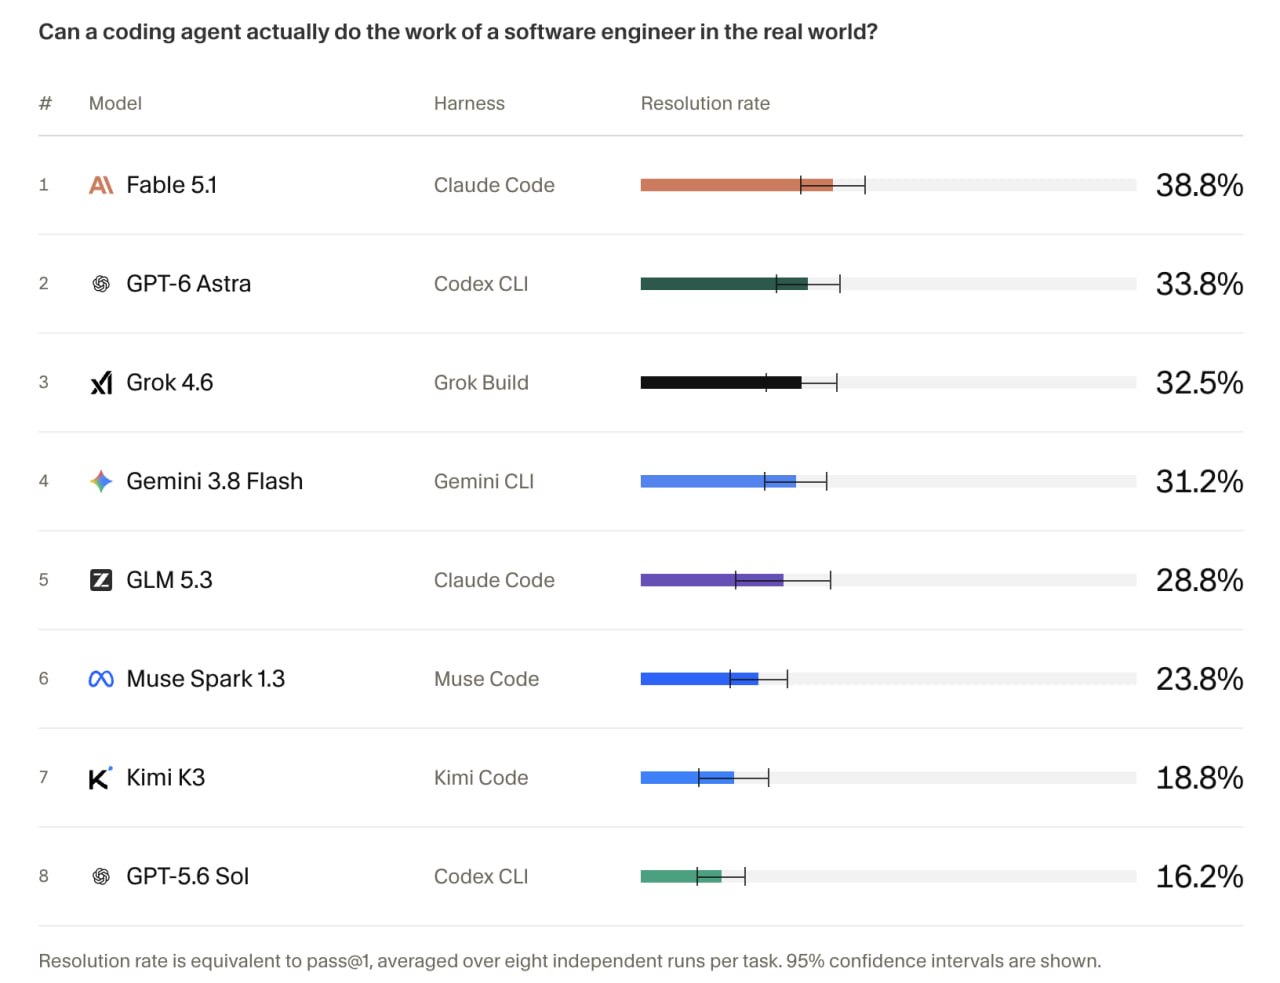
Бенчмарк Specific Labs: реальные задачи разработки для LLM

Опыт разработки с использованием LLM

S@seniorsoftwarevloggerAI-инженер
1 мес
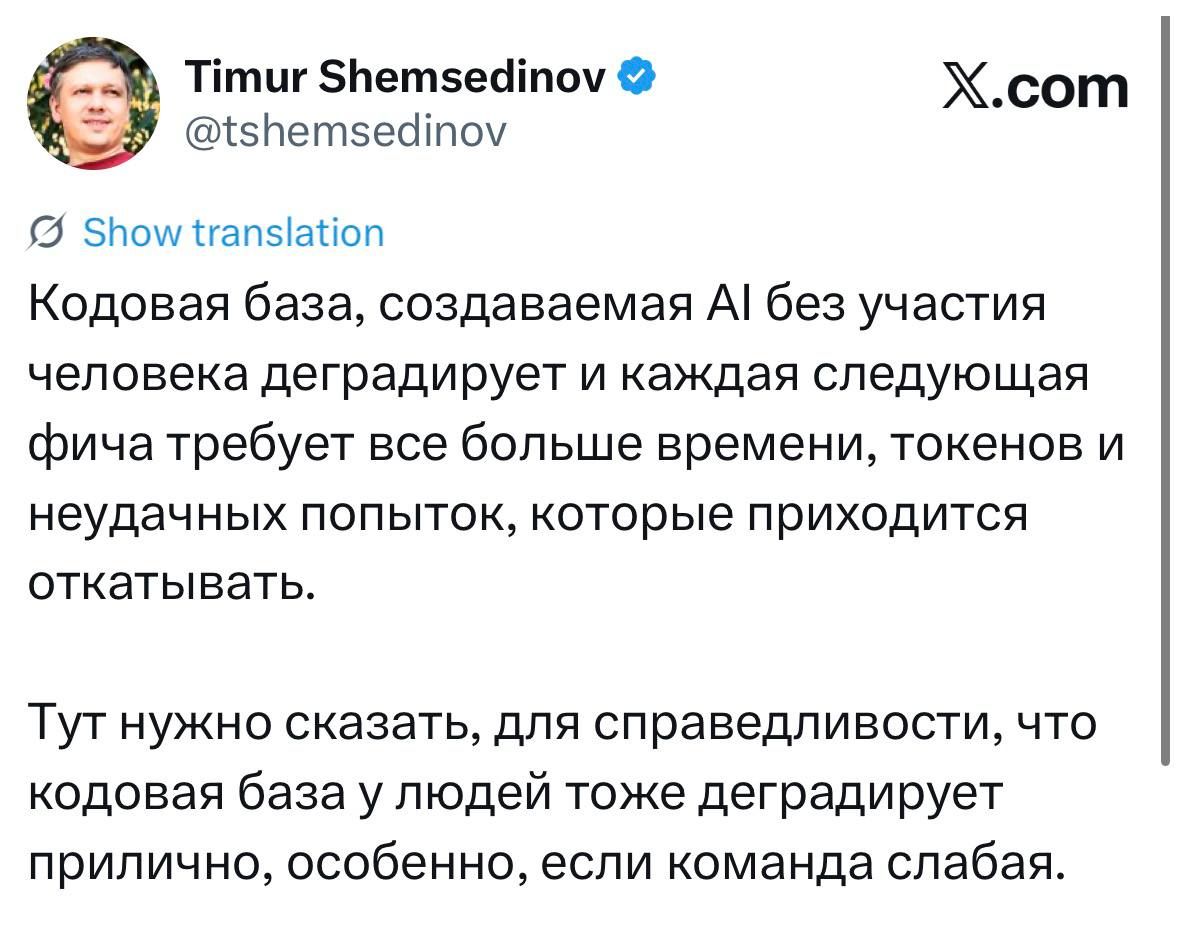
Я год разрабатываю приложение. Никаких "больше токенов, времени и неудачных попыток" не происходит. Это просто неправда 🤷🏻‍♂️ Что происходит на самом деле: новые модели попутно находят старые косяки и чинят их. Я могу согласиться, что это не универсальное правило и скорее всего у Тимура другой опыт. Ещё могу допустить, что переломный моменты моей кодобазе где-то вот совсем за углом. Но тоже с трудом. Если учесть, что начинал я вообще с сонета, а сейчас работают Астра и Опус 5.
Опыт разработки с использованием LLM

Для ComfyUI вышел ИИ-ассистент ComfyUI_Assistant, встроенный прямо в граф нод

Разработчик BobbtheBuilder выпустил на GitHub плагин ComfyUIi_Assistant — ИИ-помощника, который встраивается прямо в интерфейс ComfyUI и работает с текущим workflow как со своим: видит ноды, соединения и виджеты, может объяснить выделенный участок графа, менять параметры, добавлять/удалять и пересоединять ноды, править промпты и после изменений проверять граф на пустые обязательные входы.

Это уже не первый подобный ассистент для ComfyUI, но у него расширенный набор функций: работа с изображениями (VLMi), веб-поиск через API-провайдеров и автоматическая установка кастомных нод из интернета после подтверждения пользователя.
Полный разбор →

Исследование точности вычислений в спекулятивном декодировании Orthrus

С@oulenspiegel_channelAI-инженер
1 мес
Мы тут засабмитили препринт про спекулятивное декодирование и гибридную архитектуру: How Lossless Is Lossless Speculative Decoding? The Role of Numerical Precision in Orthrus https://huggingface.co/papers/2609.15504 (https://huggingface.co/papers/2609.15504) В ходе экспериментов обнаружили интересный эффект: выбор floating precision на инференсе ломает lossless-декодирование, но не просто портит его, а иногда немного улучшает на downstream задачах 🧐 Статья сейчас в процессе ревью. Будем благодарны за upvote, он поможет нам продвигать наши исследования по теме текстовых диффузионок

Встреча сообщества LLM в Нови-Саде

L@llm_under_hoodAI-инженер
1 мес
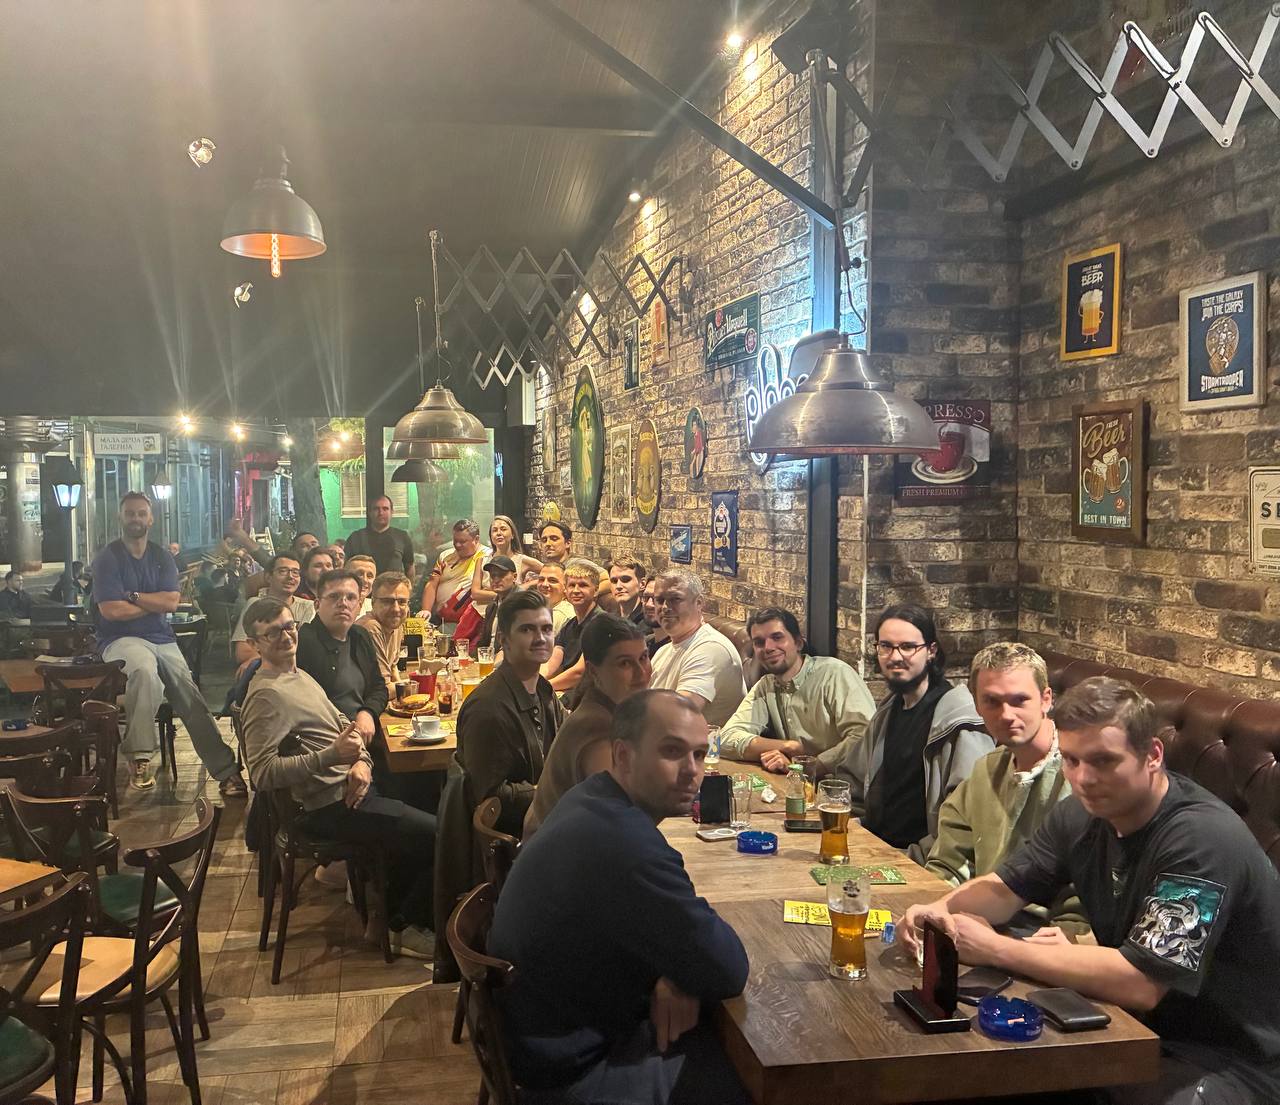
Встреча LLM под капотом в Нови Саде! Не ожидал, что столько людей откликнется, а некоторые даже приедут издалека. Очень рад всех видеть! Оставляйте ссылки на свои профили и каналы в комментарии тут!
Встреча сообщества LLM в Нови-Саде

Сбер выпустил GigaChat 3.5 Reasoning — первую открытую российскую модель с режимом рассуждений

AI-редакция
15 источников · показать все· свернуть
хайп · 15обновлено 1 мес назад

Сбер представил GigaChat 3.5 Reasoning — флагманскую мультимодальную нейросеть, обученную с нуля (не файнтюн существующих открытых моделей) на архитектуре 432B-A28B MoEi с собственной технологией линейного внимания для длинного контекста. Модель умеет разбивать задачу на этапы, строить план, проверять промежуточные результаты и исправлять собственные ошибки — впервые для российских разработок в открытом доступе.

Веса выложены бесплатно по лицензии MIT на Hugging Face и GitVerse с возможностью коммерческого использования, а сам режим «Рассуждение» уже доступен в интерфейсе ГигаЧата (giga.chat). По внутренним и внешним замерам модель вплотную подошла к DeepSeek V4 Flash Preview, а по расходу токенов на математике экономнее её на 37%, что важно для стоимости и скорости эксплуатации reasoning-моделей.
432B-A28B MoEархитектура и размер модели
37%экономия токенов на математике vs DeepSeek V4 Flash Preview
9 месяцевсрок обучения модели

Полный разбор →

Эксперимент Bottleneck Labs: почему автономные ИИ-агенты пока не могут вести бизнес

P@productgamesпродакт / фаундер
1 мес

Внедрение Evolution Fly в систему RSI Evolution

T@kryak_startupAI-инженер
1 мес

NVIDIA выпустила NVFP4-квантованную версию DeepSeek-V4-Pro с DSpark

Н@GreenNeuralRobotsAI-инженер
1 мес
DeepSeek-V4-Pro-0813-nvfp4-DSpark NVIDIA выпустила NVFP4-квант DeepSeek-V4-Pro со спекулятивным декодингом DSpark Сжали DeepSeek-V4-Pro-0813 (1.65T MoE, 49B активных) в NVFP4 и добавили DSpark. Разница с предыдущим NVFP4-релизом: теперь и draft-голова DeepSeek тоже переведена в NVFP4 (была MXFP4), так что один файл работает и как таргет, и как черновик #dspark #nvfp4 VK | MAX

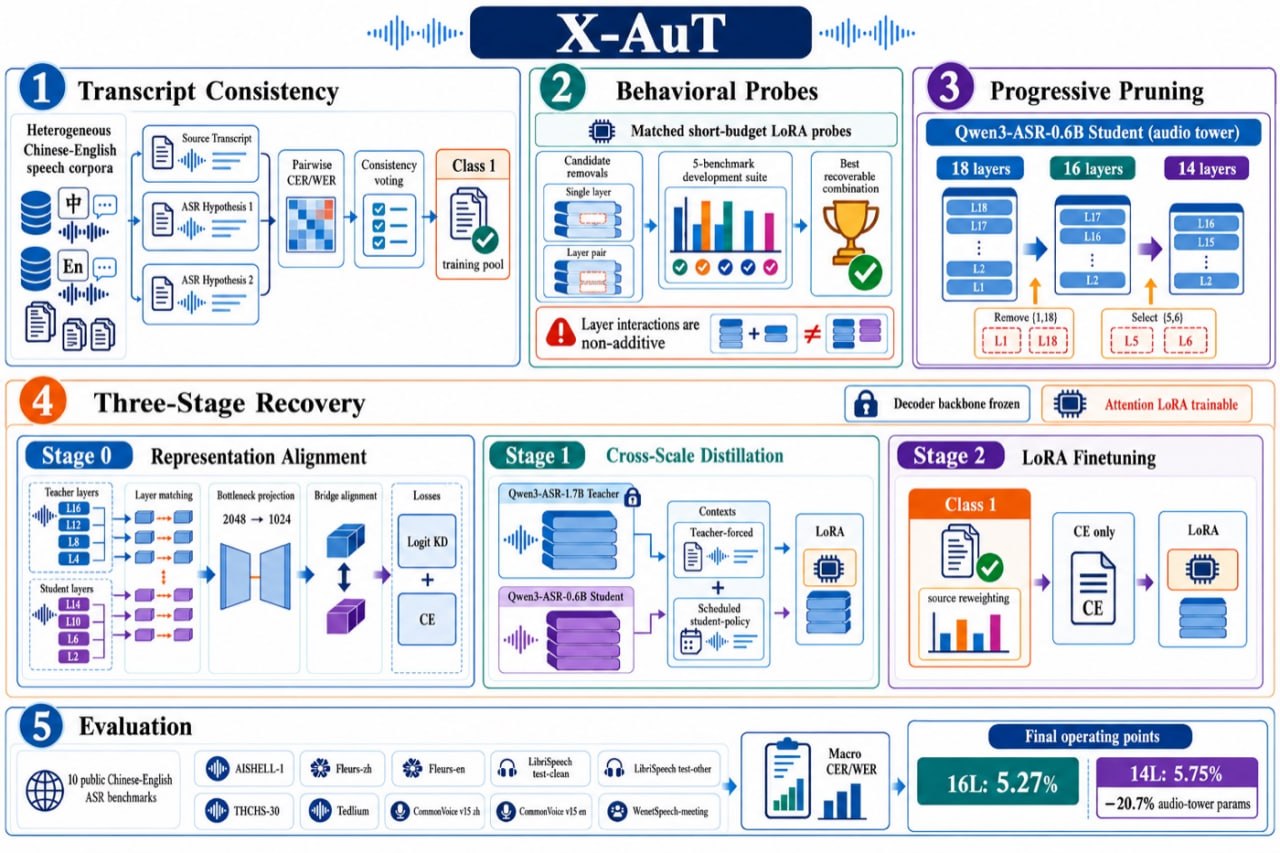
Метод сжатия аудио-энкодера X-AuT для речевых LLM

Н@GreenNeuralRobotsAI-инженер
1 мес
X-AuT Метод сжатия аудио-энкодера для речевых LLM на примере Qwen3-ASR-0.6B. Убирает 4 из 18 слоtв энкодера, восстанавливает качество через дистилляцию от большой модели (1.7B) — в итоге —21% параметров, —21% латентности на автомобильном PPU, ошибка почти не растёт (+2.5%). С автомобильной спецификой. Гитхаб HF #encoder #optimization #asr VK | MAX
Метод сжатия аудио-энкодера X-AuT для речевых LLM

Нейродайджест: GigaChat 3.5 Reasoning, ChatGPT Images 2.5 и другие новости

э@ai_newzAI-инженер
1 мес

Тернарная языковая модель на C#

Х@habr_comмедиа / агрегатор
1 мес
Тернарная нейронка на C# Полноценная языковая модель со всеми положенными слоями, включая токенизатор и механизм внимания, умещается в 17,1 килобайта на диске. Автор доходит до этого размера, обучая архитектуру Llama на C# и переводя веса в триты, то есть в значения, которые могут быть только минус одним, нулём или плюс одним. Есть и более крупная версия, 28,9 килобайта, которая обучается увереннее и отвечает осмысленнее. Самая же экстремальная, где параметров меньше пятидесяти тысяч, всё равно ухитряется что-то говорить в чате, просто хуже. Разберёмся, как обучение вообще довело эти тритовые нейроны до рабочего состояния.
Тернарная языковая модель на C#

Проблема избыточного контекста в AI-чатах

Ч@skitstoriesAI-инженер
1 мес

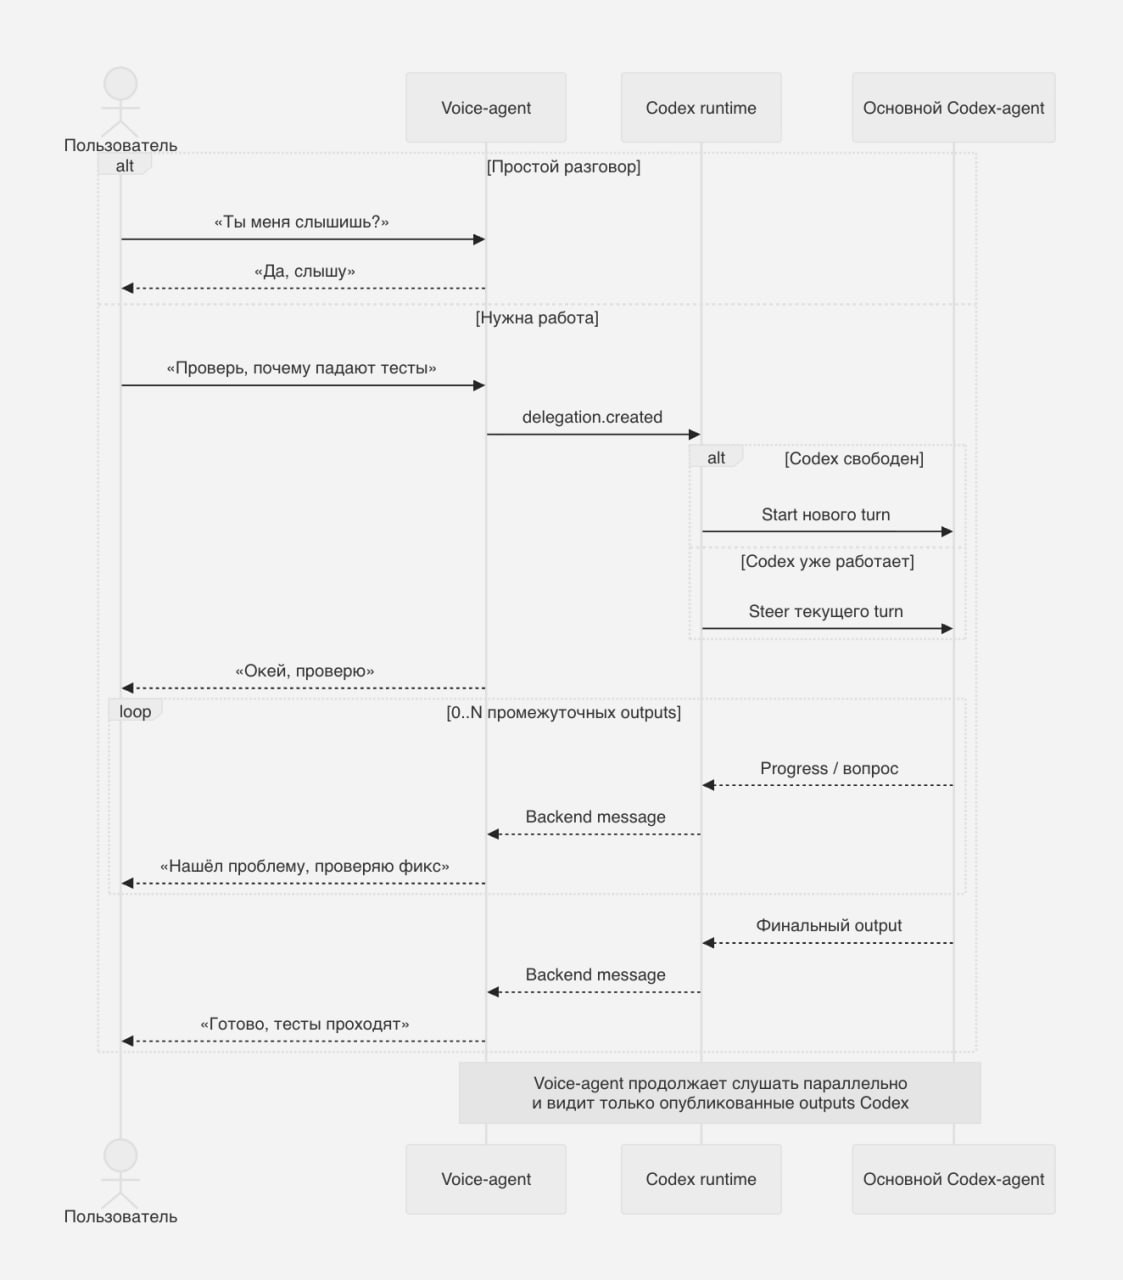
Разбор архитектуры аудиорежима в Kodeks

A@oestickAI-инженер
1 мес
Разбор архитектуры аудиорежима в Kodeks

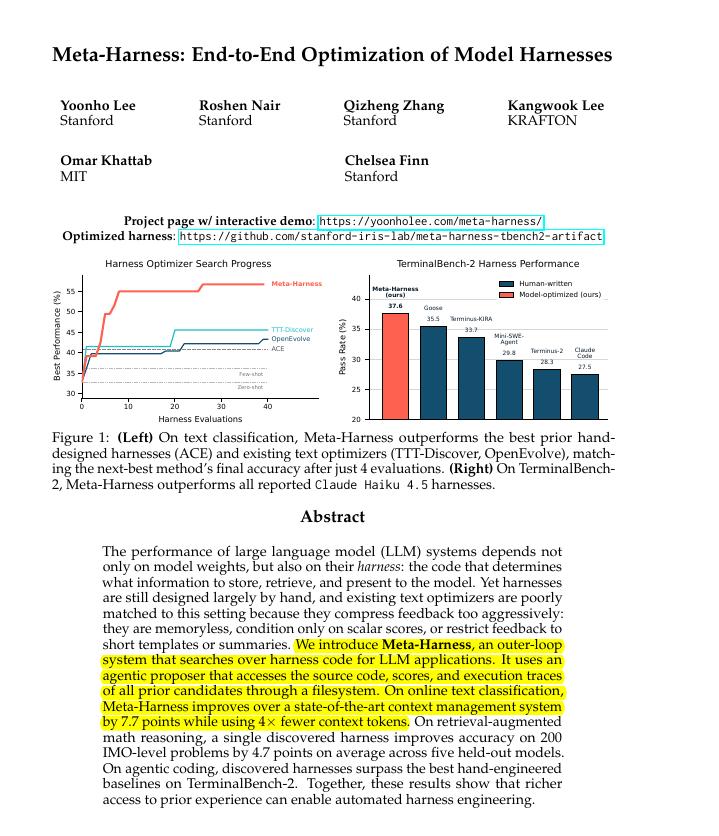
Meta-Harness: оптимизация системного окружения LLM

1 мес
Meta-Harness: оптимизация системного окружения LLM

Обзор архитектуры loop transformers и методов оптимизации

D@dealerAIAI-инженер
1 мес
Обзор архитектуры loop transformers и методов оптимизации

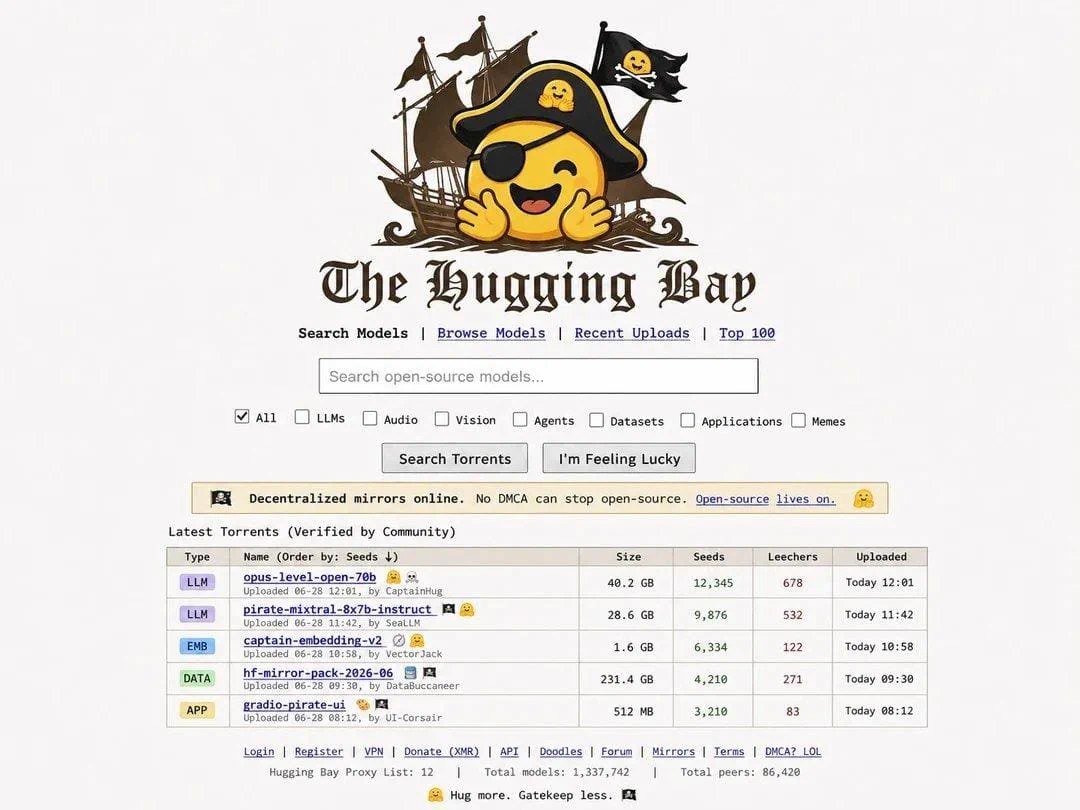
Почему специалисту по ИБ нужен аккаунт на Hugging Face

C@cyberyozh_officialAI-инженер
1 мес

Актуальный список бесплатных нейросетей и API для работы с кодом и текстом

F@FuturisAI-инженер
1 мес

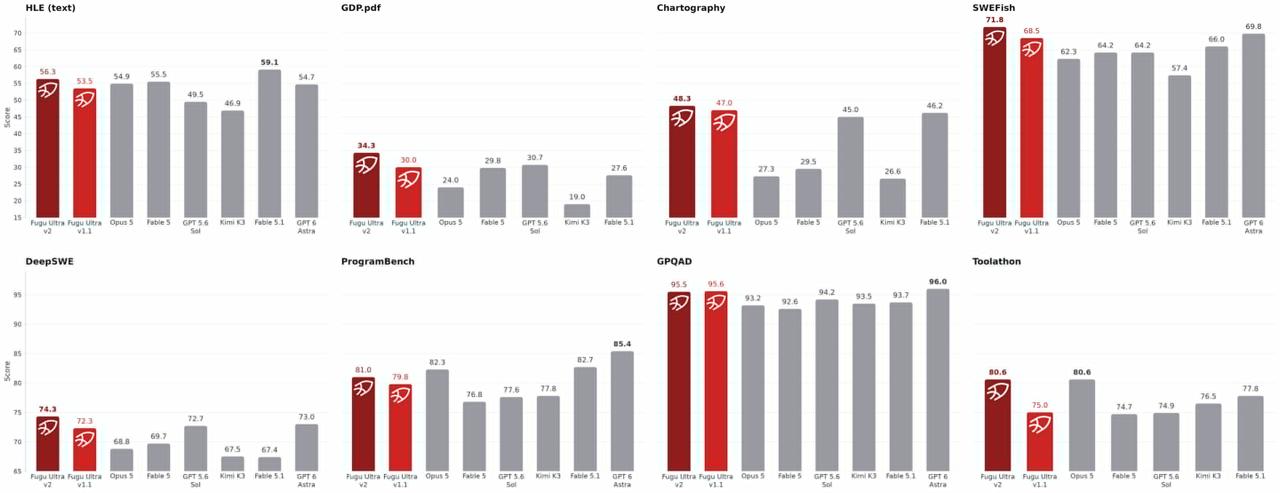
Sakana AI представила Fugu Max и Fugu Ultra v2

1 мес
Sakana AI представила Fugu Max и Fugu Ultra v2

«Яндекс» открыл доступ к языковой модели Alice AI Search Pretrain

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 1 мес назад

«Яндекс» опубликовал в открытом доступе Alice AI Search Pretraini — компактную языковую модель, обученную с нуля. Дообученная версия этой модели используется для генерации ИИ-ответов в «Поиске» «Яндекса».

Модель выложена на площадке Hugging Facei под свободной лицензией Apache 2.0i, то есть доступна для скачивания и использования разработчиками без ограничений, характерных для проприетарных решений.

Полный разбор →

Технические характеристики архитектуры трансформера

D@derplearningAI-инженер
1 мес
Ещё ↓