Бенчмарк Specific Labs: реальные задачи разработки для LLM
A@ai_productAI-инженер
1 месАнализ производительности LLM на закрытых корпоративных репозиториях: Fable 5.1, GPT-6 Astra и другие модели в задачах реального продакшена.
LLM пока не готовы к полноценной замене разработчиков в сложных корпоративных проектах.
- Модели часто не понимают контекст архитектуры и пропускают требования ТЗ.
- Даже лидеры рынка решают менее 40% задач в реальных условиях.
- Стоимость автоматизации сложных задач остается высокой при низкой надежности результата.
Свежие бенчмарки моделей на кодинге (для очередных дискуссий, Claude vs Codex)
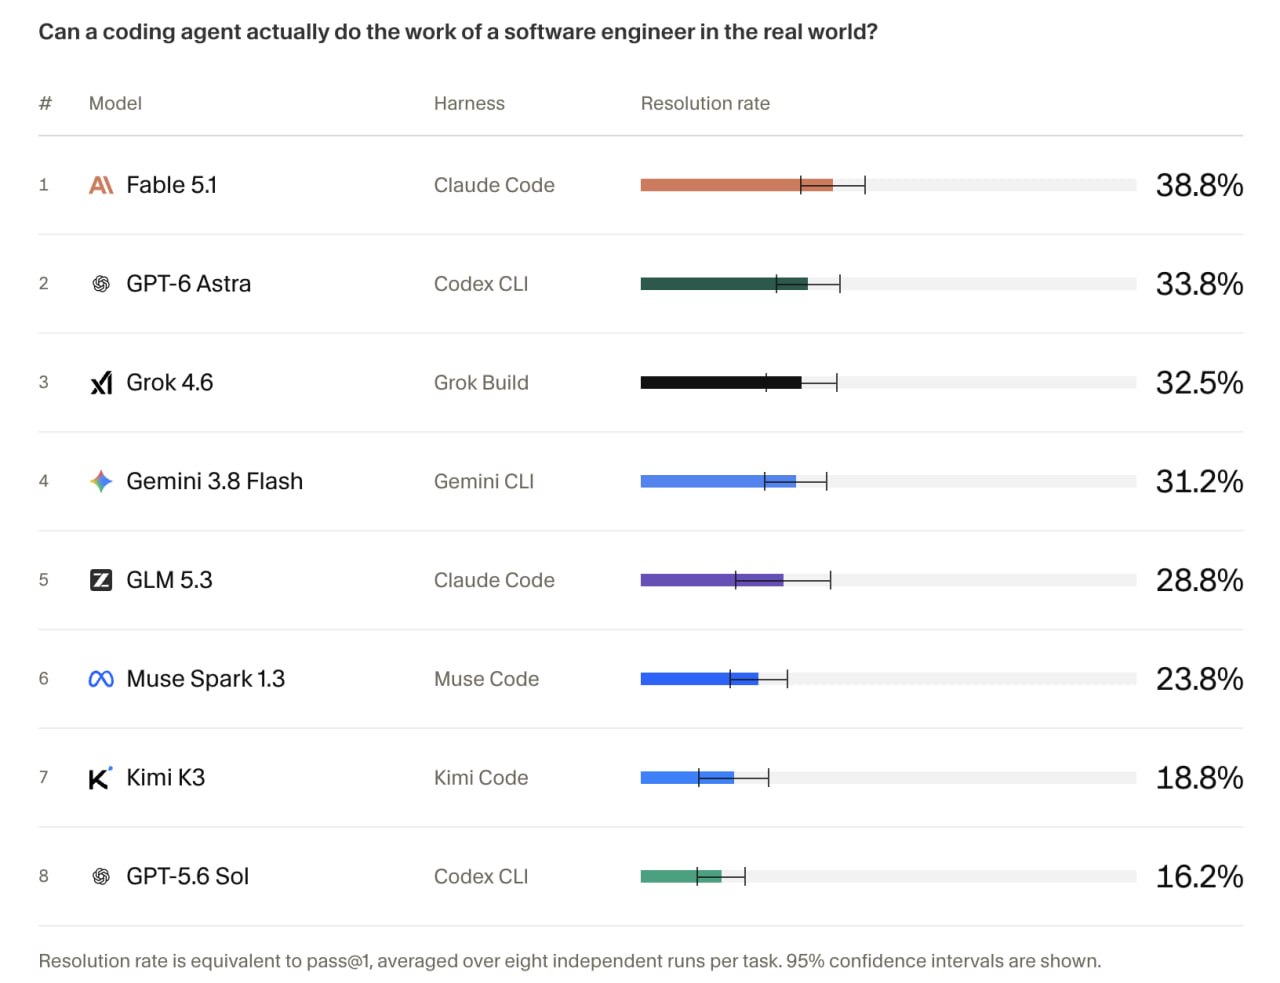
Specific Labs выпустили бенчмарк, где модели чинят не задачки с GitHub, а настоящий код реальных компаний – лицензировали приватные репозитории (клон Partiful на 200K+ юзеров, финтех со 100K+ банковскими выписками, enterprise sales-платформы) и взяли оттуда живые задачи: налоги в инвойсах, миграции биллинга, метеринг токенов. Код в интернете не лежит, модели на нём не учились. Результат отрезвляет.
– Лидер – Fable 5.1 в Claude Code, 38.8% решённых задач
– GPT-6 Astra в Codex – 33.8%, Gemini 3.8 Flash – 31.2%
– GLM 5.3 – 28.8%, Grok 4.6 и Muse Spark 1.3 – по 23.8%, Kimi K3 – 18.8%
– GPT-5.6 Sol – 16.2%
– 6 из 10 задач решаются реже чем в 15% случаев, одну (analytics stream reducer) не решил никто ни разу
– Медианное решение трогает 11 файлов – против 6 в FrontierCode и DeepSWE
– Цена одного прогона: Gemini Flash $2.50, GPT-6 Astra $4.67, Fable 5.1 $6.96
Интересно, как модели проваливаются. Главная причина – пропущенные требования из ТЗ (у Grok – 67% всех фейлов). Вторая – «не проверил, придумал» – так падает 43% неудачных прогонов GPT-5.6. Третья – правильная идея, криво встроенная в систему (Gemini – 49%). Причём короткие прогоны до 10 минут фейлятся с той же частотой, что и длинные – проблема не во времени, а в том, что агент не понял, как устроена компания и её код.
Короче, разработчика могут заменить пока только в трети случаях. Но тут надо сказать, что описание компании и кодовых принципов в claude.md/agents.md никто не писал, это такой чисто "вайбкодинг-стайл" тест. Должно быть сильно лучше при правильном подходе.
https://withspecific.com/benchmarks/real-swe
Кратко (AI)
Компания Specific Labs представила бенчмарк, тестирующий LLM на реальных задачах из закрытых корпоративных репозиториев, а не на публичном коде. Результаты показывают, что даже лучшие модели решают менее 40% задач, часто допуская ошибки из-за непонимания архитектуры проекта и игнорирования требований ТЗ.
Обсуждение
2наконец бенчмарк не на синтетике, а на реальном коде. и самое интересное там не проценты решённых задач, а причина фейлов: агенты не тупят от нехватки времени, они просто не понимают контекст компании. так что следующий рывок будет не про мощность моделей, а про то как нормально описать конвенции и архитектуру в claude.md. вот куда всем стоит смотреть в этом году
ну так и понятно было, что без claude.md агент не поймет, как у компании все устроено - бенчмарк это просто зафиксировал. и вот это "следующий рывок в md-файлах, а не в мощности моделей" - тоже не открытие, а просто признание, что раньше все тестили на вайбкодинге