Концепция «Прилобота»: интеграция LLM и CRM в Telegram Mini Apps
Г@badproductsпродакт / фаундер
1 мес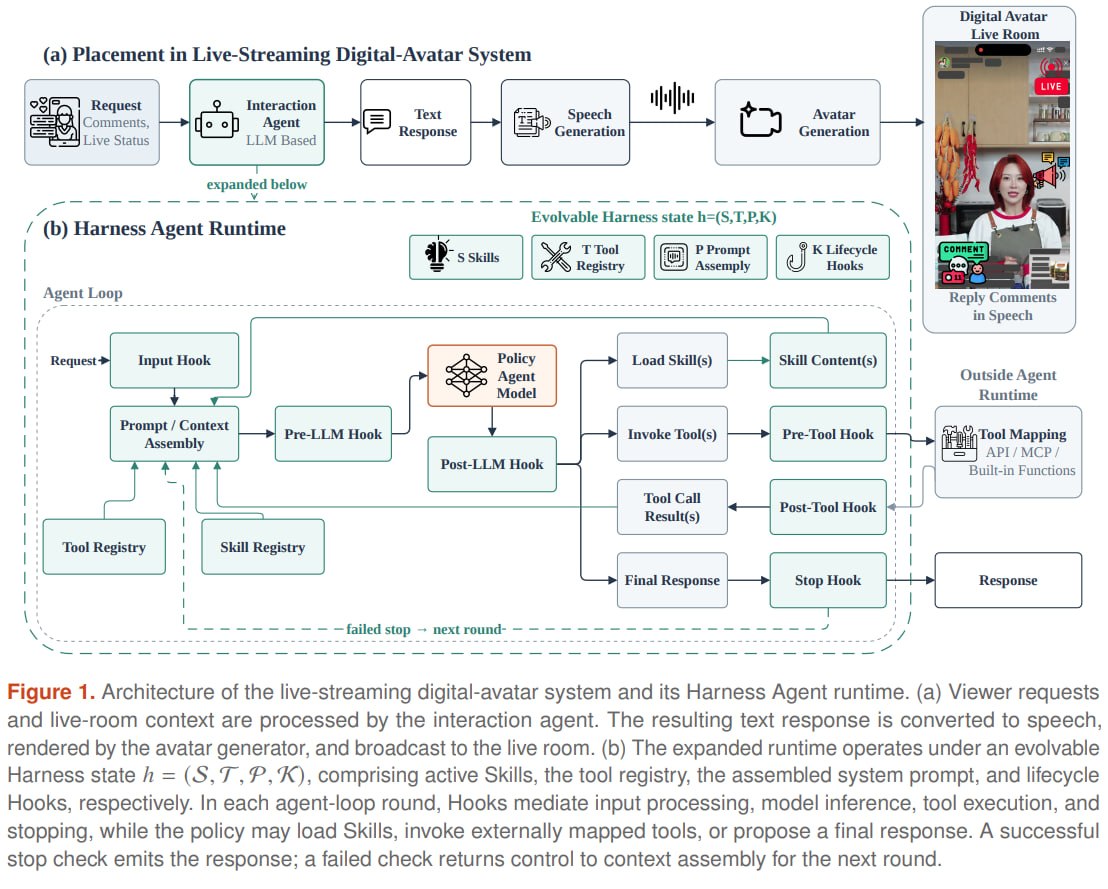
Если «го», делаю прямо сейчас, займёт около часа с проверкой.Какой нафиг час, голова ты кремниевая. Ты же просто баш скрипт запустишь с заменой двух строк текста. Час бы ты даже не проработал, потому что на этот нейрослоп все мои токен лимиты бы сожрал! Надежда вся на новую Астру, потому что по слухам она этим перестала страдать. И да, Сама, я тебе 200 баксов в месяц плачу, чтобы ты мне ролауты новых моделей с задержкой делал? 🔫
В конце августа — начале сентября 2026 года независимые разработчики и энтузиасты одновременно выпустили серию GGUFi-квантизаций флагманских открытых LLM (Qwen3.8-27B, GLM-5.3, DeepSeek-V4-Flash) с технологиями ускорения инференса DFlash2i и DSpark drafter, а также несколько версий этих моделей со снятой цензурой («abliteratedi»/«uncensored»).
Расцензуренные версии позиционируются авторами не для развлечения, а для практических задач: ред-тиминга, кибербезопасности и автономных агентов, которым мешает встроенный механизм отказа отвечать на запросы.
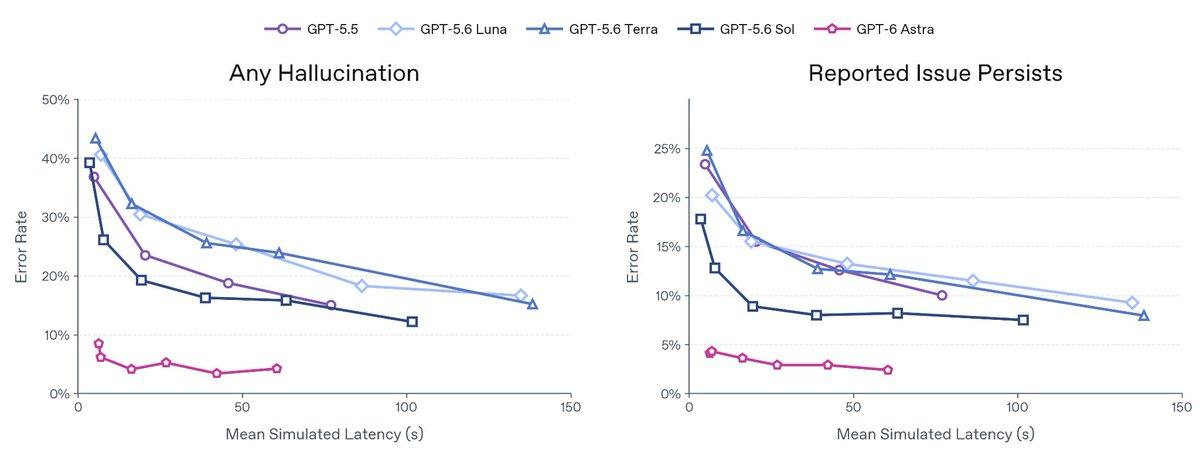
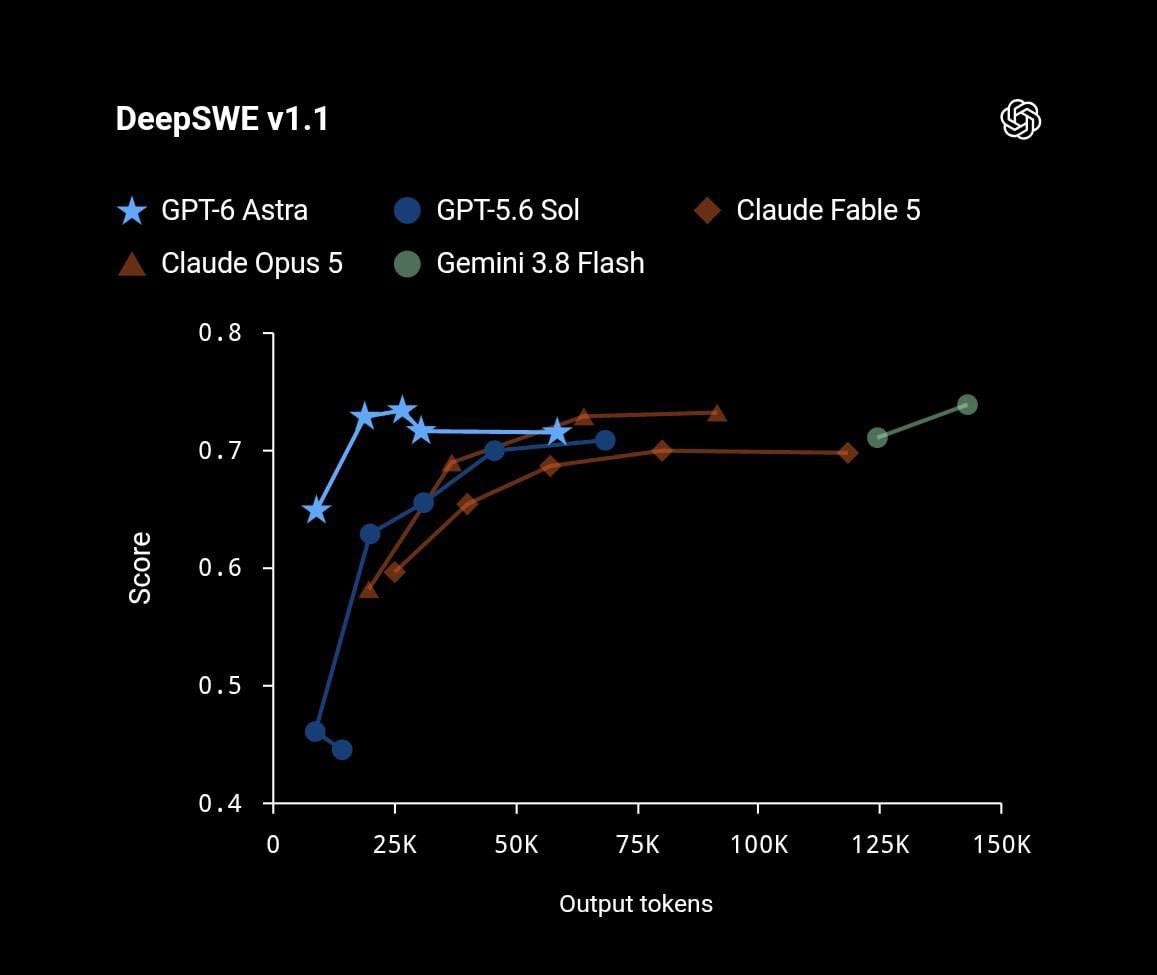
Meta (признана экстремистской и запрещена в России) представила Muse Spark 1.3 — обновление флагманской модели для программирования и агентных задач. Модель уже доступна в ИИ-агенте для написания кода Muse Codei и через Meta Model API.
По сравнению с версией 1.2 модель заметно экономнее по ресурсам при росте качества: на 20% меньше вызовов инструментов и на 25% меньше токенов при том же результате. По бенчмаркам Meta ставит модель в один ряд с GPT-5.6 Sol и Claude Opus 5, а по некоторым тестам (особенно длинный контекст и код) — выводит в лидеры.
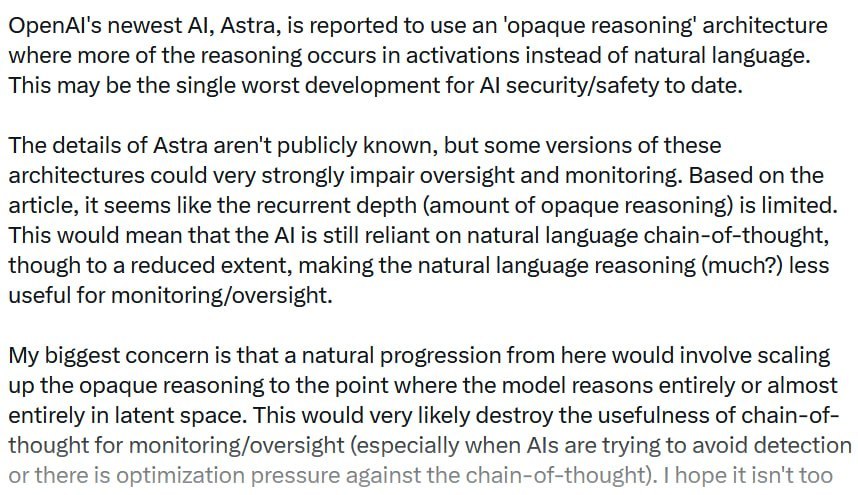
Google представила Gemini 3.8 Flash — обновлённую быструю модель с упором на агентный кодинг, веб-поиск, отладку и тестирование приложений. Это уже третье обновление линейки Flash за полтора месяца (после 3.6 и 3.7 Flash), и релиз явно приурочен к обострению гонки с OpenAI и Anthropic: на той же неделе выходят GPT Astra, Grok 4.7, Fable 5.1 и китайский Qwen3.8-Max-0902.
По данным WSJ, инженеры Google во внутреннем инструменте для программирования Jetskii предпочитали ответы Gemini 3.8 Flash модели Claude Opus 5, а на ряде агентных и кодинг-бенчмарков дешёвая Flash-модель почти догнала гораздо более дорогие флагманы — при цене в 6–7 раз ниже. Одновременно вышла закрытая Gemini 3.8 Flash Cyber для поиска уязвимостей в коде, доступная только избранным организациям.