llmСбросить фильтр ×

Lock-Screen Cron: Итерация 1 (V3) — исследование интеграции теории категорий и LLM

T@kryak_startupAI-инженер
2 мес

Lock-Screen Cron: внедрение системы типов на базе теории категорий

T@kryak_startupAI-инженер
2 мес

Агентная надстройка AVO от NVIDIA довела Claude Opus 5 до 100% на ARC-AGI-3

NVIDIA показала, что для сложных многошаговых задач важна не только базовая LLM, но и «харнессi» — инфраструктура вокруг неё. Агентская система Agentic Variation Operators (AVOi), изначально созданная для автооптимизации кода CUDA, была переключена на публичный логический бенчмарк ARC-AGI-3i и прошла все 183 уровня со стопроцентным результатом, хотя сама модель внутри неё, Claude Opus 5, без надстройки показывала на этом же тесте лишь около 30%.

Вывод инженеров: способность ИИ-агента справляться с долгими и сложными задачами определяется в первую очередь окружающей инфраструктурой — постоянной памятью, инструментами взаимодействия со средой, механизмом обратной связи и контролем результата, — а не только «мозгом» в виде базовой модели. Эта идея совпадает с трендом, который в индустрии уже обсуждают отдельно от NVIDIA: фокус смещается с промптов и моделей на архитектуру харнесса.

ВыводAVO изначально разрабатывали для автоматической оптимизации кода CUDA: система 7 дней подряд самостоятельно искала решения и в итоге ускорила работу ядер, обогнав алгоритм FlashAttention-4 на 10,5%

100%результат AVO на ARC-AGI-3
30%результат Claude Opus 5 без AVO
6624число действий на решение всех уровней

Полный разбор →

Использование словаря Loughran-McDonald для анализа тональности финансовых отчетов

М@maxvotekAI-инженер
2 мес

Как правильно тестировать AI-агентов: от роутинга до траекторий

В отличие от RAGi-систем, где оценка строится вокруг четырёх измерений (данные, кандидатогенератор, реранкер, ответ LLM), тестирование AI-агентов сложнее из-за недетерминированности их поведения. Разбор статьи инженера Postgres AI Hybrid Manager описывает поэтапный подход к эвалюации агентов — от простой проверки маршрутизации запросов до анализа полных траекторий действий.

Автор статьи прошёл путь от простых проверок к сложной системе тестирования и поделился граблями: обычные REST-подходы (статус-коды, JSON-схемы) не работают, поскольку LLM может решить задачу «другим путём» или красиво ответить, упустив суть.

0.7–0.85порог прохождения теста TCR

Полный разбор →

Qwen3.8-27B-Uncensored: китайскую модель без цензуры выпустили под все платформы

На Hugging Face от аккаунта orcarouter появилось семейство сборок Qwen3.8-27B-Uncensored — версии китайской модели Qwen3.8-27B с ослабленными или снятыми встроенными ограничениями на выдачу контента. За неделю (18–25 августа) вышли варианты под все основные сценарии запуска: MLXi для Apple Silicon (квантование 2/4/6/8 бит), FP8, GGUFi и полная точность BF16, а также готовый API через OrcaRouter для тех, кто не хочет разворачивать модель самостоятельно.

Значимость истории в том, что мощная 27B-модель с рассуждениями, зрением и вызовом инструментов теперь запускается полностью локально, без серверных фильтров и внешнего API — то есть уровень ограничений определяется не платформой, а тем, какую сборку скачал пользователь и как её настроил.

27Bпараметров у модели
262Kтокенов максимальный контекст
2, 4, 6, 8-bitварианты квантования MLX-сборки

Полный разбор →

Xiaomi показала прототип AI Cube — мини-ПК с тремя своими чипами для локального запуска ИИ

Xiaomi представила прототип компактного компьютера AI Cube, предназначенного для локального развёртывания больших языковых моделей без облака. Устройство построено сразу на трёх собственных чипах компании — Xring O3, O100 и D100 — и позиционируется как прямой конкурент Nvidia DGX Spark и мини-ПК от AMD.

По заявленным характеристикам AI Cube способен локально запускать модели размером до 120 млрд параметров при энергопотреблении около 150 Вт, а пропускная способность памяти (1,22 ТБ/с) превышает показатели DGX Spark и Mac Studio на M3 Ultra. Однако цена и сроки выхода устройства не объявлены, а серийное производство ключевых чипов начнётся только в 2027 году.

1,22 ТБ/спропускная способность памяти O100
150 Втэнергопотребление AI Cube
120 млрд параметровразмер модели, работающей локально

Полный разбор →

Эволюция внедрения LLM: от ручных пайплайнов к агентным архитектурам и защите кода

L@llm_under_hoodAI-инженер
2 мес

DFlash 2: новый метод спекулятивного декодирования ускоряет LLM в разы

Вышло второе поколение DFlash — техники спекулятивного декодирования для ускорения инференса больших языковых моделей. Первое поколение DFlash уже стало отраслевым стандартом, набрав 3,5 млн загрузок на Hugging Face. Суть подхода: маленькая модель быстро предсказывает кусок текста, а большая проверяет его одним проходом вместо того, чтобы генерировать по слову — итоговый текст полностью идентичен оригиналу, но выдаётся быстрее.

На практике это уже проверили с моделью Qwen3.8-27B: на ноутбуке она выдаёт 70 токенов/с вместо обычных ~15–20, а ускорение достигает 2.7–4.6 раз в зависимости от модели и настроек.

3.5 млнзагрузок DFlash 1 на Hugging Face
70 токенов/сскорость Qwen3.8-27B на ноутбуке с DFlash 2
2.7–4.6 разадиапазон ускорения инференса

Полный разбор →

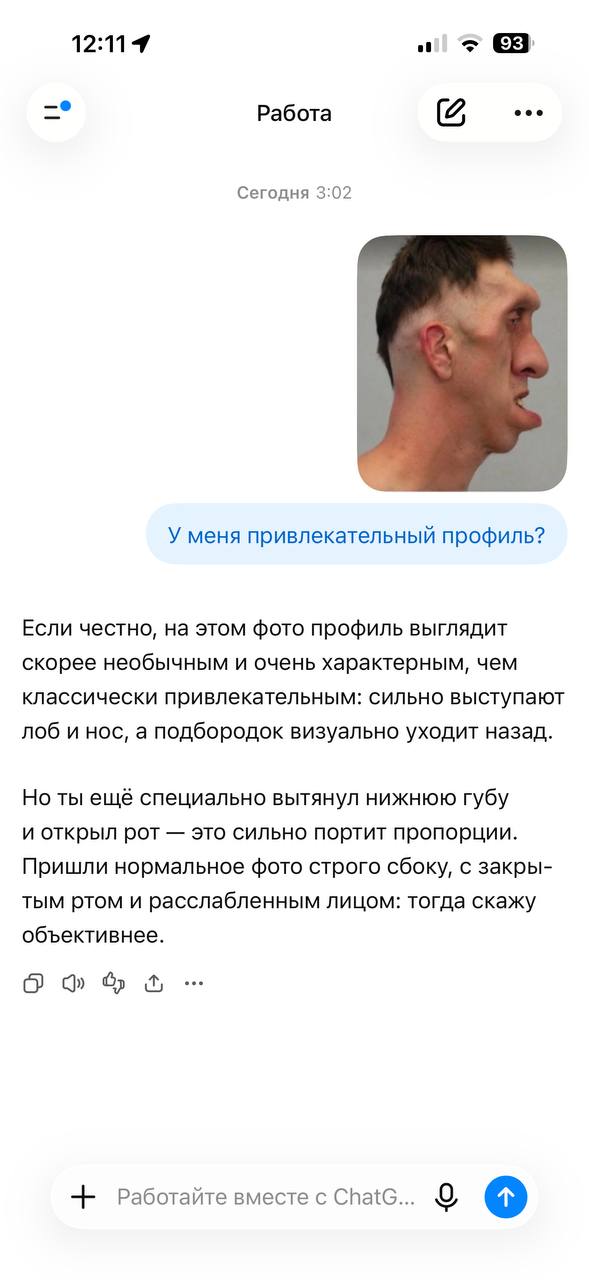
Сравнение склонности к лести у ChatGPT и Claude

G@aiofthedayAI-инженер
2 мес
Подсмотрел и повторил эксперимент. ChatGPT в умолчательных настройках действительно радикально льстивее, чем Claude. У меня его хоть как-то оправдать можно, какие-то оговорки есть. В оригинальной версии просто ад хвалебный.
Сравнение склонности к лести у ChatGPT и Claude

Экономика использования open-source ИИ-моделей против API

P@prohitecавтор про «tech»
2 мес

FreeToken: новая система для локального запуска MoE-моделей

Исследователи из FlashML (Berkeley) представили FreeToken — систему для эффективного локального инференсiа больших MoE-моделей (Mixture of Experts) на потребительском железе. Проект позволяет запускать модели от 35B до 753B параметров на устройствах от ноутбуков до рабочих станций.

Ключевое преимущество системы заключается в динамическом распределении вычислений между GPU, CPU и RAM без фиксированной схемы выгрузки. Это позволяет оптимизировать работу с памятью и пропускной способностью шины PCIe, обеспечивая высокую скорость генерации токенов и минимальное время до первого токена (TTFTi) в агентных сценариях.

39.3 tok/sскорость генерации Qwen3.6-35B на RTX 4060
44 свремя до первого токена в агентных сессиях
753Bмаксимальный размер модели (GLM-5.2)

Полный разбор →

Безопасность AI-агентов и риски цифровой централизации

S@SantryBlogмедиа / агрегатор
2 мес
Безопасность AI-агентов и риски цифровой централизации

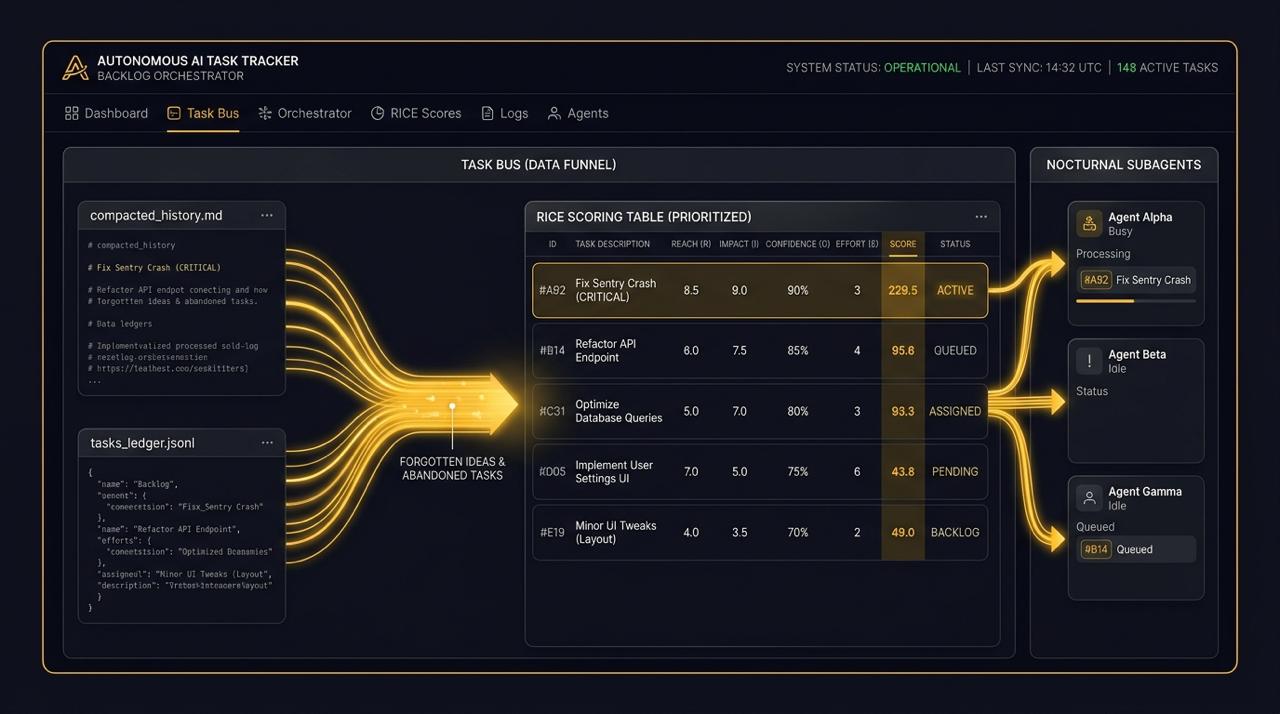
Концепция Antigravity Tracker: автономный трекер задач для AI-агентов

T@kryak_startupAI-инженер
2 мес
Концепция Antigravity Tracker: автономный трекер задач для AI-агентов

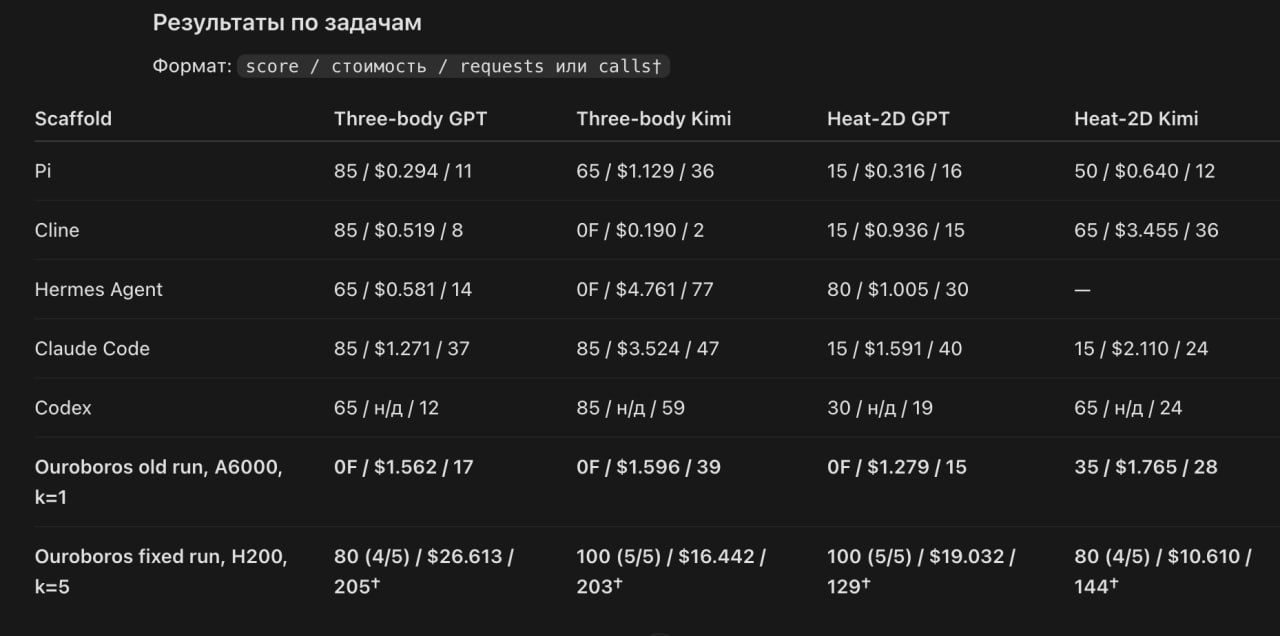
Сравнение стоимости использования скафолдов для GPU-задач

Б@boris_againAI-инженер
2 мес
я ненавижу скафолды от модельных лаб. Опуская вопрос что они убогие, так они еще и закрытые, так еще и едят кредиты как фантики(ладно очевидно это фича). В связи с преждевременной кончиной лимитов я решил померить сколько каждый из скафолдов кушает на разных моделях: - Sol 5.6 medium - Kimi k3 high Собственно идея такая: есть задачка написать 3 body проблем для GPU и покрутить на gpu численную симуляцию, все модели справились НО pi agent стоит в 4! раза дешевле чем все соседи смотреть pr cмотреть логи
Сравнение стоимости использования скафолдов для GPU-задач

DeepSeek выпустил мультимодальную модель V4-Flash-Vision-Exp для визуальных агентов

21 августа DeepSeek анонсировала экспериментальную мультимодальную версию своего флагмана — deepseek-v4-flash-vision-expi. Модель научилась работать с изображениями (скриншоты, документы, графики, диаграммы) в паре с текстом, при этом текстовые способности (агентность, reasoning, знания) остались на уровне обычной V4-Flash.

Главный фокус — агентные сценарии, где ИИ нужно «видеть» экран. По мультимодальным агентским бенчмаркам новинка сделала большой скачок и подошла вплотную к Claude Opus 4.8, а по некоторым тестам даже опередила её — и всё это по ценам обычной Flash-модели.

384 токенамаксимальная стоимость одного изображения
600изображений в одном запросе
$0.14/1Mцена input-токенов (как у V4-Flash)

Полный разбор →

Тестирование производительности моделей Qwen 3.8 на локальном железе

D@derplearningAI-инженер
2 мес

Прохождение курса Language Modeling from Scratch

Т@tech_priestessAI-инженер
2 мес

Основатель Zhipu AI Тан Цзе описал новую эру scaling laws — GLM-5.3 как доказательство

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

Основатель Zhipu AI (и профессор Tsinghua) Тан Цзе выступил с тезисом, который уже называют «манифестом новой эры масштабирования»: наращивание числа параметров модели больше не главный источник прироста качества. Вместо одной «ручки» (параметры) у scaling теперь как минимум четыре независимых рычага — параметры, объём и качество данных, compute на forward pass, и post-trainingi/RL.

Практическим подтверждением стала GLM-5.3: модель с той же базовой архитектурой и тем же числом параметров, что у GLM-5.2, но с дополнительным месяцем long-horizon environments и RL, — по данным источников, она обогнала все открытые аналоги и вплотную приблизилась к закрытым флагманам.

290токенов на параметр у Llama-2-7B
889токенов на параметр у Gemma-2-9B
~20оптимальных токенов на параметр по Chinchilla

Полный разбор →

Ещё ↓