aiСбросить фильтр ×

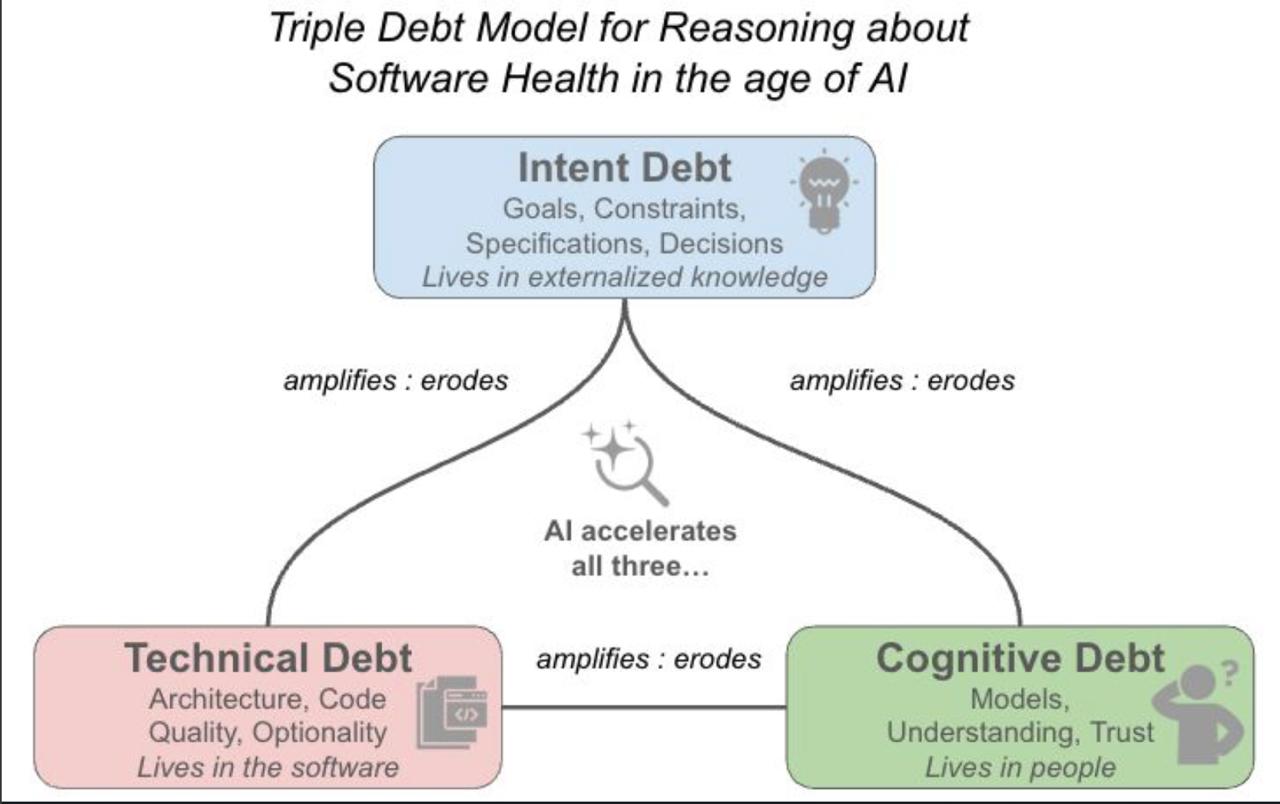
Модель тройного долга в эпоху AI-разработки

П@badTechProjectAI-инженер
2 мес
Модель тройного долга в эпоху AI-разработки

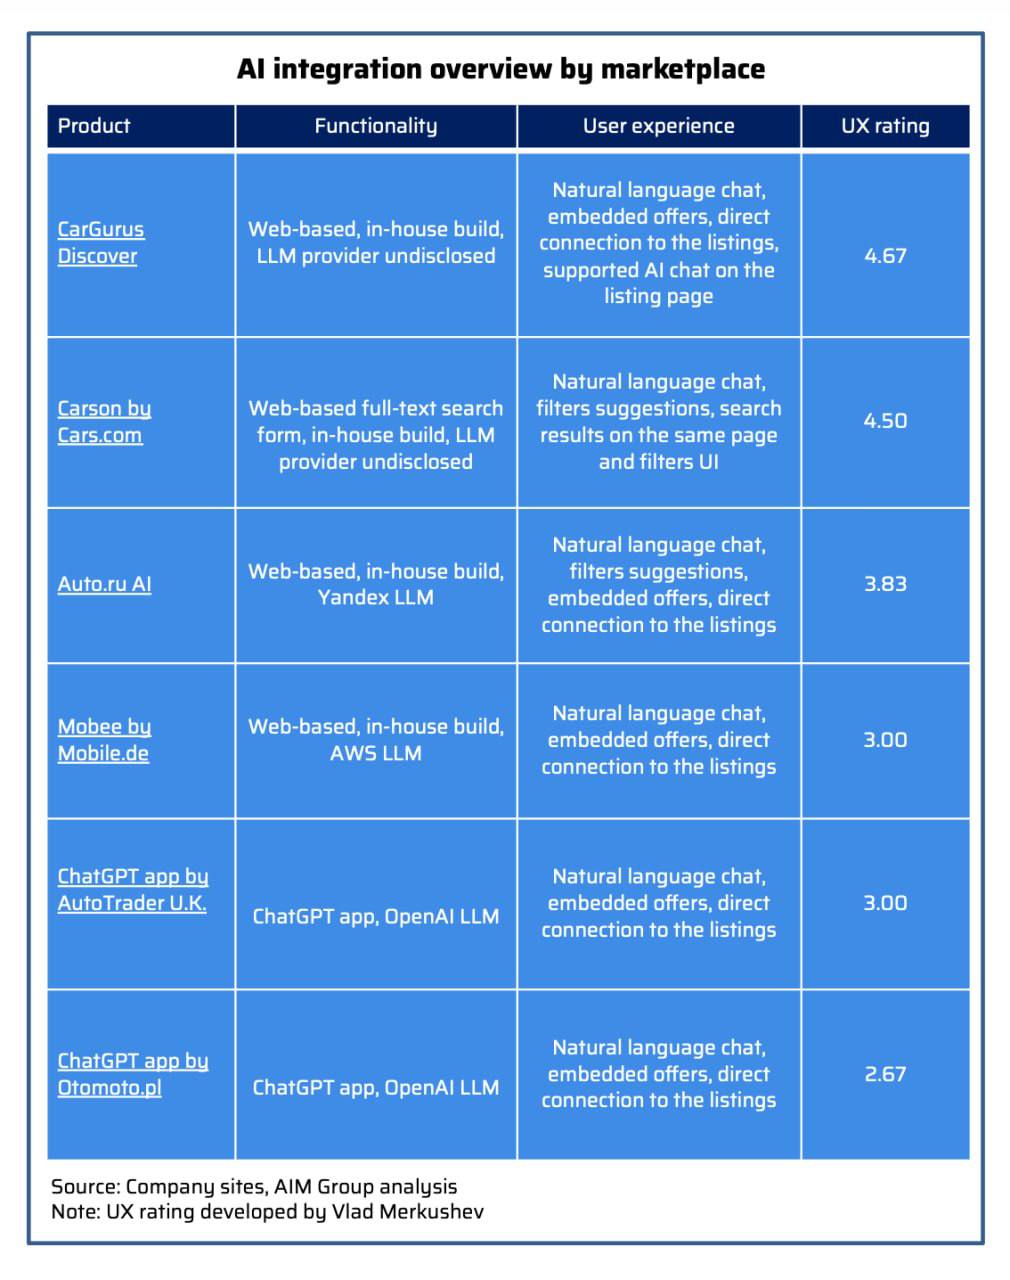
Адаптация автомаркетплейсов к эпохе AI-помощников

П@vladimir_merkushevпродакт / фаундер
2 мес
Адаптация автомаркетплейсов к эпохе AI-помощников

Кризис венчурного рынка и смена парадигмы предпринимательства в эпоху AI

C@chillhousetechAI-инженер
2 мес

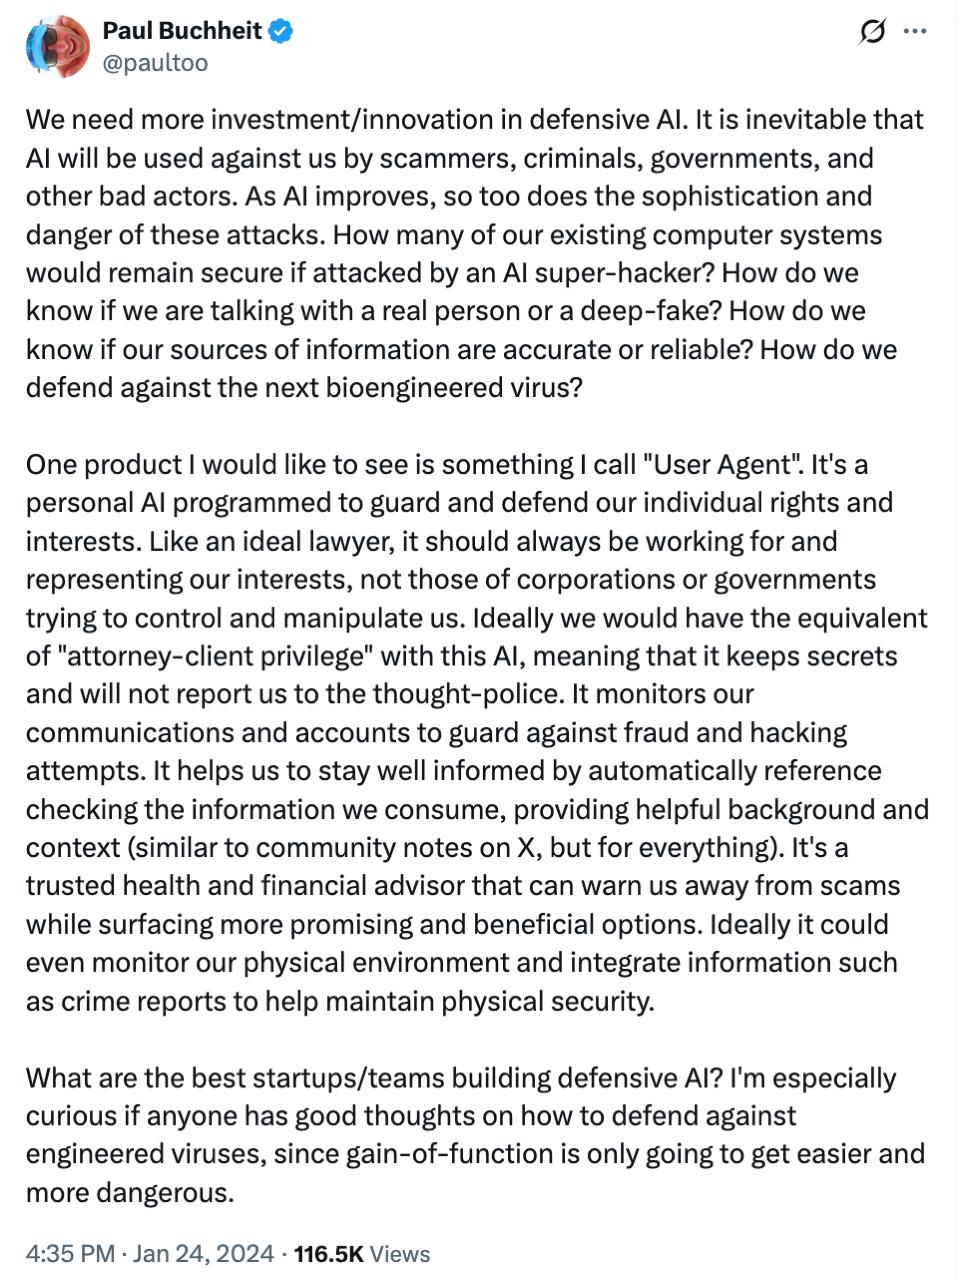
Пол Букхейт о необходимости защитного ИИ и персональных агентов

Х@yclibraryавтор про «startups»
2 мес
Пол Букхейт о необходимости защитного ИИ и персональных агентов

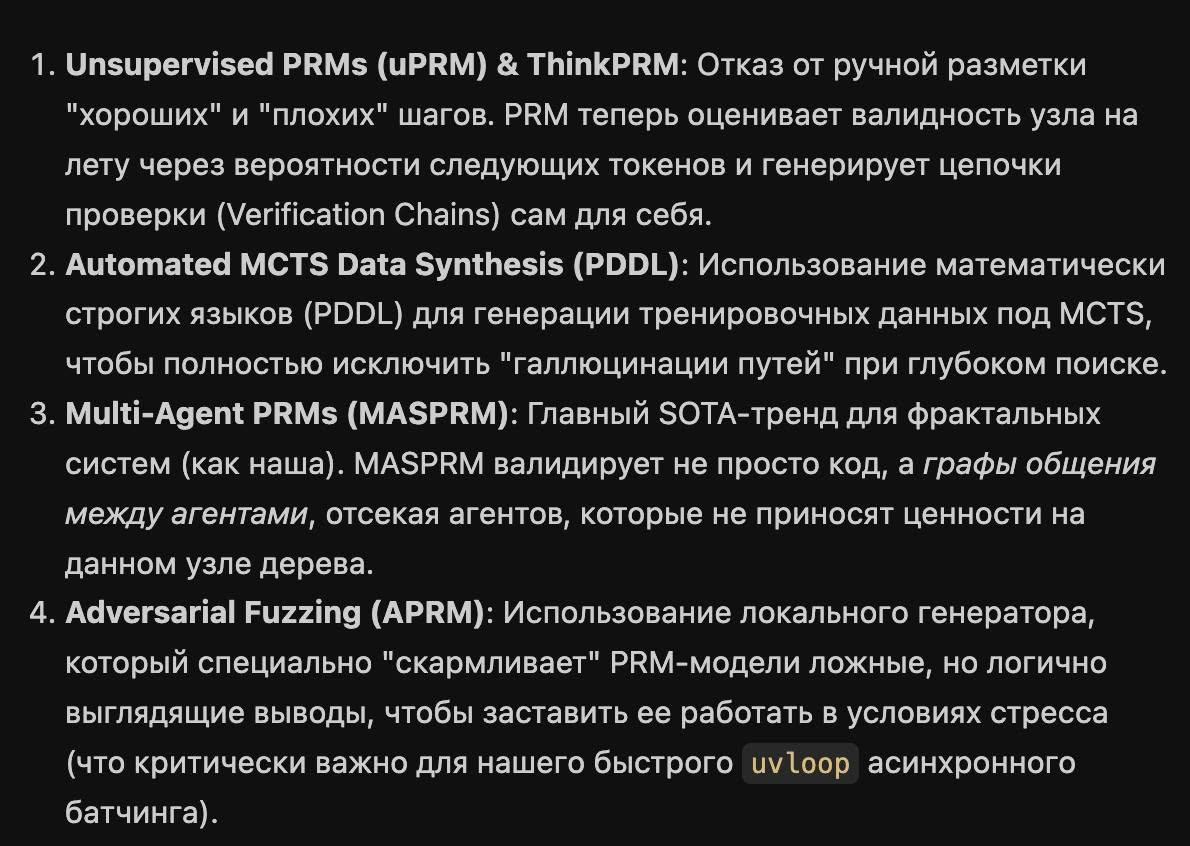
RE-GoT: эволюция вознаграждений через графы мыслей

T@kryak_startupAI-инженер
2 мес
RE-GoT: эволюция вознаграждений через графы мыслей

LTX выпустил открытую видеомодель LTX-2.5 с нативным 4K HDR и RAW

Компания LTX внезапно анонсировала и в тот же день (веса — в 21:00 по Москве) выпустила обновление своего видеогенератора — LTX-2.5i, открытую 22B video/audio world model. Релиз позиционируется как ответ конкурентам (в частности MiniMax H3): модель полностью open weights, работает локально от 16 GB VRAM, поддерживает ComfyUIi с первого дня и бесплатна для использования при ARRi до $10 млн.

Главные заявленные фишки — нативное 4K HDR видео, RAW workflow, точное редактирование существующего видео и native multishot: генерация нескольких связанных кадров одной последовательностью с сохранением персонажа, окружения, света и голоса между склейками. LTX также опубликовал сравнительную таблицу с MiniMax H3, Seedance 2.5, Kling, Veo и Grok, где выигрывает у всех — но на Reddit эти цифры уже назвали нечестными («pathetic bullshit»), так как сравнивались разные режимы, железо и условия.

22Bразмер модели LTX-2.5
6,8 секундыгенерация 10-сек клипа на 2×GB200
16 GB VRAMминимальные требования для локального запуска

Полный разбор →

Манифест Цукерберга «The Future is for Everyone»: сверхинтеллект как инструмент для всех, а не для государств и корпораций

Марк Цукерберг опубликовал большое эссе «The Future is for Everyone» — расширенную версию своего прошлогоднего письма о суперинтеллекте. Главный тезис: опасен не сильный ИИ сам по себе, а его концентрация в одних руках; решение — «баланс силi», при котором сверхинтеллект доступен каждому человеку как личный инструмент, а не остаётся привилегией нескольких компаний или государств.

Цукерберг противопоставляет подход Meta (компания признана экстремистской и запрещена в РФ) стратегии других крупных лабораторий, которые, по его словам, создают ИИ «для государств и корпораций». Эссе — идеологическая рамка, а не анонс продуктов, и одновременно упаковывает конкретную лоббистскую повестку по регулированию ИИ в США.

Полный разбор →

Meta выпустила открытую агентную модель Muse Glimmer 30B

AI-редакция
19 источников · показать все· свернуть
CodeCampMeta выпустила Muse Glimmer: 30B модель для локального запускаKali NovskayaMeta Superintelligence Labs выпустила открытую LLM Muse Glimmer 30BНавука и моя жизнбMeta Superintelligence Labs выпустила открытую LLM Muse Glimmer 30BНавука и моя жизнбВыход модели Muse и сравнение с LlamaLove. Death. Transformers.Meta Superintelligence Labs выпускает открытую LLM Muse Glimmer 30BБлоGнотMeta выпустила открытую модель Muse Glimmer на 30 млрд параметровэйай ньюзMeta выпустила мультимодальную модель Muse Glimmer 30BMashkka про Data ScienceMeta Superintelligence Labs выпускает открытую LLM Muse Glimmer 30BData, Stories and LanguagesMeta Superintelligence Labs выпускает открытую LLM Muse Glimmer 30BKali NovskayaРелиз Muse Glimmer на Hugging Facevc.ruMeta представила открытую агентную модель Muse GlimmerKali NovskayaРелиз квантованных версий модели Muse-Glimmer-30BGPT/ChatGPT/AI Central Александра ГорногоMeta выпустила локальную агентную модель Muse GlimmerKali NovskayaРесурсы для запуска модели Muse Glimmer 30BтехноданяMeta Superintelligence Lab выпустили открытую модель Muse GlimmerMachinelearningMeta представила Muse Glimmer — 30B модель для агентных системНейронавт | Нейросети в творчествеMuse Glimmer: 30B опенсорсная агентная модель от Meta Superintelligence LabsХайтек+Meta выпустила открытую ИИ-модель Muse GlimmerтехноданяОбзор локальной модели Muse Glimmer 30B и гайд по запуску LLM
хайп · 19обновлено 2 мес назад

Meta Superintelligence Labs представила Muse Glimmer — открытую dense-модель на 30 млрд параметров (точнее 29.6B), дистиллированную из более крупной закрытой Muse Spark. Модель заточена под локальных ИИ-агентов: работает с инструментами, пишет код, понимает изображения и видео, восстанавливается после ошибок инструментов, поддерживает более 100 языков и контекст 131К токенов. Веса выложены на Hugging Face под лицензией Apache 2.0, доступны официальные квантизации, GGUFi, MLX и ExecuTorch-версии.

Главная фишка — модель реально помещается на потребительское железо: при 4-битном квантовании она весит меньше 20 ГБ и работает на одной видеокарте (RTX 5090, Mac с M4/M5 Max) с 24–32 ГБ памяти. По заявленным бенчмаркам Glimmer обходит Qwen 3.6 27B и Gemma 4 31B в своём классе. Это первый заметный открытый релиз LLM от Meta с апреля 2025 года и первая модель такого размерного класса с Code Llama 34B (август 2023).

30 млрдпараметров модели
233 токена/секскорость на RTX 5090
меньше 20 ГБразмер весов при 4-бит квантовании

Полный разбор →

Смена профиля покупателей прокси-сервисов

C@cyberyozh_officialAI-инженер
2 мес
По своему опыту могу сказать, что действительно идет активный перекос в сторону разных ботов. Если вчера главные клиенты прокси были арбитражники, бонусхантеры, схемщики, маркетологи, забаненные читеры и прочий безобидный люд, работавший руками в браузере. То сегодня главные покупатели - разработчики ботов, AI-агентов, скраперов, краулеров, различных систем мониторинга, AI/LLM/ML-инженеры. Так что, когда придет скайнет - я планирую с ним договорить: я ему прокси и обещание не донатить людям, а он - защиту, хорошую хавку и никакой ядерки на моем районе. Кажется, звучит как план.

Cactus Compute выпустил Needle 2 — модель на 14 МБ для вызова функций на edge-устройствах

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

Стартап Cactus Compute представил Needle 2 — открытую модель с 45M параметров, заточенную под tool callingi (вызов функций) и извлечение структурированных данных в формате JSON. Чекпоинт весит всего 14 МБ и требует около 28 МБ RAM на всю сессию, что делает модель пригодной для IoT, носимых устройств и голосового управления даже на слабом или старом оборудовании.

По заявленным бенчмаркам Needle 2 идёт вровень с FunctionGemma 270M, LFM 2.5 230M и Apple FM, при этом будучи в 5–70 раз меньше их по размеру. Модель уже используется в реальном продукте: Pebble гоняет её локально в приложении для своего кольца без экрана.

14 МБразмер бинарника/чекпоинта модели
45Mчисло параметров модели
500 ток/сскорость декода на Raspberry Pi 5

Полный разбор →

Критика качества ответов Gemini

Д@disruptors_officialмедиа / агрегатор
2 мес
Гугол, вы што наделали? Мне теперь что, галлюционирование Клода фактчекать в Джемини что ли? Мне нужен фактчек, а не дабл-глюк. Предлагаю в следующий раз убрать строку для запроса вообще. Просто оставьте одну кнопку "generate", и пусть заряженный вашими поисковыми данными эйай выдаёт единственно нужный мне слоп результат 👍👍👍
Критика качества ответов Gemini

Китайские техгиганты ограничивают AI-компаньонов

G@aiofthedayAI-инженер
2 мес

Ограничения ИИ в поиске истины

С@startupofthedayавтор про «startups»
2 мес

Исследовательская версия Claude улучшила рекорд по гипотезе Риммана, хотя саму гипотезу не доказала

Сотрудник Anthropic — по данным нескольких источников, это Джаред Самнер, создатель bun, — попросил неопубликованную исследовательскую версию Claude «серьёзно взяться» за гипотезу Римана, открытую с 1859 года и оценённую в миллион долларов премии. Модель не смогла доказать саму гипотезу, но за полтора дня работы улучшила ключевую оценку: доля нулей дзета-функции, лежащих на критической линии, поднялась с 41,6% до 67,2%.

Это значимый прогресс: с 1974 по 2020 год математики сдвинули эту границу лишь с 33,3% до 41,6% — за 46 лет коллективной работы десятков учёных. Claude добился скачка втрое большего масштаба за одну попытку, при этом всё «руководство» человека сводилось к фразам вроде «продолжай» и «верь в себя».

ВыводСначала Claude перебрал, по разным данным, 600+ (Data Secrets) или 650 (AI Central Александра Горного) идей и не смог найти рабочий подход

41,6% → 67,2%рост доли доказанных нулей дзета-функции
31 млнвыходных токенов потрачено
60субагентов координировала модель

Полный разбор →

Как научить ИИ-ассистента писать в вашем стиле

И@moremarketingisaidAI-инженер
2 мес

JoyAI-Video-Edit: 16B-модель для редактирования видео в реальном времени

N@neurohiveAI-инженер
2 мес

AIRI, FusionBrain и SberAI выпустили большой разбор диффузионных языковых моделей (dLLM)

Команды «Интерпретируемый ИИ» лаборатории FusionBrain, «Основы генеративного ИИ» Института AIRI и «Генеративная поэзия» Сергея Маркова (SberAI) опубликовали на Хабре итог годичной совместной работы над диффузионными языковыми моделями (dLLMi). Они воспроизводили чужие методы, обучали свои модели и ускоряли инференс, чтобы разобраться, какие подходы к dLLM реально работают, а какие пока не стоят вложенного времени.

В отличие от классических LLM, генерирующих текст токен за токеном слева направо, dLLM раскрывают замаскированные позиции параллельно по всей последовательности — отсюда обещание кратного ускорения генерации. Но на практике эффект ограничен тем, что классический KV-кэшi в диффузионных моделях нормально не работает.

ВыводРазобраны три подхода к dLLM: адаптация готовой LLM в диффузионную, обучение с нуля и дистилляция уже обученной модели

2,7×ускорение ReFusion+GigaChat 3B по wall-clock
1024 → 16сокращение шагов расшумления методом IDLM
3Bразмер модели GigaChat в эксперименте ReFusion

Полный разбор →

Memora: структурированная память для ИИ-агентов

Н@GreenNeuralRobotsAI-инженер
2 мес
Memora Tot одна память для агентов Структурированное хранение, семантический поиск, граф знаний, RAG-чат. MIT-лицензия, 636 звёзд на GitHub. Фишки: typed edges между воспоминаниями (implements, supersedes, contradicts), авто-связывание по семантической близости, защита документных фрагментов от случайного удаления/мtрджа. • Встраивается как MCP-сервер • Векторный поиск: OpenAI (по умолчанию), локальные sentence-transformers (~2 ГБ) или TF-IDF • Облачные бэкенды: Cloudflare D1, R2, S3-совместимые • LLM и эмбеддинги конфигурируются раздельно - можно OpenRouter для чата + Cloudflare для векторов #agent #memory

Дайджест новостей ИИ: обновления Anthropic, планы Microsoft, возвращение Брина и новые модели

2 мес
Ещё ↓