оптимизацияСбросить фильтр ×

Оптимизация бизнес-процессов через пайплайны

Ф@Founder_Startupмедиа / агрегатор
2 мес
Оптимизация бизнес-процессов через пайплайны

Marvel Rivals уменьшили в размере и добавили героя Капюшона

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

7 августа для Marvel Rivals вышло межсезонное обновление, которое одновременно сократило вес игры и добавило нового персонажа — героя-«авангардiа» Капюшона.

Разработчики внедрили новый метод сжатия текстур, из-за чего объём игры на разных платформах заметно снизился и стал более сопоставимым между ПК и консолями.

40 ГБожидаемое снижение веса ПК-версии
15 ГБожидаемое снижение веса консольных версий
30%фактическое снижение размера игры на ПК

Полный разбор →

Релиз ComfyUI-Latent-Tiled-PiD для генерации изображений

Н@GreenNeuralRobotsAI-инженер
2 мес
ComfyUI-Latent-Tiled-PiD плаг энд плей декодер для диффузных картинкогенераторов прикрутили в комфи Воркфлоу на гитхабе Спасибо @m_franz #t2i #optimization #qwenimage #flux2 #flux #qi2512 #comfyui #4K
Релиз ComfyUI-Latent-Tiled-PiD для генерации изображений

iOS 27: оптимизация производительности для старых моделей

К@d_codeмедиа / агрегатор
2 мес
📱 iOS 27 ускорит даже старый iPhone 11 Apple серьёзно поработала над производительностью и стабильностью в iOS 27, заявив более 80 оптимизаций системы. Собрали 10 ключевых улучшений, которые вы наверняка заметите после обновления: ☀ https://kod.ru/ios-27-uskorit-vse-iphone-10-uluchsheniy
iOS 27: оптимизация производительности для старых моделей

3DGS-PLY-3DTiles-Converter: конвертер гауссиан для веб-просмотра

Н@GreenNeuralRobotsAI-инженер
2 мес
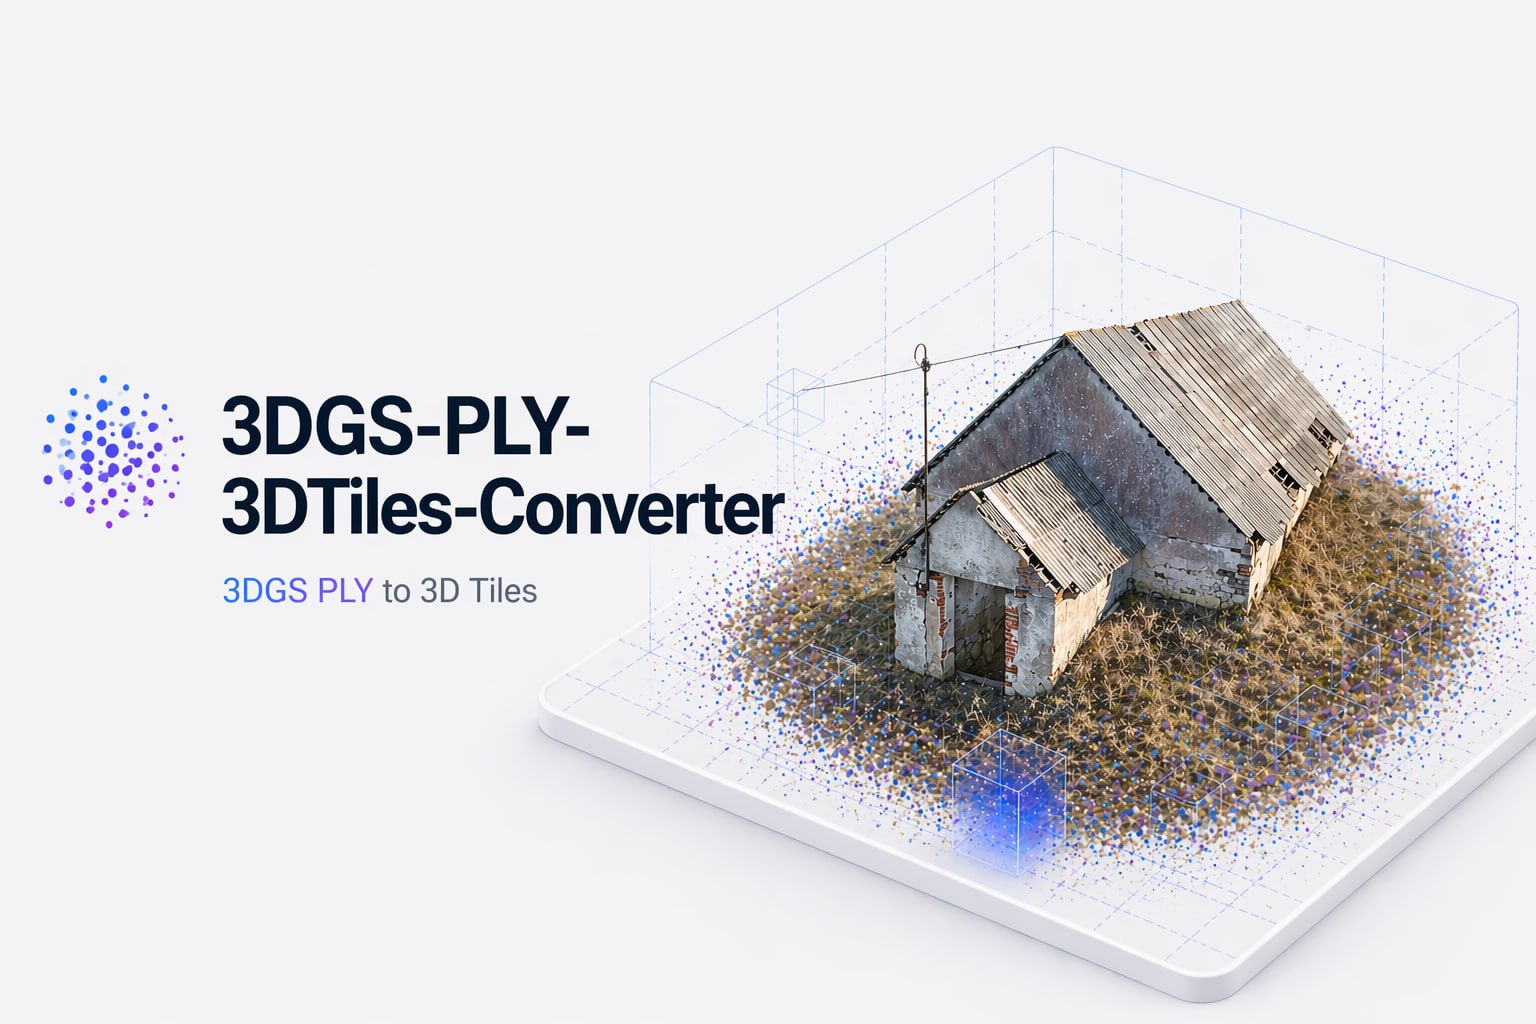
3DGS-PLY-3DTiles-Converter Конвертер гауссиан из формата PLY в 3DTiles для веб-просмотра и интеграции в картографические движки Встроено train-free упрощение сцены без дообучения Демо #gaussian #optimization
3DGS-PLY-3DTiles-Converter: конвертер гауссиан для веб-просмотра

ComfyUI Video Tiler: оптимизация памяти при обработке видео

Н@GreenNeuralRobotsAI-инженер
2 мес
ComfyUI Video Tiler Тайлер для видео и изображений в #ComfyUI, снижает потребление памяти при обработке за счёт разбиения на тайлы (плитки) протестирован в апскейле LTX 2.3 и MiniMax H3 Спасибо @m_franz #upscale #lowvram

Оптимизация MoE-кернелов: переход от push- к pull-based dispatching

К@quant_prune_distillAI-инженер
2 мес

Headroom: инструмент для сжатия контекста ИИ-агентов

C@campcodeAI-инженер
2 мес
Срезаем ИИ-агентам аппетит — нашел на GitHub прикольную тулзу Headroom, которая сжимает логи, файлы, RAG-выдачу и результаты инструментов до отправки в модель. По собственным тестам проекта, это экономит 15–20% токенов у кодинг-агентов и до 60–95% на JSON 🤔 Headroom работает локально как библиотека, прокси или MCP-сервер, отдельно обрабатывает код, текст и структурированные данные. Оригиналы не пропадают: они остаются в локальном кэше, и агент может запросить нужный фрагмент обратно. Поддерживаются Codex, Claude Code, Copilot, Cursor и ещё пачка агентов — есть даже общая память между ними. Экономим токены смолоду 💃

Когда аутсорсинг спасает бизнес?

Ф@Founder_Startupмедиа / агрегатор
2 мес
Когда аутсорсинг спасает бизнес?

Выпущен ускоряющий модуль ComfyUI для MiniMax H3

Н@GreenNeuralRobotsAI-инженер
2 мес
ComfyUI Spectrum MiniMax H3 Ускоряющий модуль для MiniMax H3 Прогнозирует скрытые признаки по модели Чебышева вместо полного пересчета трансформера на каждом шаге • Сохраняет нативные выходы MiniMax H3 на каждом шаге • Работает с аудио и видео одновременно • Поддерживает популярные сэмплеры: Euler и RES multistep • Совместимость с ComfyUI от 3 августа 2026, ранние версии не поддерживает • Параметры настройки: степень полинома, размер окна прогнозирования, количество шагов прогрева • Поддерживает FP16/BF16 для хранения истории #comfyui #optimization #minimaxh3

Презентация по квантизации нейросетей

К@quant_prune_distillAI-инженер
2 мес
Презентация про квантизацию с моего выступления на нашей Hardware Efficiency Reading Group, где мы обсуждаем темы и статьи про эффективное глубокое обучение. Записи и программу прошлых семинаров можно найти здесь.

WASTE: движок на 6000 строк C запускает полновесную Kimi K3 без GPU, подгружая экспертов с SSD

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

Разработчики SQLite AI создали инференс-движок WASTE (6000 строк C, без BLAS, CUDA и Python в рантайме), который позволяет запускать полновесную MoEi-модель Kimi K3 на обычном железе — вплотную к пределу возможностей потребительских дисков и памяти. Модель никогда полностью не загружается ни в RAM, ни в VRAM: в память кладётся только «плотный» резидентный блок, а нужные на каждом шаге эксперты подтягиваются прямо с диска.

Это важно, потому что Kimi K3 — гигантская MoE-модель (по разным оценкам 2,8–3 трлн параметров), которая в обычном виде требует терабайты памяти. WASTE показывает, что такие модели можно гонять локально без серверных стоек с DDR5, хотя цена — скорость в доли токена в секунду.

982 ГиБразмер сконвертированной модели K3
0,49-0,54 токена/сскорость на MacBook с 64 ГБ
6000 строкобъём кода движка WASTE на C

Полный разбор →

Лаба Song Han из MIT выпустила агентский скилл для оптимизации CUDA-кернелов под Hopper и Blackwell

Лаборатория Song Han (MIT), известного специалиста по эффективному глубокому обучению, опубликовала репозиторий со скиллом для AI-агентов, предназначенным для оптимизации кернеловi под архитектуры Hopperi и Blackwelli.

Скилл содержит набор скриптов, которые позволяют агенту самостоятельно обращаться к базам знаний, блогам, PR'ам и другим артефактам, посвящённым тензорным ядрам и архитектурным особенностям Hopper и Blackwell — то есть автоматизирует часть рутинной работы по низкоуровневой оптимизации GPU-кода.

Полный разбор →

PrunaVAED: оптимизированный VAE-декодер для LTX-2.3

Н@GreenNeuralRobotsAI-инженер
2 мес
PrunaVAED Альтернативный VAE-декодер для LTX-2.3 • в 1.7 раза быстрее LTX-2.3 VAED • на ~50% ниже пиковое потребление VRAM • близкое к оригиналу качество изображения • совместим с diffusers/LTX-2.3-Diffusers • есть бенчмарки для разных разрешений (720p, 1080p) • протестировано на NVIDIA H100 80GB • ограничения: оценен на 4-секундных клипах при 24 fps, не является полной T2V-моделью, не совместим с произвольными VAE-латентными данными Comfyui поддержка Спасибо @m_franz @BrianMItro🥳 #VAE #optimization

Sol-Attn: ускорение инференса видеогенерации до 2.1х

Н@GreenNeuralRobotsAI-инженер
2 мес
Sol-Attn Ускорение инференса видеогенерации до 2.1х без обучения от NVIDIA Прикручено к практически всем актуальным видеогенераторам На примерах вверху Dense attention, внизу Sol attention Гитхаб #t2v #optimization

OpenAI резко снизила цены на GPT-5.6 Luna и Terra, для Sol добавила ускоренный режим Fast

OpenAI пересмотрела цены на модели семейства GPT-5.6i: Luna подешевела на 80% (стала дешевле в 5 раз), Terra — на 20%. Флагманская Sol в цене не изменилась, но для неё вместо Priority Processing ввели режим Fast — до 2,5 раза быстрее стандартной обработки за двойную цену без потери качества. Снижение действует не только в API, но и в квотах подписок ChatGPT Work и Codex.

По данным Reuters (со ссылкой на vc.ru), лаборатории вынуждены пересматривать цены на фоне усиления контроля компаний за расходами на ИИ и конкуренции с китайскими разработчиками — это укладывается в общий тренд ценового давления на рынке, в частности на Anthropic.

80%снижение цены Luna
20%снижение цены Terra
2.5xускорение Sol в режиме Fast

Полный разбор →

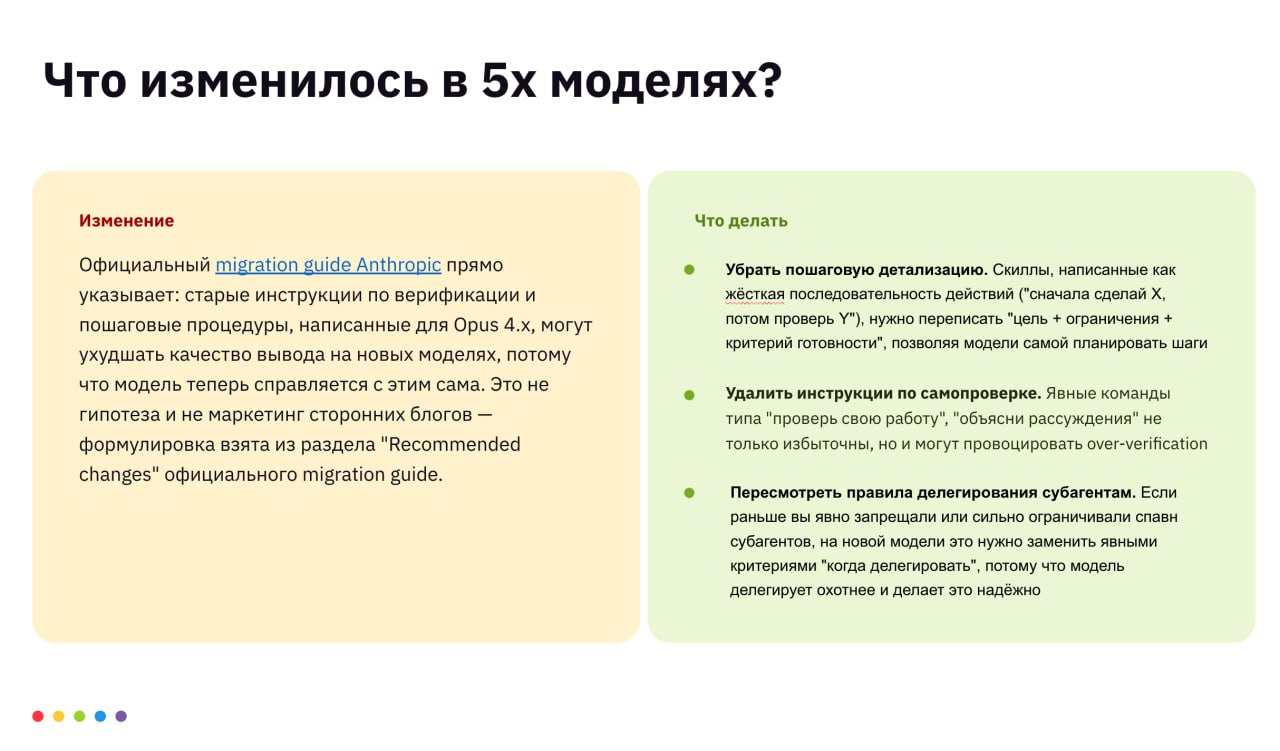
Оптимизация промптов под Opus 5: отказ от legacy-паттернов

И@AImademydayAI-инженер
2 мес
Оптимизация промптов под Opus 5: отказ от legacy-паттернов

Физики из Эдинбургского университета нашли способ снизить энергопотребление памяти

3@ru3dnewsмедиа / агрегатор
2 мес
Физики нашли способ резко снизить потребление компьютерной памяти —  решение лежало на поверхности Физики из Эдинбургского университета (University of Edinburgh) показали возможность значительно уменьшить энергию, необходимую для записи данных в электронную память. Проблема энергопотребления памяти приобрела особую остроту после развития платформ генеративного интеллекта и любой вариант смягчить последствия этого должен рассматриваться в приоритетном порядке. #память #оптимизация #эффективность 📎Подробнее 🔖 3DNews в TG | MAX | VK
Физики из Эдинбургского университета нашли способ снизить энергопотребление памяти

Microsoft обещает снизить потребление ОЗУ Windows 11 для ПК с 8 ГБ памяти

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

Microsoft объявила о планах оптимизировать использование оперативной памяти в Windows 11, чтобы система работала быстрее и отзывчивее на компьютерах с 8 ГБ ОЗУ и более.

Шаг связан с возвращением на рынок бюджетных ноутбуков с объёмом памяти всего 8 ГБ — для них текущая версия Windows 11 работает недостаточно комфортно.

8 ГБминимальный объём ОЗУ, для которого оптимизируют систему

Полный разбор →

Оптимизация модели Qwen-Image-2512 от ByteShape

Н@GreenNeuralRobotsAI-инженер
2 мес
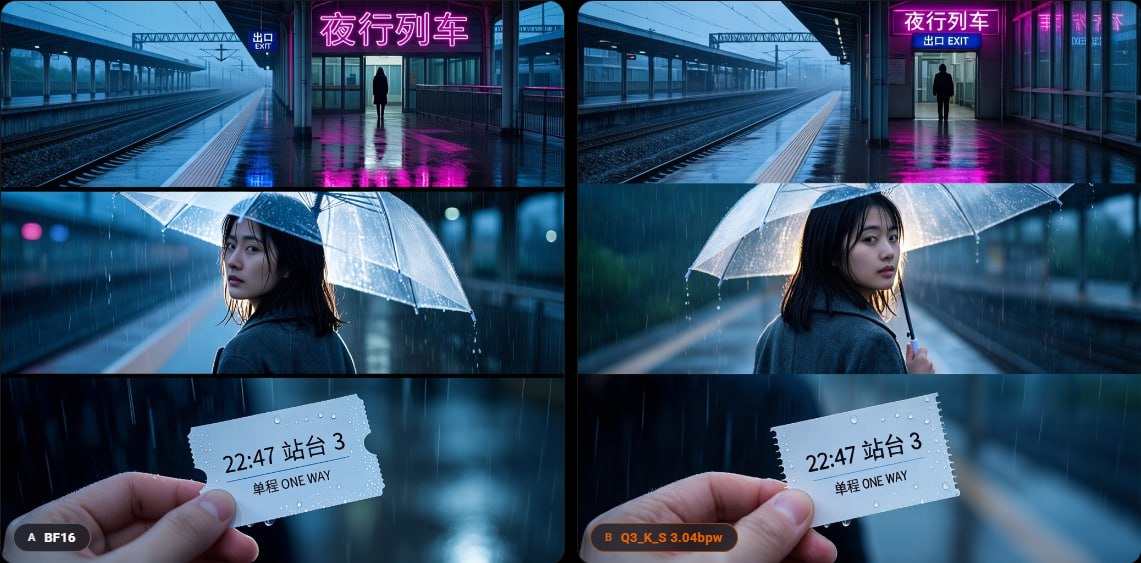
Qwen-Image-2512 GGFU/Humming Пока Алибаба зажал новые квены, ByteShape оптимизировали старый. • шесть уровней квантизации для GGUF от 8 до 17 ГБ • Humming - экспериментальная интеграция, но быстрее GGUF • для vLLM-Omni: 8–17 ГБ, ускорение в 2–3 раза сравнение с оригинальной моделью #qi2512 #gguf #humming
Оптимизация модели Qwen-Image-2512 от ByteShape

Unsloth AI выпустили локальные версии моделей

т@techn0danyaAI-инженер
2 мес
🦥 Ленивцы на выходных Задание ТОЛЬКО для отличников канала, которые читали этот пост с разбором оптимизаций Inkling Чуваки из Unsloth AI выпустили свои версии модельки, которые можно запустить локально. Гайд тут. Тренируемся хостить AGI локально. #AI @techn0danya

Почему нельзя идеально оптимизировать светофоры

Х@habr_comмедиа / агрегатор
2 мес

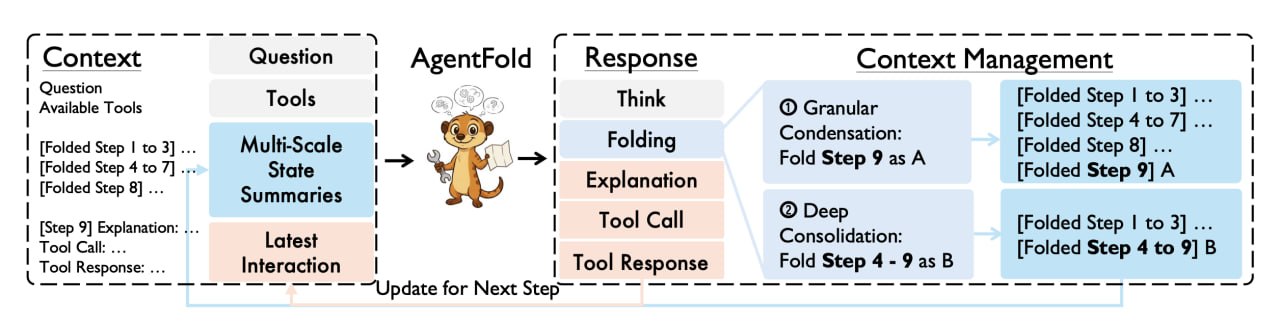
AgentFold: метод динамического управления контекстом для AI-агентов

Д@stuffyNLPAI-инженер
2 мес
AgentFold: метод динамического управления контекстом для AI-агентов
Ещё ↓