datasetСбросить фильтр ×

FairStress выявил гиперкоррекцию в решениях языковых моделей

вчера
FairStress выявил гиперкоррекцию в решениях языковых моделей

NVIDIA опубликовала набор SimReady Assets: 2575 3D-объектов объёмом 472 ГБ

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено вчера

NVIDIA выложила датасет NVIDIA SimReady Assets для симуляторов и обучения Physical AIi. В него вошли 2575 3D-моделей общим объёмом 472 ГБ.

Для каждого объекта указаны физические и другие параметры, чтобы симуляторы могли учитывать не только внешний вид модели, но и её свойства. Такой набор данных может сделать виртуальные среды полезнее для расчёта физики и обучения ИИ взаимодействию с объектами.

472 гигаобъём датасета
2575число 3D-моделей

Полный разбор →

ИИ-агенты оценили шансы автора стать ультрабогатым

D@denissexyAI-инженер
1 нед
Я говорю, датасет своей жизни в виде одного md файла полезная вещь – поставил авторесеч на 75 агентов исследовать как мне стать ультрарич человеком на всех вводных, и он часов 6 думал и говорит – дружище, плохие новости, без шансов Назло ему захотелось теперь больше работать 🗿

Sharpa представила датасет с тактильными данными для обучения роботов

P@prorobotovchannelавтор про «tech»
1 нед

Microsoft выпустила датасет и модель для обучения роботов

1 мес
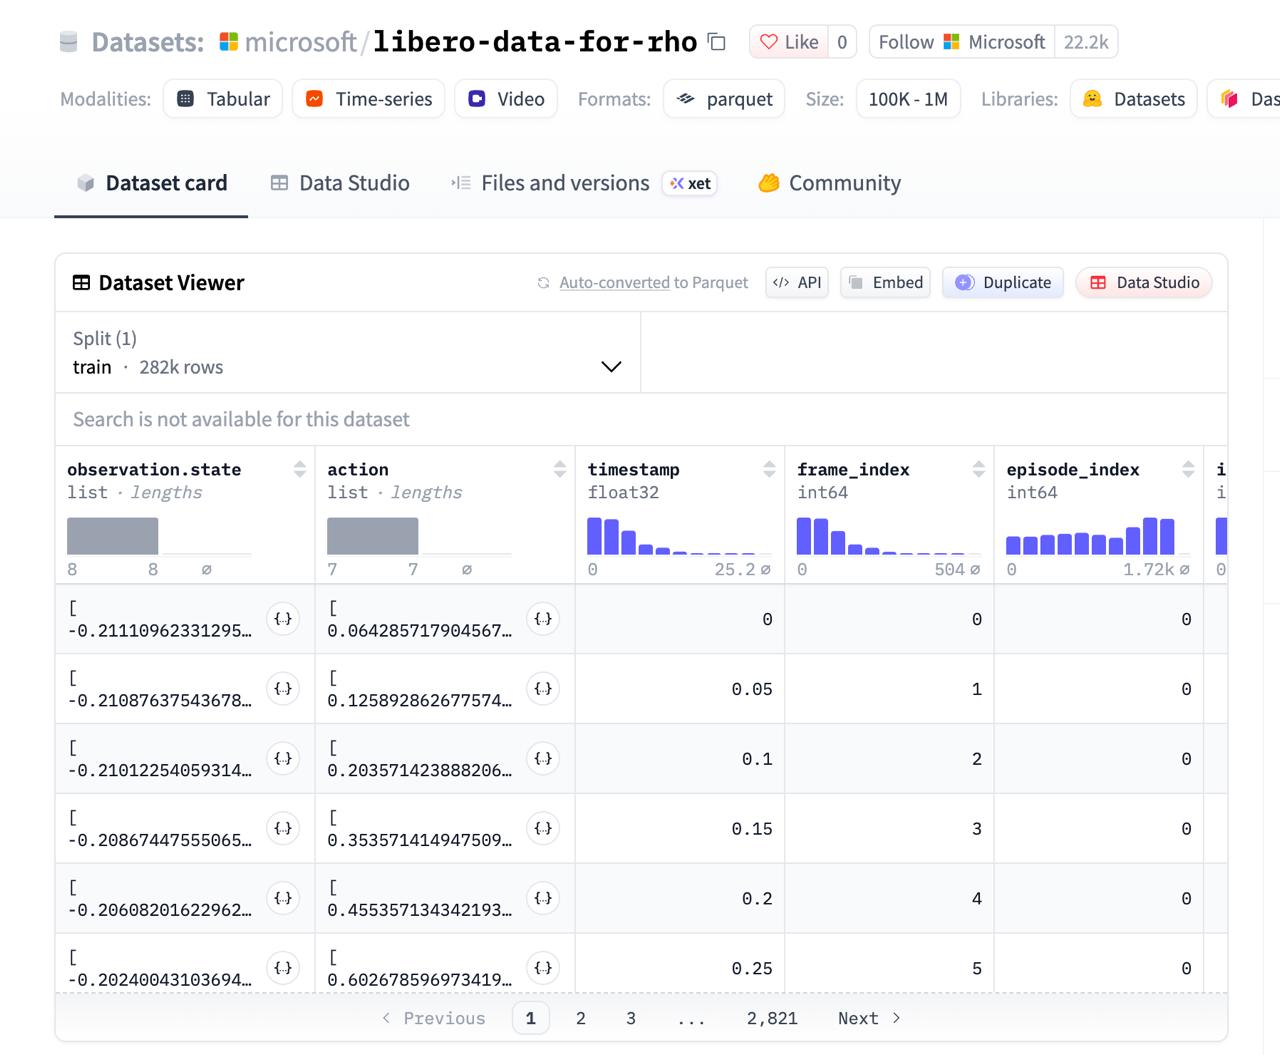
🤖 Microsoft открыла данные, на которых можно учить ИИ управлять роботом. Датасет libero-data-for-rho содержит 282 тысячи записей из задач LIBERO: в каждой есть состояние робота, следующее действие, временная метка и номер задачи. Рядом Microsoft опубликовала 5-миллиардную модель `rho-libero` для роботизированных манипуляций. Это материал для экспериментов с тем, как робот связывает наблюдение с движением. Лицензия датасета — MIT; подробное описание его подготовки в карточке пока не опубликовано. Датасет - https://huggingface.co/datasets/microsoft/libero-data-for-rho Модель - https://huggingface.co/microsoft/rho-libero
Microsoft выпустила датасет и модель для обучения роботов

AGIBOT открыла доступ к датасету для обучения гуманоидных роботов

Х@htech_plusисследователь
1 мес
Китайская компания открыла доступ к данным, собранным во время 11430 траекторий роботов при обучении 14 промышленным и бытовым навыкам. В них входят эталонные образцы движений, неудачные попытки и коррекция со стороны человека-учителя. Речь идет о AGIBOT, чьи машины взяли 46 медалей на Вторых всемирных играх гуманоидов. 18 из них были золотыми. Опубликованная информация пригодится разработчикам для тренировки своих гуманоидов с воплощенным искусственным интеллектом.

PereStruct: модульный подход к распознаванию структуры газетных страниц

Х@habr_comмедиа / агрегатор
1 мес
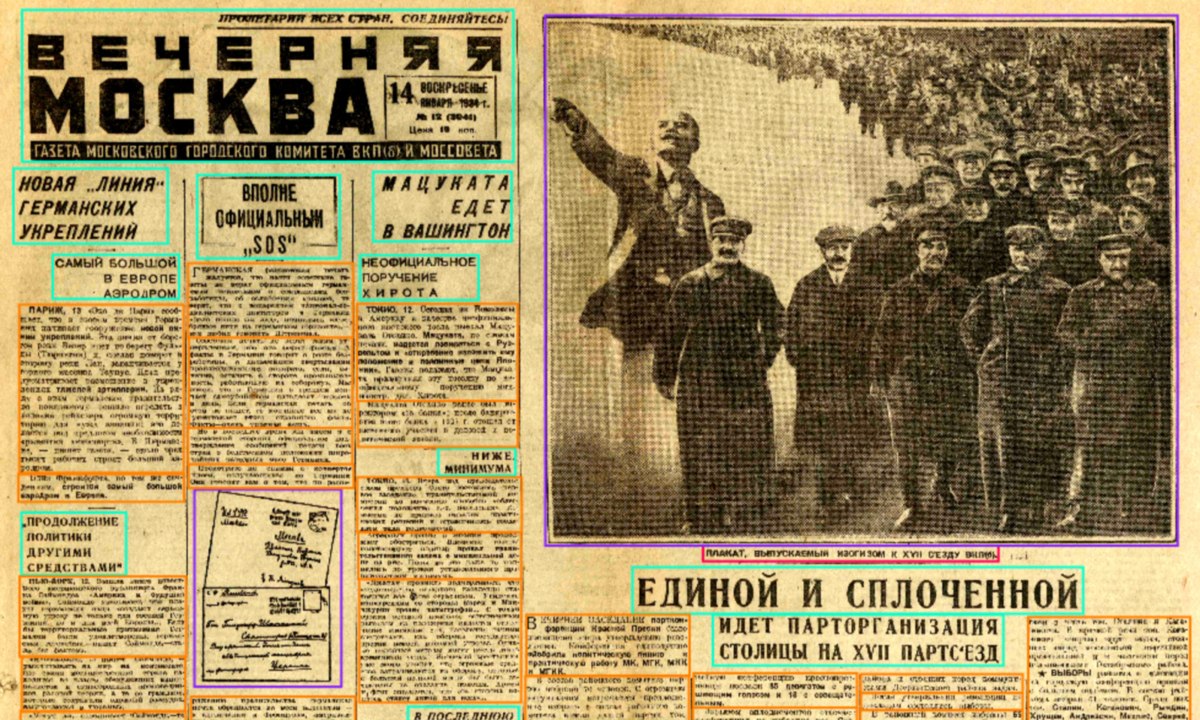
PereStruct: модульный подход к распознаванию структуры газетных страниц

SolarWM: открытый фреймворк для обучения интерактивных видеомоделей мира

Н@GreenNeuralRobotsAI-инженер
1 мес
SolarWM Открытый фреймворк для обучения интерактивных видеомоделей мира - Обучение на 5-сек клипах, но модель держит длинные роллауты - Единый фреймворк на 4 бэкбонах: Wan 5B, Wan 14B, LTX-2.5, MiniMax-H3 — выбирай архитектуру - Полностью открытый датасет: 1.43M клипов, 25 ТБ, с калибровкой камеры и фильтрацией - Открытый стек: данные, код обучения, веса, препроцессинг Гитхаб HF #world #training #dataset #intereactive VK | MAX

LAION выпустила открытый датасет BVD из 80 млн видео

1 мес
LAION выпустила открытый датасет BVD из 80 млн видео

Японский разработчик создал алгоритм для автопоиска сцен оргазма в порновидео

Разработчик из Японии, известный в твиттере, «навайбкодилi» скрипт, который автоматически находит женские оргазмы в длинных порноролах и нарезает их на 10-секундные референсы для ComfyUIi. Идея родилась из практической проблемы: просматривать вручную терабайты видео утомительно и «слишком возбуждает», а прямой запрос к нейросети вида «где тут кончают?» не работает — модели плохо разбираются в этой тематике и часто ошибаются.

Вместо нейросетевого подхода автор решил задачу через классическую обработку сигналов, выделив три признака нужных моментов в видео. Скрипт уже находит значительную часть подходящих сцен, а в перспективе автор планирует создать полноценный классификатор на основе датасета «оргазм / не оргазм».

100–1500 Гцдиапазон частот стонов для детекции
10 секунддлина нарезаемых видеофрагментов

Полный разбор →

Запуск Last Translation Benchmark для оценки качества перевода

̶@izolenta_mebiusaAI-инженер
2 мес
Мои знакомые сейчас собирают "Last Translation Benchmark" — заведомо сложный бенчмарк задач перевода. Сложность проверяется следующим образом: каждый пример прогоняется через десяток моделей, и нужно, чтобы не более пары из них дали правильный перевод. Языки могут быть какие угодно. Если у вас есть примеры таких сложных текстов для языков, с которыми вы работаете, предлагаю туда их загнать) Если добавить 10+ примеров в ближайшие пару недель, можно стать соавтором статьи про этот бенчмарк — ну и заодно привлечь к языку немножко внимания. https://last-translation-benchmark.vilda.net/

В России готовят ИИ-бенчмарк на «духовность и нравственность»: Яндекс опровергает авторство концепции

В России обсуждают создание специальных тестов (бенчмаркiов) для проверки языковых моделей на соответствие духовно-нравственным ориентирам и традиционным ценностям — перед их внедрением в поисковики, образовательные сервисы и умные устройства.

По данным PRO Hi-Tech, концепцию национального датасета для такого тестирования представил «Яндекс» — правительственной рабочей группе. Однако позже, как сообщает Код.ру, «Яндекс» опроверг, что представлял эту концепцию — источники противоречат друг другу в вопросе авторства инициативы.

Полный разбор →

Т-Технологии представили на ACM KDD 2026 техрепорт о датасете T-ECD и разослали его вузам

Исследователи из Т-Технологий выступили на конференции ACM KDD 2026i (9–13 августа, Южная Корея) с техрепортом о T-ECDi — одном из крупнейших в мире открытых обезличенных датасетов пользовательских взаимодействий для рекомендательных систем. Сам датасет был выложен в открытый доступ ещё осенью прошлого года на Huggingface, а техрепорт впервые представили именно сейчас в основной программе конференции.

Прямо с конференции команда разослала датасет и гайд по работе с ним руководителям академических программ и профессорам крупнейших ИТ-вузов России. Это должно дать студентам возможность тренировать модели не на синтетических данных или устаревшем MovieLens, а на данных, приближенных к реальному бизнесу — область рекомендательных систем (рексисi) считается закрытой и труднодоступной для новичков.

135 млрдвзаимодействий в датасете T-ECD
5доменов электронной коммерции в датасете
8×H100максимальная GPU-конфигурация в гайде

Полный разбор →

Открытый корпус выразительной русской речи Dialogs принят на Interspeech 2026

Илья Латышев и Борис (автор канала «Борис опять») подготовили статью «Dialogs: a studio-quality expressive conversational Russian speech corpus for dialog assistants», которую приняли на конференцию Interspeech 2026i. В основе статьи — открытый студийный корпус выразительной русской разговорной речи объёмом 20 часов, записанный тремя профессиональными актёрами театра с разметкой эмоций.

Особенность корпуса — актёры записывали диалоги, сидя друг напротив друга и видя мимику и жесты партнёра, хотя текст реплик был заранее подготовлен (scriptedi). Такой подход сделал речь заметно более естественной и эмоциональной по сравнению с записью дикторов по одному. Корпус предназначен в первую очередь для файнтюна моделей синтеза речи (TTSi) и распространяется по открытой лицензии для исследований.

20 часовобъём записанного корпуса
3профессиональных диктора-актёра

Полный разбор →

Выпущен мультиязычный датасет на 22 языках народов России

Б@boris_againAI-инженер
3 мес

Статья о русском речевом корпусе Dialogs принята на Interspeech 2026

Команда с Ильёй Латышевым подготовила статью «Dialogs: a studio-quality expressive conversational Russian speech corpus for dialog assistants», которую приняли на конференцию Interspeech 2026i. В статье представлен открытый студийный корпусi выразительной русской разговорной речи, предназначенный в первую очередь для файнтюнiа моделей синтеза речи.

Особенность корпуса — способ записи диалогов: два актёра театра сидели друг напротив друга и читали заранее подготовленные реплики, видя мимику, жесты и эмоциональную реакцию собеседника, что сделало речь заметно более естественной и выразительной по сравнению с изолированной записью каждого диктора.

20 часовобъём речевого корпуса
3количество дикторов-актёров

Полный разбор →

Автор датасета поссорился с Хабром из-за претензионного письма, но после второго обращения закрыл доступ

9 июля 2026 года автор некоего датасетiа (данные, судя по всему, собраны с Хабрiа) получил претензионное письмо от площадки и публично разозлился: назвал Хабр в грубой форме, призвал не писать туда и не читать его, а также объявил, что не закроет датасет, пока ему не пришлют «нормальное письмо». Пост с этим текстом почти одновременно разошёлся по нескольким Telegram-каналам.

10 июля автор сообщил, что пришло новое, повторное письмо — на этот раз написанное юристами, вежливое и разумное по тону. После этого он полностью закрыл датасет.

Полный разбор →

Это всё на сейчас.