codingСбросить фильтр ×

Релиз OpenCode V2: обновление агента для написания кода

Н@GreenNeuralRobotsAI-инженер
2 нед
Релиз OpenCode V2: обновление агента для написания кода

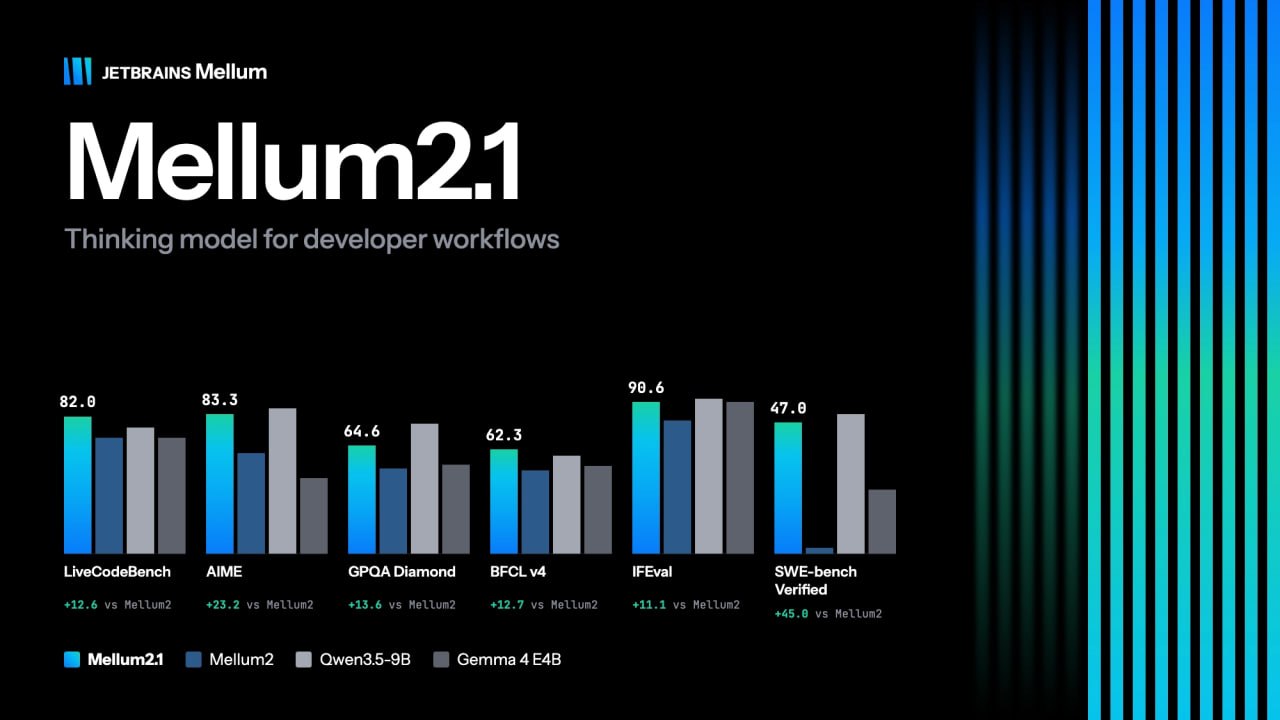
JetBrains выпустила обновленную модель Mellum 2.1

Н@GreenNeuralRobotsAI-инженер
2 нед
JetBrains выпустила обновленную модель Mellum 2.1

Fireworks выпустила Ember-1 — версию Kimi K3, которая «думает» на 40% дешевле

Платформа для запуска AI-моделей Fireworks представила Ember-1 — дообученную версию модели Kimi K3i, которую научили тратить заметно меньше токенов на рассуждения без потери качества ответов. Модель убирает лишние повторы и избыточные цепочки размышлений, оставляя полезную самопроверку, за счёт чего расход токенов падает на 35-50% при сопоставимом или лучшем результате на бенчмарках.

Это важно для компаний, которые платят за токены в agentic и coding-задачах: снижение расхода токенов напрямую сокращает счета за API без смены модели и без потери качества решений.

40%снижение расхода токенов у Ember-1
92.2%результат Ember-1 на SWE-bench Verified
$126экономия на задаче на DeepSWE против K3 max

Полный разбор →

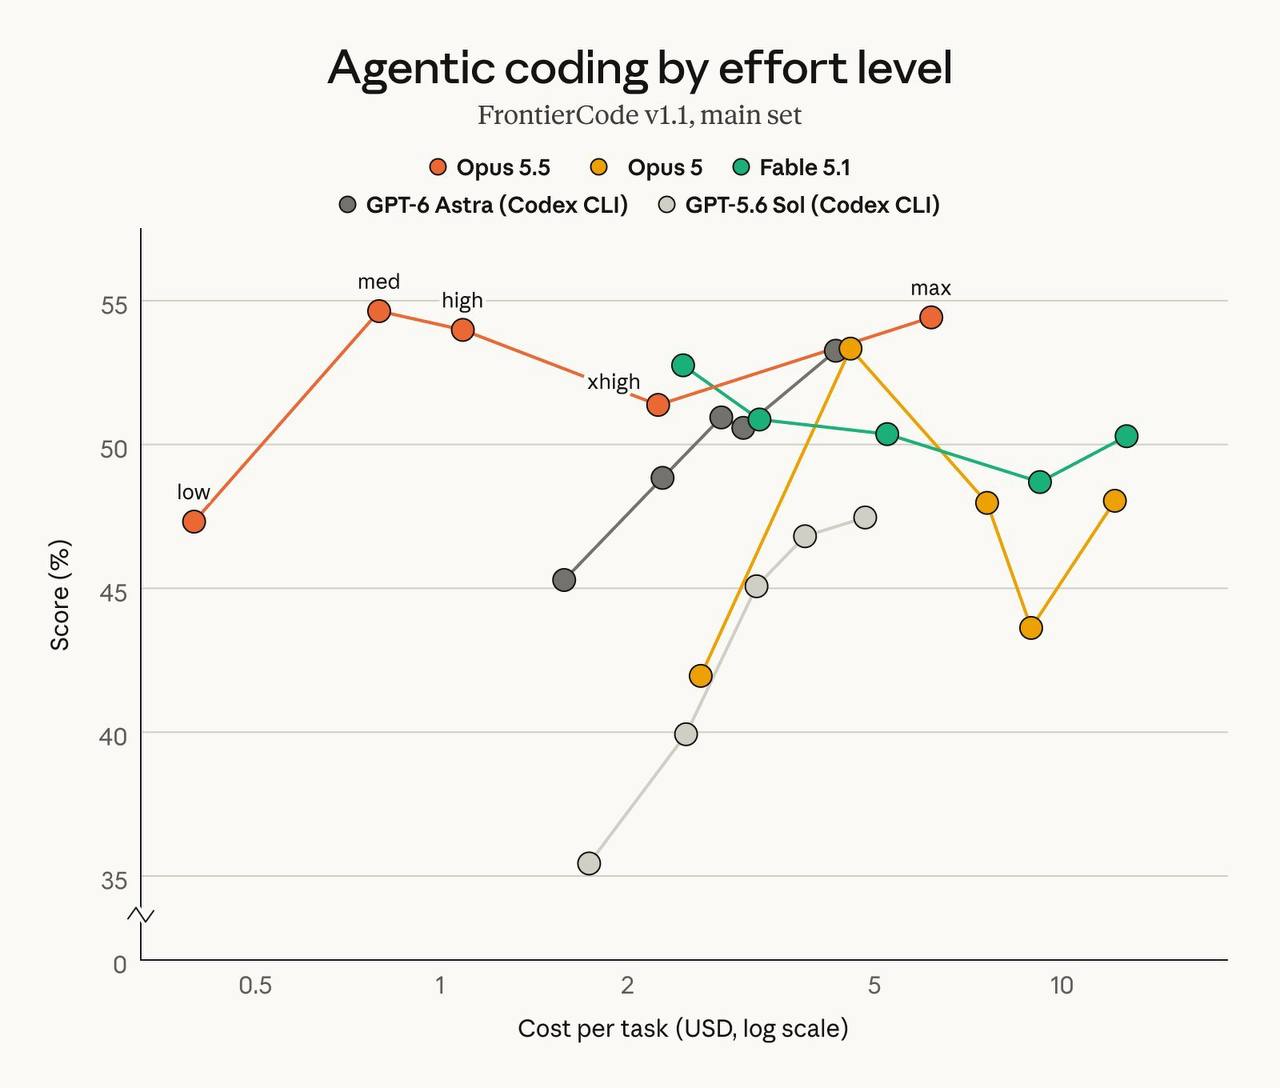
Почему модели с высоким effort могут проигрывать в бенчмарках

w@wealldesignersAI-инженер
1 мес
Почему модели с высоким effort могут проигрывать в бенчмарках

Период полураспада софта в эпоху AI-агентов

L@llm_under_hoodAI-инженер
1 мес

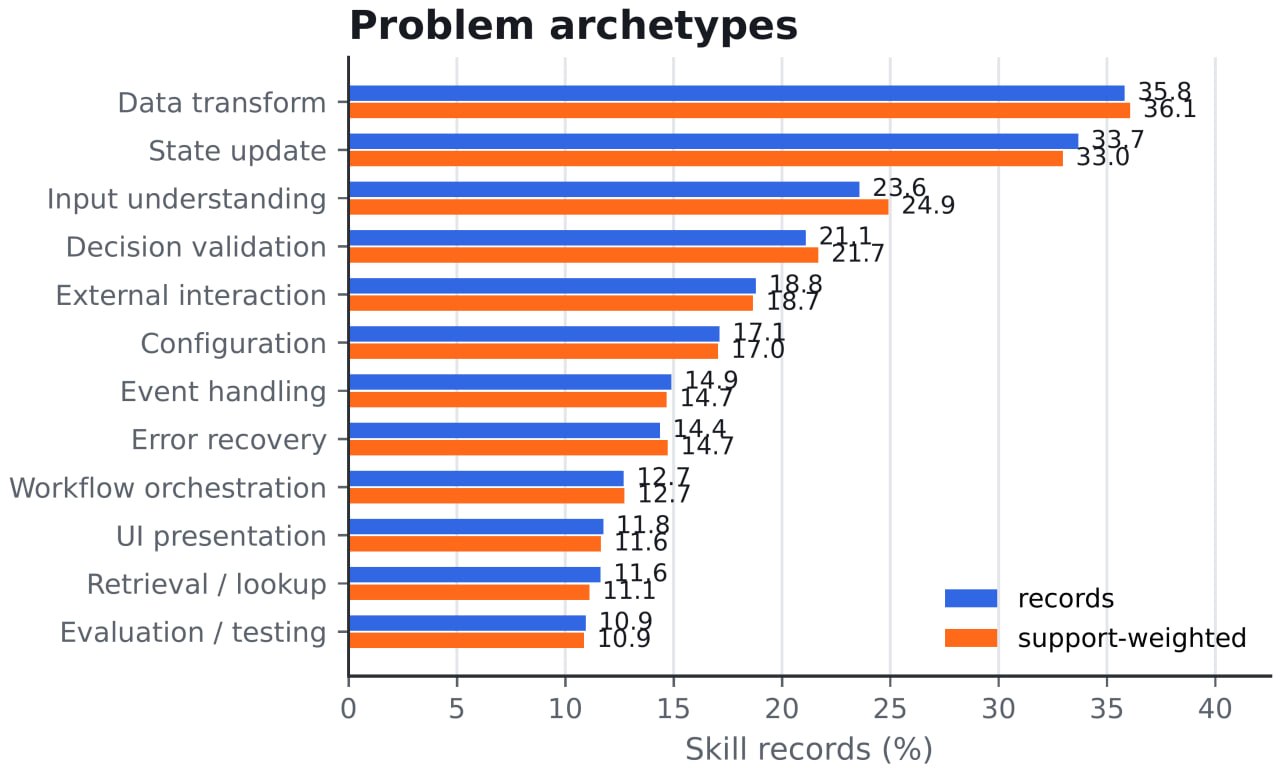
Code2Skill: превращение кода из репозиториев в навыки для AI-агентов

Н@GreenNeuralRobotsAI-инженер
1 мес
Code2Skill: превращение кода из репозиториев в навыки для AI-агентов

Появление новой модели Union Alpha в кодинге

C@campcodeAI-инженер
1 мес
У GPT-6 Astra появился конкурент в кодинге — на OpenCode заметили мощную неизвестную модель Union Alpha. Вероятно, это китайская новая модель. О ней пока ничего неизвестно, но ее способности уже радуют. Так, на DeepSWE она набрала около 74%, обойдя GPT-5.6 Sol и сравнявшись с GPT-6 Astra и Claude Opus 5. А на Terminal-Bench v4.0 получила около 51%, что выше большинства других моделей. Бежим тестить 🏃‍♂️

Бенчмарк Specific Labs: реальные задачи разработки для LLM

A@ai_productAI-инженер
1 мес
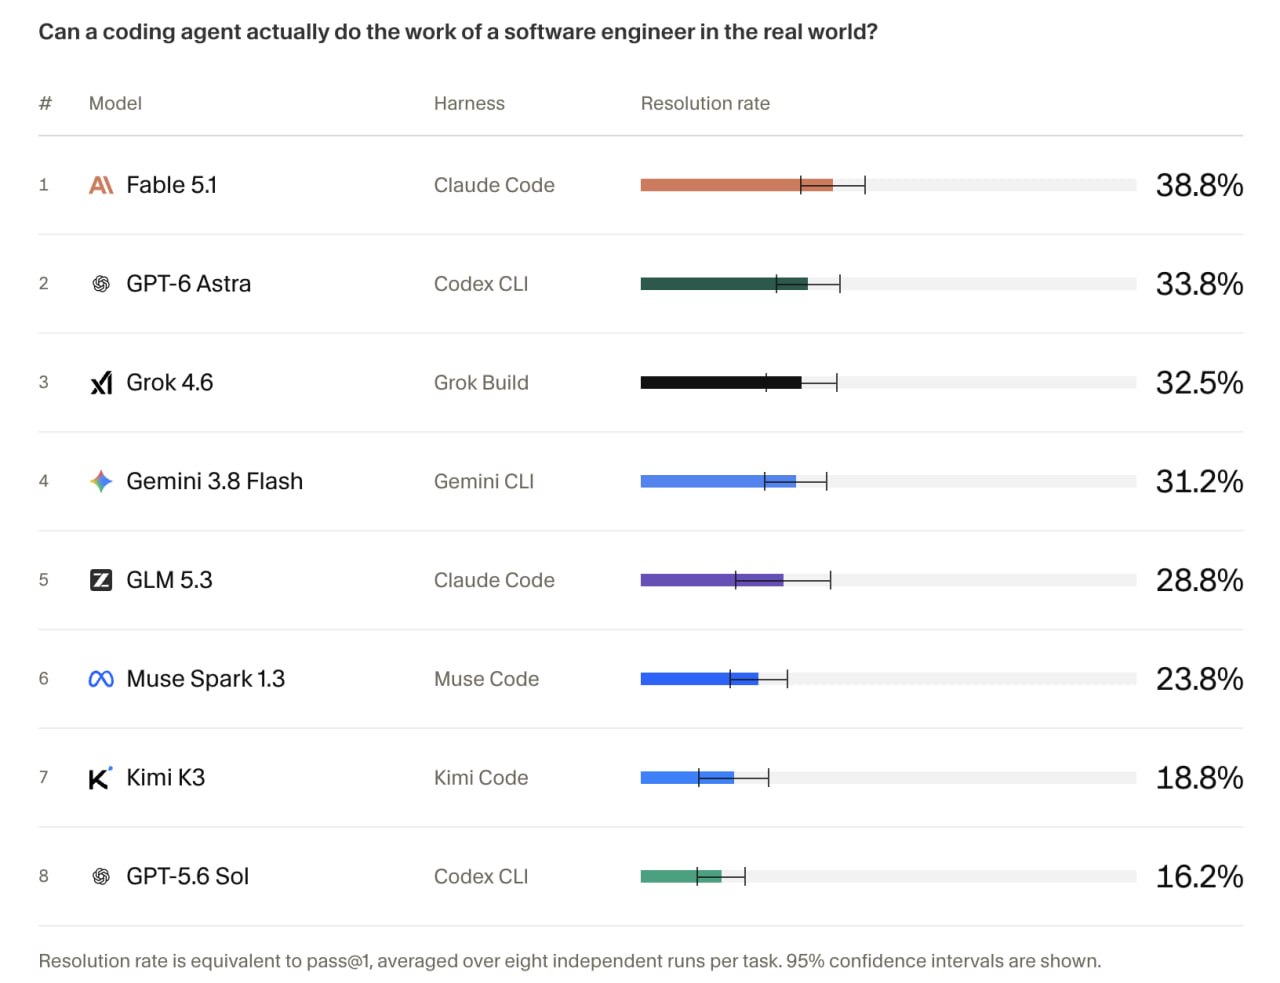
Бенчмарк Specific Labs: реальные задачи разработки для LLM

Microsoft представили FrogNano: 4B модель для кодинга

А@AGI_and_RLAI-инженер
1 мес
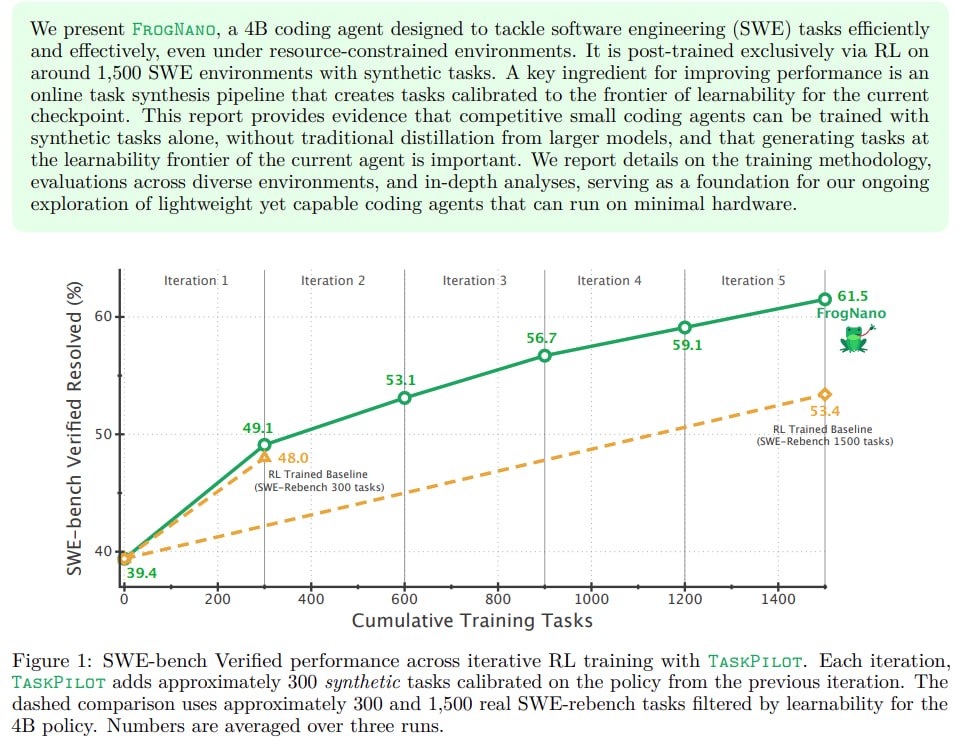
Майкрософты потюнили 4B Qwen-3.5 на 61.5% Swe-bench verified чисто генерацией задач и рлем FrogNano: Training a 4B Coding Agent via Online Task Synthesis https://microsoft.github.io/debug-gym/static/papers/frognano_technical_report.pdf https://microsoft.github.io/debug-gym/
Microsoft представили FrogNano: 4B модель для кодинга

Meta выпустила Muse Spark 1.3 — обновлённую модель для кода и ИИ-агентов

Meta (признана экстремистской и запрещена в России) представила Muse Spark 1.3 — обновление флагманской модели для программирования и агентных задач. Модель уже доступна в ИИ-агенте для написания кода Muse Codei и через Meta Model API.

По сравнению с версией 1.2 модель заметно экономнее по ресурсам при росте качества: на 20% меньше вызовов инструментов и на 25% меньше токенов при том же результате. По бенчмаркам Meta ставит модель в один ряд с GPT-5.6 Sol и Claude Opus 5, а по некоторым тестам (особенно длинный контекст и код) — выводит в лидеры.

25%меньше токенов, чем у версии 1.2
20%меньше вызовов инструментов, чем у версии 1.2
98,5результат на MRCR (256–512К токенов)

Полный разбор →

Смена парадигмы в разработке: от внедрения LLM к агентной разработке

L@llm_under_hoodAI-инженер
1 мес

OpenBot: инструмент для создания ИИ-агентов от CopilotKit

Н@GreenNeuralRobotsAI-инженер
2 мес
OpenBot Инструмент для сборки ИИ-ботов, часть экосистемы CopilotKit, работает поверх LLM • запускает бота в браузере и CLI • подключает внешние API и инструменты • хранит контекст диалога локально • поддерживает кастомные промпты #bot #agent #coding VK | MAX

Vercel Labs выпустила сверхкомпактный харнесс для кодинг-агентов fx

Vercel Labs открыла проект fx — харнессi для кодинг-агента, написанный на Zig, который начинался как внутренний инструмент компании для исследования моделей и встраивания в другие системы. Главная особенность — экстремальная компактность и скорость: бинарник весит 6,3 Мб, а запуск занимает всего 10 микросекунд при базовом потреблении памяти в несколько мегабайт.

fx не привязан к конкретной модели или провайдеру и одинаково работает с локальным и облачным инференсом, а его функциональность расширяется через skills, плагины и MCPi. Проект важен для разработчиков, ищущих легковесную альтернативу тяжёлым IDE-агентам с фокусом на приватность и переносимость, включая запуск прямо в браузере.

6,3 Мбразмер бинарника fx
10 микросекундвремя запуска fx

Полный разбор →

DeepSeek V4 Pro получил прирост производительности через J-Space

2 мес
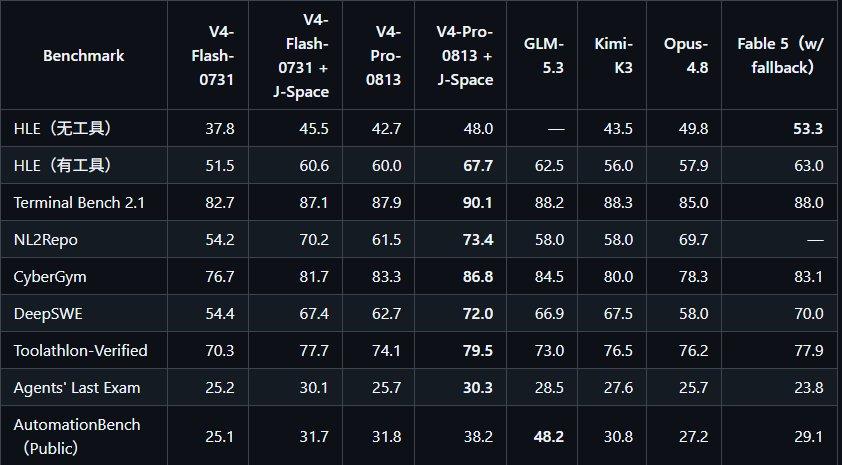
🚀 DeepSeek V4 Pro внезапно стал заметно сильнее - без переобучения модели К DeepSeek V4 Pro 0813 подключили harness под названием J-Space, который снижает ошибки в длинных цепочках reasoning и tool use. По опубликованным результатам прирост местами очень серьёзный: * Terminal Bench: 87.9 → 90.1 * NL2Repo: 61.5 → 73.4 * CyberGym: 83.3 → 86.8 * DeepSWE: 62.7 → 72.0 * Toolathlon: 74.1 → 79.5 В ряде agentic/coding тестов такая связка якобы обходит даже Fable 5 и Opus 4.8. https://github.com/Tiger3807861189/DeepSeek-V4-J-Space-Capability-Realization-Report
DeepSeek V4 Pro получил прирост производительности через J-Space

Участие в соревновании Kaggle с помощью ИИ

D@datastorieslanguagesAI-инженер
2 мес
​​Kaggle: Rogii https://www.kaggle.com/competitions/rogii-wellbore-geology-prediction/leaderboard В последние месяцы я впервые за несколько лет серьёзно участвовал в соревновании на каггле. Это было геодезическое соревнование. В итоге мы оказались в серебре и избежали шейкап. Моё соло решение тоже тянуло на серебро, но лишь на ~200 место. Блогпост с деталями напишу позже, а пока вот красивые картинки от клода. Кстати, я не написал ни одной строчки кода - всё участие было через клод/кодекс. Теперь буду отдыхать и зарекаюсь участвовать в каггле ещё на несколько лет 😅 #kaggle #ai

DeepSeek выпустила обновленную модель V4-Flash-0731

Компания DeepSeek представила обновленную версию модели V4-Flash-0731, которая вышла в публичную бету API. Модель сохранила архитектуру с 284 млрд параметров (13 млрд активных), но прошла через новый этап пост-тренинга, сфокусированный на агентных задачах, кодинге и рассуждениях.

Обновление значительно улучшило производительность модели, позволив ей конкурировать с топовыми решениями уровня GLM-5.2, Opus 4.8 и GPT-5.5, при этом предлагая существенно более низкую стоимость использования. Модель уже доступна для интеграции через API и локального запуска.

284Bобщее количество параметров модели
$0.28стоимость миллиона выходных токенов
1 млнмаксимальный размер контекстного окна

Полный разбор →

Как экономить контекст при работе с AI-агентами для рефакторинга

A@ai_coder_channelAI-инженер
2 мес

AI-агент CommandCode занял лидирующие позиции в рейтинге OpenRouter

С@exitsexistавтор про «startups»
3 мес
Наша портфельная компания обогнала Claude Code среди coding-агентов 🔥 На прошлой неделе AI-агент CommandCode вошел в топ OpenRouter. Это независимая площадка, которая ранжирует агентов по тому, сколько людей реально ими пользуются и платят за них. • #1 среди трендовых coding-агентов, • #3 в глобальном рейтинге coding-агентов, • #2 в productivity, • #1 в категориях Programming App, IDE Extensions и Native App Builders. Команда делает ставку на open-source LLM: продукт работает на открытых моделях, поэтому разработка выходит в 10-100 раз дешевле, чем на закрытых GPT/Claude. Очень рад за нашу портфельную компанию!

Обзор бенчмарка Senior SWE-Bench

A@ai_productAI-инженер
3 мес
И вот это интересный бенчмарк разработческий - по реально сформулированным задачам и с ожиданием определенного "синьорного качества" - Senior SWE-Bench В лидерах Opus 4.8, Sonnet 5 (но читерит много), GPT-5.5 https://senior-swe-bench.snorkel.ai/

Результаты бенчмарков моделей в Cursor

A@ai_productAI-инженер
3 мес
Результаты Fable и Sonnet в бенчмарках Cursor (реальных разработческих задачах) Fable просто всех порвал. Можно ставить medium effort даже и получать результаты лучше всех остальных. По эффективности за доллар нормчик GPT-5.5 extra high и их собственнный Composer 2.5. Китайские подотстали... https://cursor.com/evals
Ещё ↓