Что просить у агента, кроме кода?
На AI Natives один из участников рассказывал, как с помощью AI учился играть в одну из разновидностей покера. Получить расчёт хорошего хода было лишь частью задачи: ему самому надо научиться принимать решения за столом.
Но запомнить тысячи ситуаций и вложенных «если» сложно. Поэтому он с AI выделял понятные правила: сначала определить тип раздачи (одна пара, две пары, без пары), затем пройти несколько шагов для этого типа. Где правило получалось слишком сложным, разбирали примеры. А потом сделали тренажёр: человек выбирает ход, получает объяснение ошибки и чаще встречает ситуации, в которых ошибается.
Это в тему размышлений в
посте про изобилие кода. В
Математике 2.0 есть две схемы: в одной AI получает решения, обходя человеческое понимание; в другой - помогает это понимание развивать.
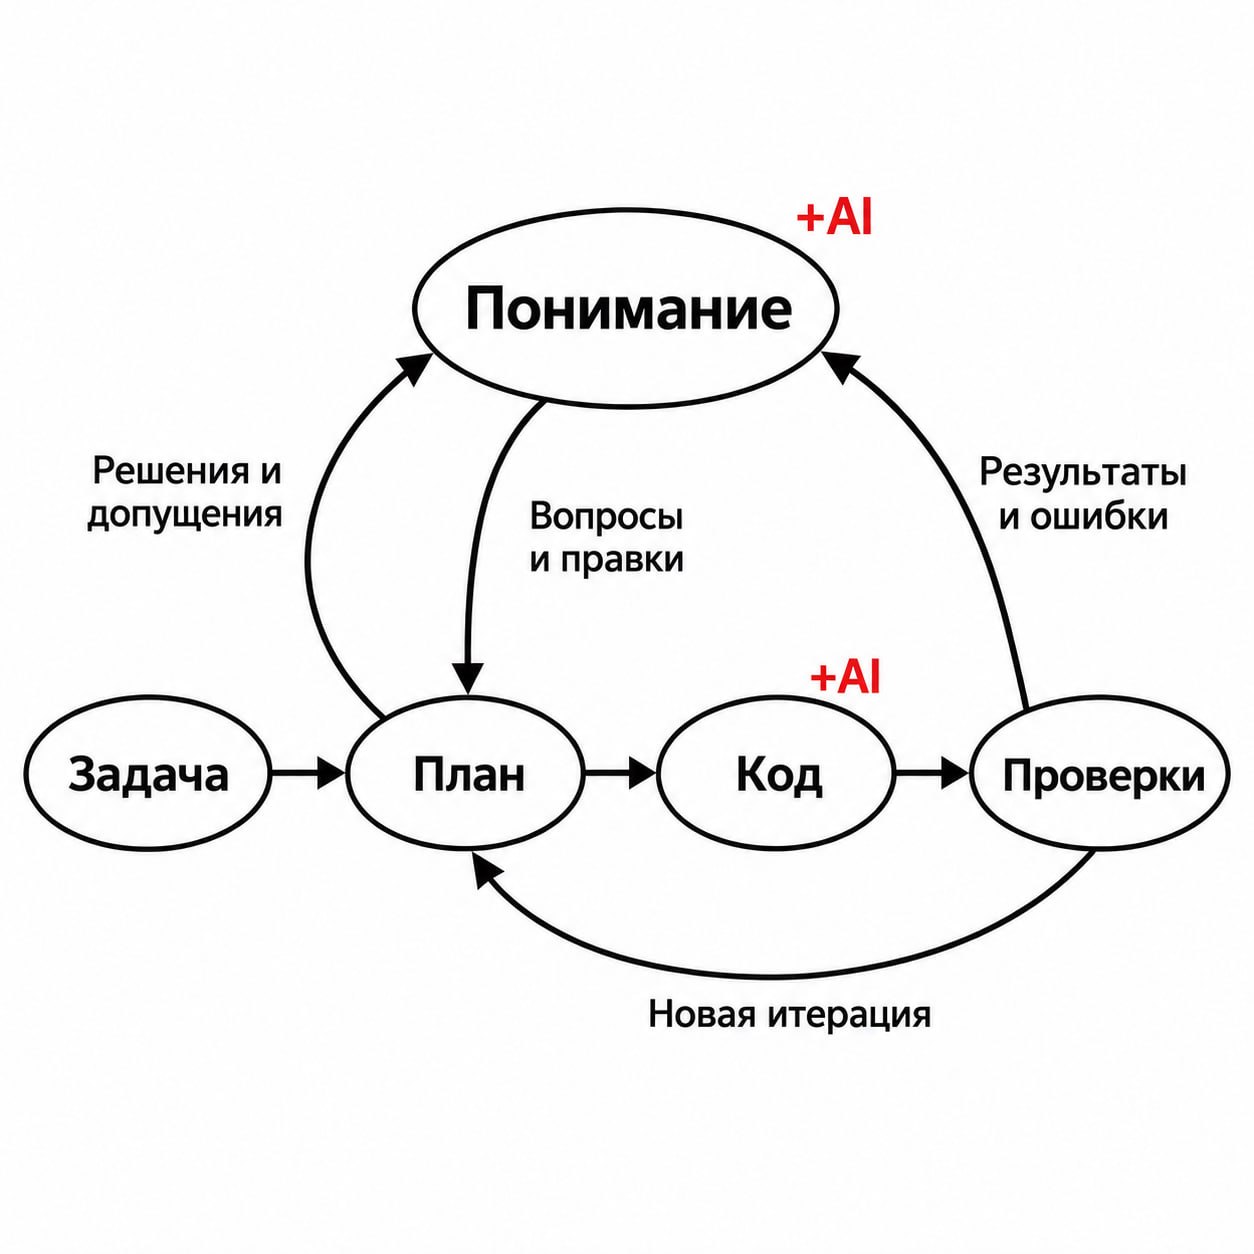
В разработке похожая история: пока делаешь фичу, уточняешь требования, замечаешь исключения, узнаёшь что-то о пользователе, или о работе ранее неизвестного тебе модуля. Если эта работа уходит к агенту, понимание уже не обязательно появляется по дороге. Значит, стоит отдельно устроить процесс, в котором мы его приобретаем.
В
первом посте был пример одноразового софта —> глубина понимания очевидно зависит от срока жизни продукта, цены ошибки и того, насколько легко всё откатить.
Для игры под один вебинар мне важно понимать правила модели и где она может ввести участников в заблуждение. А масштабирование на миллионы пользователей и архитектура на десять лет ей точно не нужны :)
В CRM, от которой зависят работа команды и данные клиентов, уже важно понимать правила процессов, как обнаружить ошибку и восстановить данные.
На больших задачах я стараюсь получать это понимание по ходу работы агента:
1) Сначала прошу план в виде артефакта, который можно читать и комментировать: варианты, ключевые решения, данные и допущения. Задаю вопросы и оставляю правки до реализации.
2) Проверяю важные допущения. Например, агент с помощью regex-а пытается отлавливать ответы клиента и обновлять CRM.
3) Прошу уменьшить зависимость от неизвестного. Допустим, размер компании не найден: можно оставить «неизвестно», попробовать другой источник или передать человеку. Или вместо regex-ов заюзать jev/decisions api.
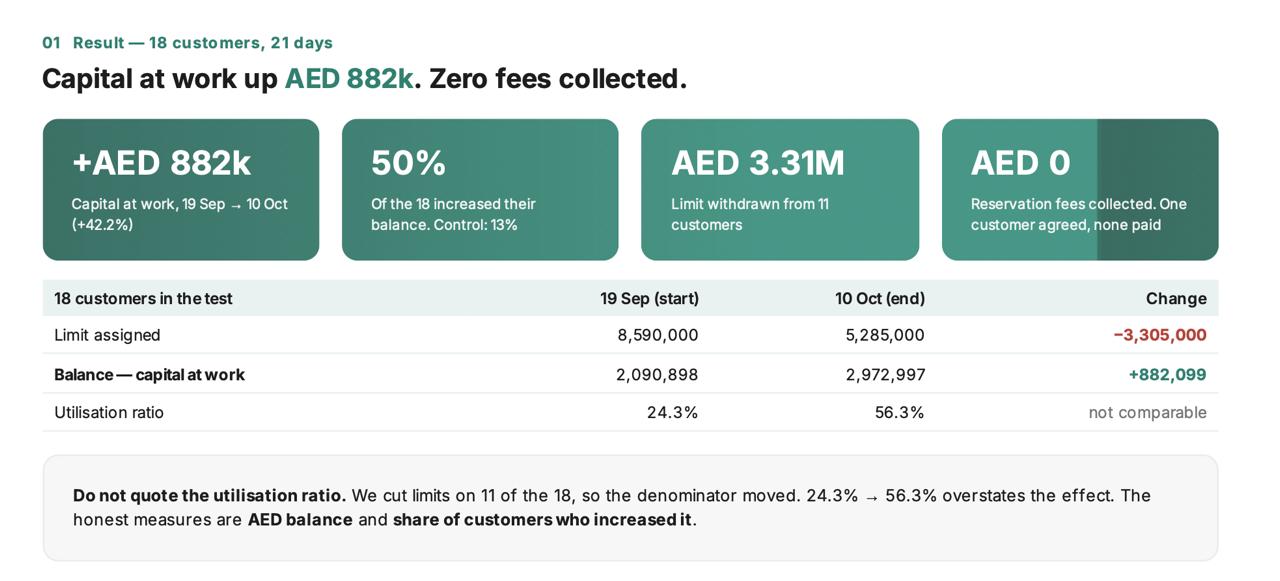
4) После реализации прошу отчёт о тесте и прогоне на реальных кейсах: GIF-ки, скриншоты и описание процедуры. Так я вижу, что проверяли и какие сценарии выпали. Например, что сделал агент с лидом, размер компании которого неизвестен? Или «22-го подойдёт?» ещё не значит, что встреча согласована. Разбираем ошибку, уточняем правило, добавляем тест.
Что хочу сделать системнее: часть случаев заранее оставлять за пределами настройки, а потом разбирать расхождения на них. Где ошибся агент, где не хватило данных, а где стоит пересмотреть само правило?
И план, и отчёт мне удобнее оформлять в HTML и оборачивать в артефакт, со схемами и возможностью покрутить сценарии. Мне особенно удобно комментировать конкретный кусочек. Антропики публиковали по теме
полезное, кстати
Попробуйте на следующей большой задаче попросить два артефакта: план с ключевыми решениями и отчёт о проверках. Выберите одно важное допущение, попросите показать, что изменится, если оно неверно, и проверьте, есть ли этот случай в отчёте.
А потом задайте себе вопрос: улучшилось ли ваше понимание?