llmСбросить фильтр ×

Развитие системы Ouroboros: внедрение инвариантов защиты и архитектуры Self-Evolving AI

T@kryak_startupAI-инженер
1 мес
DeepSeek представила мультимодальную модель V4.1 Flash

AI-редакция
22 источника · показать все· свернуть
Machine learning InterviewВыпущена промежуточная модель DeepSeek V4.1 FlashData SecretsВышел DeepSeek-V4.1-FlashCodeCampВыход модели DeepSeek V4.1 FlashНейронавт | Нейросети в творчествеDeepSeek V4.1 Flash: переход к нативной мультимодальностиFuturisDeepSeek представили модель V4.1-FlashGPT/ChatGPT/AI Central Александра ГорногоDeepSeek выпустил модель V4.1 FlashАгенты ИИ | AGI_and_RLРелиз мультимодальной модели DeepSeek-V4.1-FlashMachinelearningDeepSeek выпустила модель V4.1 FlashМетаверсище и ИИщеDeepSeek представил мультимодальную модель DeepSeek-4.1 FlashМетаверсище и ИИщеDeepSeek представил мультимодальную модель DeepSeek-4.1 Flashvc.ruDeepSeek выпустила мультимодальную модель V4.1 FlashAI Product | Igor AkimovDeepSeek выпустил модель V4.1 FlashPpprompt | Sexy AI Prompts & Experiments | by @ponchiknewsВышла мультимодальная модель DeepSeek-V4.1-FlashPpprompt | Sexy AI Prompts & Experiments | by @ponchiknewsDeepSeek выпускает модель v4.1 Flash с новой архитектуройКод.руDeepSeek представила модель V4.1 Flash3DNewsDeepSeek представила модель V4.1-FlashКПДDeepSeek-V4.1-Flash: новый техрепорт и оптимизация KV-кэшаКПДОбзор архитектурных особенностей и метрик DeepSeek-V4.1-FlashMachinelearningDeepSeek открыла веса мультимодальной модели V4.1-FlashNEURO-AI Новости ИИDeepSeek выпустила модель V4.1 Flash с поддержкой 1 млн токеновХайтек+DeepSeek выпустила модель DeepSeek-V4.1-FlashAI-Driven Development. Родион МостовойАнализ производительности и галлюцинаций DeepSeek 4.1 Flash
мега-хайп · 22обновлено 1 мес назад

Компания DeepSeek выпустила V4.1 Flash — новую мультимодальную модель с архитектурой Mixture-of-Expertsi (MoE), объединяющую возможности работы с текстом, изображениями и сложными рассуждениями. Модель поддерживает контекстное окно до 1 миллиона токенов и оптимизирована для агентных задач.

Новинка призвана заменить предыдущие версии (Instant, Expert, Vision) и временно берет на себя запросы, направляемые к флагману V4 Pro, который будет отключен 14 сентября. Разработчики заявляют о превосходстве V4.1 Flash над предшественниками по скорости, стоимости и качеству ответов.
552 млрдобщее количество параметров модели
1 млнмаксимальный объем контекстного окна
14 сентябрядата отключения модели V4 Pro

Полный разбор →

Влияние LLM на процесс мышления и структурирование задач

f@c3po_notesмедиа / агрегатор
1 мес
Тут осознал, что теперь, когда думаю, как решить задачу, первым делом думаю не о самом решении, а о том, как я опишу эту задачу ллмке. И в этом, неожиданно, есть плюс: ты сразу мыслишь так, чтобы об этом можно было внятно рассказать. Мне как человеку, которого обычно понимают не все, это сильно помогает. Обычный пайплайн — это переваривать инфу внутри оптимальным твоему мозгу способом, а как донести это до других, разбираться уже потом. Другое дело, когда ты сразу структурируешь мысль так, чтобы она была понятна другим людям. А учитывая, что ллмки порой тупят, описывать получается достаточно понятно

Дистилляция DeepSeek-R1: как обучить компактные модели рассуждениям

Д@stuffyNLPAI-инженер
1 мес
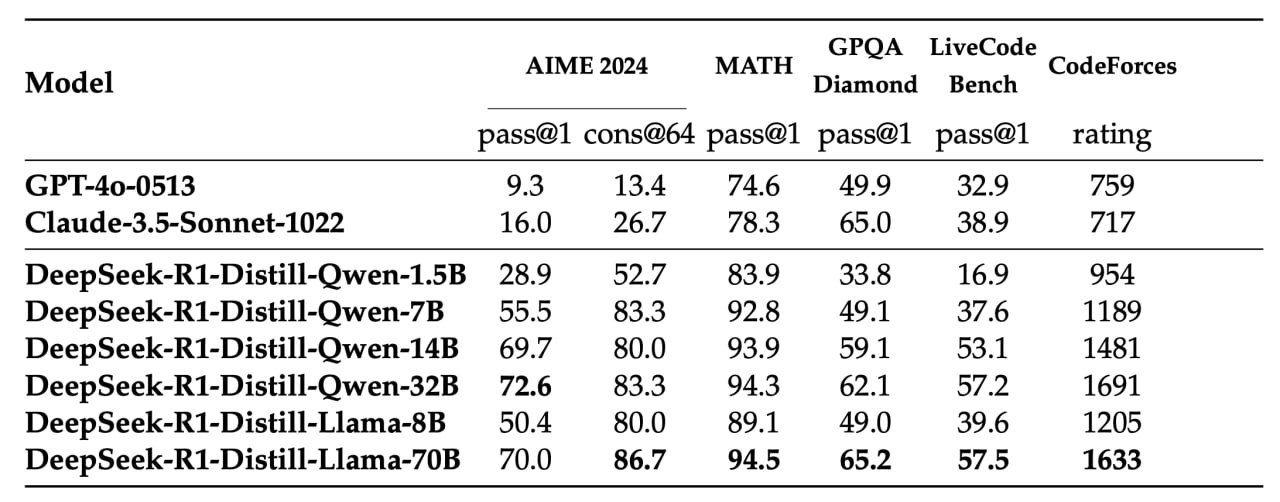
Дистилляция DeepSeek-R1: как обучить компактные модели рассуждениям

IFM представил линейку открытых моделей K2 Horizon

1 мес
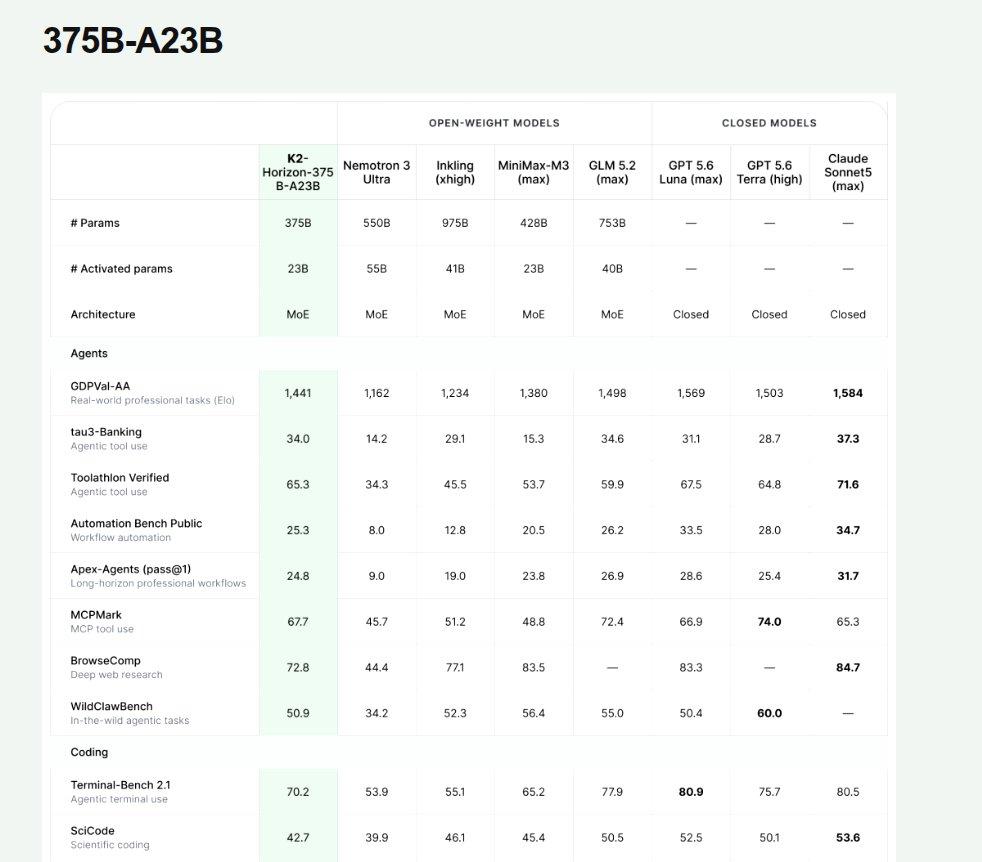
IFM представил линейку открытых моделей K2 Horizon

Сравнение производительности моделей GPT-6 и GPT-5.6

E@elkornacioAI-инженер
1 мес
в общем, окончательно откатился с gpt-6 на 5.6 во всех флоу. удивительное комбо overpromise-underdelivery. computer use сильно прокачался, в остальном - ппц. и вот беспрерывно подгонять его задолбало ужасно. если 5.6 делает лишнее в 2 случаях из 10, то 6 не делает нужного в 5 случаях из 10, крайне неудобно. ещё и новые 200-баксовые подписки не дают из-за этого, уф.

Архитектурные инновации в DeepSeek-V4: Engram, DSpark и оптимизация KV-кэша

К@quant_prune_distillAI-инженер
1 мес

Выступление на Applied Machine Learning for Cyber Security Conference в Лондоне

L@lovedeathtransformersAI-инженер
1 мес

Поиск доступных API для круглосуточной работы LLM

E@elkornacioAI-инженер
1 мес
господа, запрос во вселенную хочу найти какую-нибудь подписку с умеренной ценой (типа ~$50), и почти бесконечным запасом токенов на условно тупых моделях не прям тупых-тупых, а что-то типа luna/terra чисто под песочницу для каких-нибудь безумных игр в формате /goal и работы 24-7 швырять туда какие-нибудь самые отлетевшие идеи и задачи на тест, и чтобы не сильно дорогая модель сутками их тарабанила до бесконечности. знаете что-нибудь такое? мне кажется, тот же openai за $200 вполне потянул бы luna на 24/7 держать, но $200 чутка жалко, хочется подешевле

Опыт Anthropic в разработке AI-агентов для e-commerce

С@startupofthedayавтор про «startups»
1 мес

Как AI-агенты помогли взять серебро на Kaggle

D@datastorieslanguagesAI-инженер
1 мес

Google представил метод SKILL.state для оптимизации токенов в AI-агентах

G@aiofthedayAI-инженер
1 мес

Qwen 3.8 Flash Next: модель на 125 млрд параметров запускают на 6 ГБ VRAM, но независимые тесты показывают разочаровывающий результат

AI-редакция
3 источника · показать все· свернуть
разгоняется · 3обновлено 1 мес назад

Alibaba выпустила Qwen 3.8 Flash Next — MoEi-модель на 125 млрд параметров с необычным механизмом n-gram embedding-таблицi, которые можно выгружать на диск или в оперативную память. Благодаря этому модель удалось запустить на обычной RTX 4090 с пиковым расходом всего 5,95 ГБ VRAMi — без квантизации и дистилляции, притом полный checkpoint, а не урезанная демо-версия.

Однако независимое тестирование показало противоречивую картину: блогер Галера Морева после 4 часов проверки не увидел разницы в интеллекте между Qwen 3.8 Flash Next и плотной моделью Qwen 3.8, при этом ресурсные требования у Flash Next оказались куда выше. По его словам, тест на роль «ассистента» модель не прошла.
125 млрдпараметров модели
5,95 ГБпиковый расход VRAM на RTX 4090
360 ГБразмер полного checkpoint в bf16

Полный разбор →

Что такое внутренние модели OpenAI и как работает дистилляция

А@airamongushAI-инженер
1 мес

Гипотеза о возникновении ИИ через роевой интеллект агентов

С@svyatamestoAI-инженер
1 мес
Гипотеза о возникновении ИИ через роевой интеллект агентов
Ещё ↓