DeepSeek-V4.1-Flash: новый техрепорт и оптимизация KV-кэша
К@quant_prune_distillAI-инженер
1 месDeepSeek представили новую версию мультимодальной MoE-модели DeepSeek-V4.1-Flash с акцентом на инженерные оптимизации KV-кэша.
Новые методы сжатия памяти позволяют запускать более мощные нейросети на меньшем железе.
- Оптимизация KV-кэша снижает требования к видеопамяти при работе с длинными контекстами.
- Технические решения DeepSeek часто становятся стандартом для индустрии открытых моделей.
- Повышается эффективность работы мультимодальных моделей в реальном времени.
DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression
📄 Техрепорт
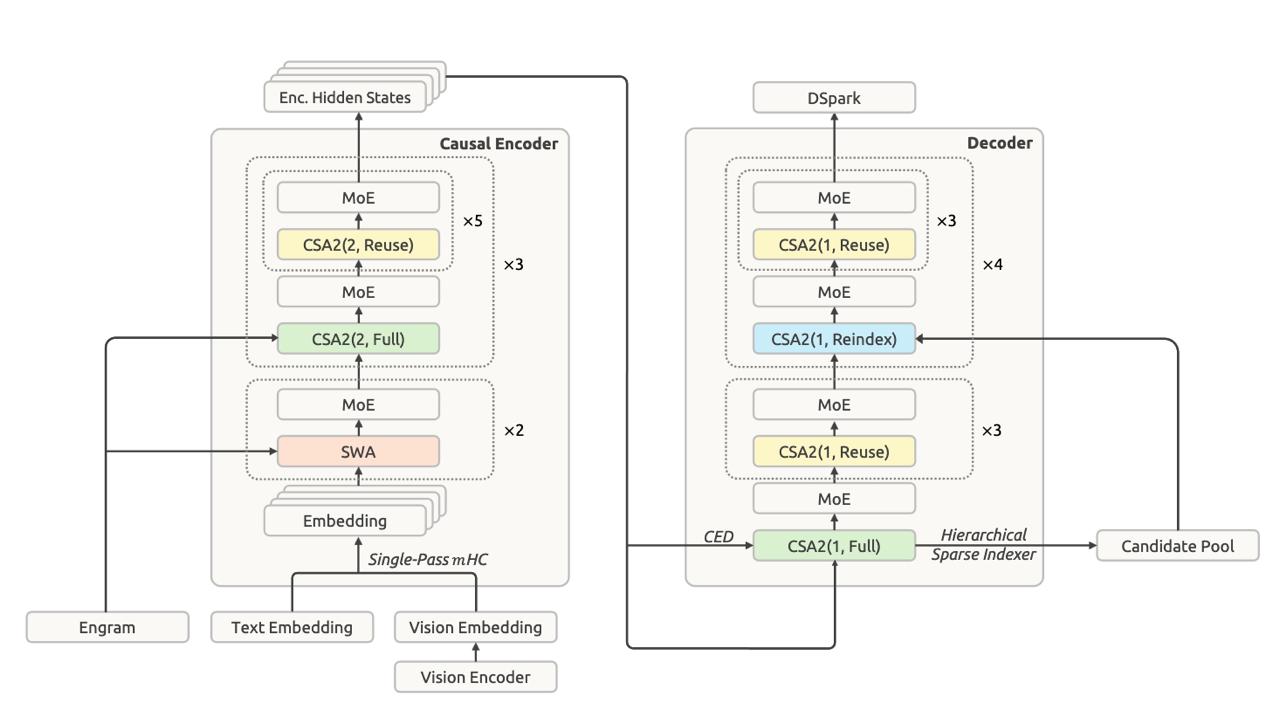
Ребята из Дипсика выкатили новую версию своей мультимодальной МоЕшки с сопутствующим техрепортом. И, как это любят и умеют делать только китайцы, нагородили всяческой инженерии по самое мама не балуй.
Кратко (AI)
Компания DeepSeek выпустила новую мультимодальную модель DeepSeek-V4.1-Flash. Технический отчет описывает глубокие инженерные решения, направленные на оптимизацию сжатия KV-кэша.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖