Анализ эффективности новой модели с разреженностью 1:70
L@lovedeathtransformersAI-инженер
1 месКраткий обзор характеристик новой модели: архитектура MoE, рецепт UL2 и производительность на уровне Qwen3.5 4-8b при высокой разреженности 1:70.
Развитие методов разреженных нейросетей позволяет достигать высокой производительности при меньших вычислительных затратах.
- Архитектура MoE (Mixture of Experts) оптимизирует использование параметров модели.
- Высокая разреженность (1:70) значительно снижает требования к памяти и вычислениям.
- Результаты показывают, что компактные модели могут конкурировать с более крупными аналогами.
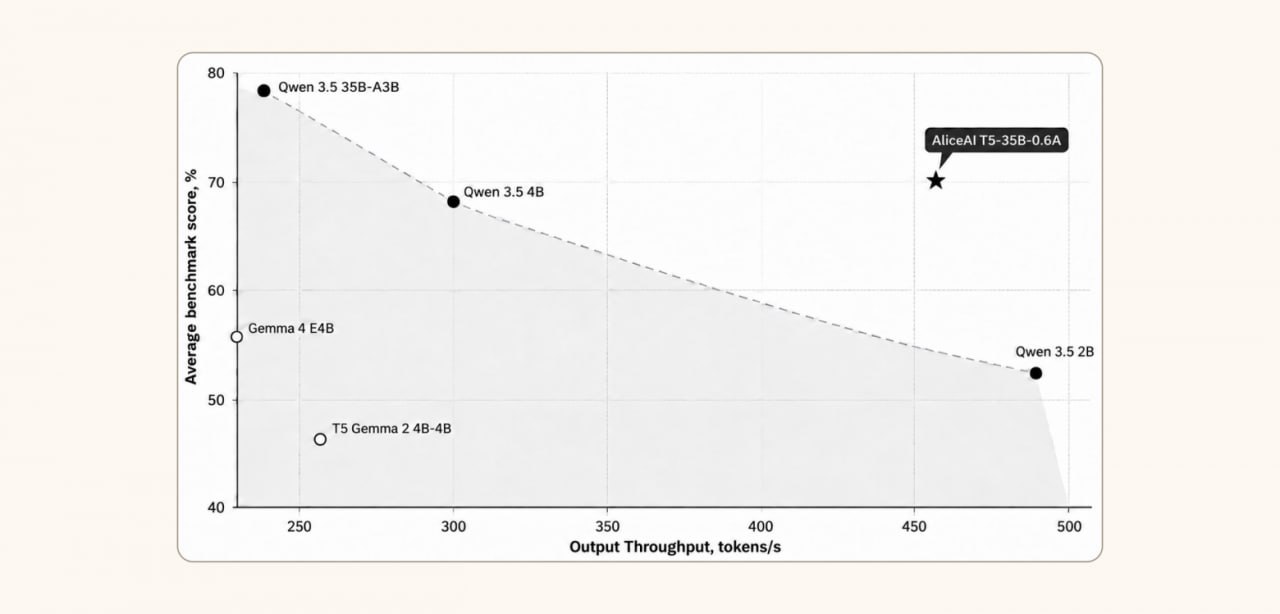
вообще удивительно, sparsity 1:70, MoE t5, ul2 рецепт и метрики на уровне 4-8b qwen3.5
hf
Кратко (AI)
Автор отмечает высокую эффективность новой модели, использующей архитектуру MoE и рецепт обучения UL2. При уровне разреженности 1:70 модель демонстрирует метрики, сопоставимые с Qwen3.5 в диапазоне 4-8 миллиардов параметров.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖