Вышла мультимодальная модель DeepSeek-V4.1-Flash
P@pppromptAI-инженер
1 месDeepSeek представила мультимодальную модель DeepSeek-V4.1-Flash с поддержкой 1 млн токенов, оптимизацией KV cache и высокой производительностью.
Новая модель предлагает высокую производительность при значительно более низкой стоимости обработки данных.
- Снижение затрат на использование API для работы с большими объемами данных.
- Улучшенная эффективность обработки длинного контекста благодаря оптимизации KV cache.
- Конкурентоспособные показатели в специализированных бенчмарках по сравнению с текущими лидерами рынка.
Вышла DeepSeek-V4.1-Flash, новая мультимодальная модель для агентных задач
Она работает с текстом и изображениями, поддерживает контекст до 1 млн токенов и построена так, чтобы дешевле обрабатывать большие входные данные: модель сильно сжимает KV cache и активирует только часть параметров на каждом токене.
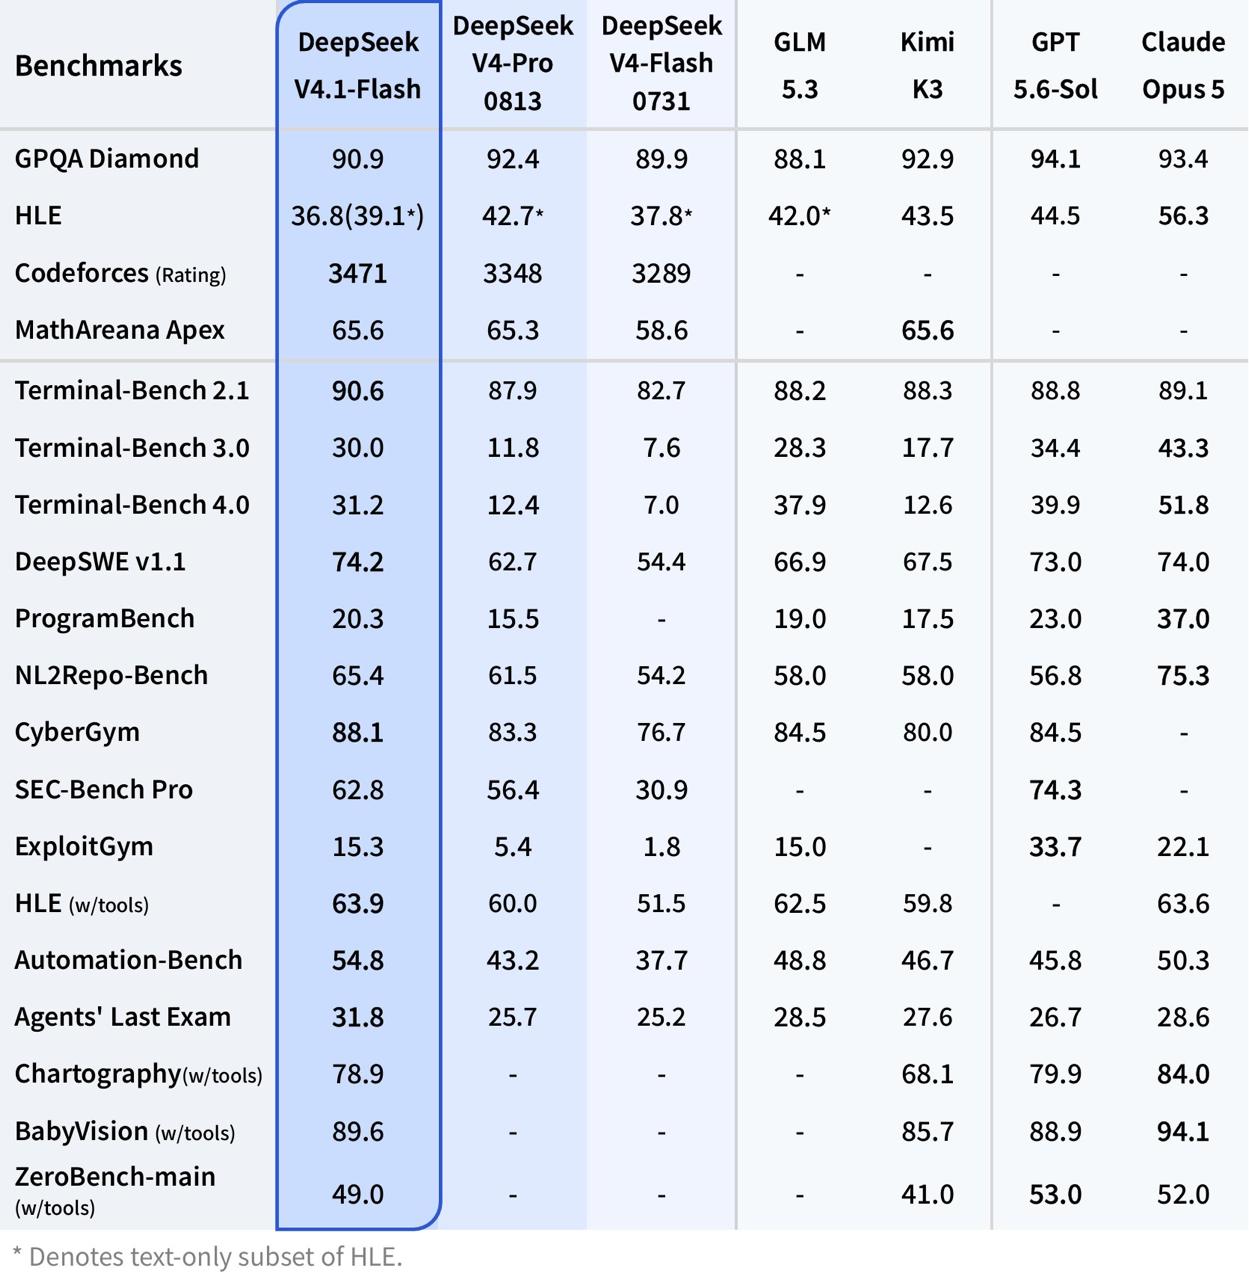
По бенчмаркам DeepSeek ставит её рядом с топовыми моделями: на Terminal-Bench 2.1 модель набрала 90,6% против 89,1% у Opus-5.0 и 88,8% у GPT-5.6 Sol. При этом цена заметно ниже: $0.30 за 1 млн входных токенов и $1.20 за 1 млн выходных, а вне пиковых часов ещё в 2 раза дешевле.
🔗 https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
@ppprompt
Кратко (AI)
Компания DeepSeek выпустила новую мультимодальную модель DeepSeek-V4.1-Flash, предназначенную для агентных задач. Модель поддерживает контекстное окно в 1 млн токенов, использует оптимизацию KV cache и демонстрирует высокие показатели в бенчмарке Terminal-Bench 2.1 при низкой стоимости использования.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖