DeepSeek представили модель V4.1-Flash
F@FuturisAI-инженер
1 месDeepSeek выпустили модель V4.1-Flash с поддержкой изображений, контекстом 1 млн токенов и оптимизированным потреблением памяти GPU.
Появление доступных и быстрых моделей с большим контекстом снижает стоимость автоматизации сложных задач.
- Снижение стоимости обработки больших объемов данных через API.
- Улучшенная работа с длинным контекстом при меньших требованиях к видеопамяти.
- Возможность интеграции мультимодальных функций в бюджетные проекты.
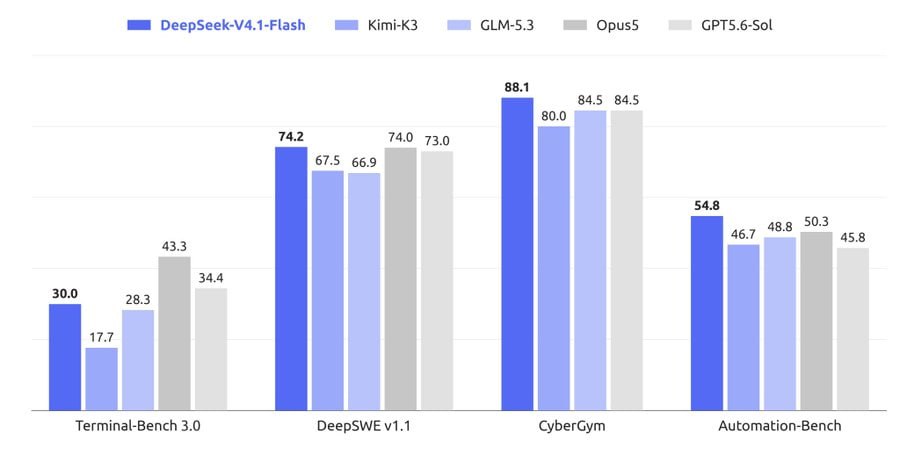
DeepSeek выкатили V4.1-Flash с пониманием картинок и контекстом на миллион токенов. Новая архитектура снижает затраты на обработку запросов, а кэш контекста занимает в четыре раза меньше памяти GPU. По тестам компании, модель обгоняет ряд флагманов в отдельных задачах кодинга и автоматизации, но независимых подтверждений пока нет.
Доступна по API. Миллион входных токенов без кэша стоит $0,15–0,30, выходных $0,60–1,20 в зависимости от времени нагрузки.
Я уже затестил, впечатляет только мгновенная скорость, но не результат, хотя стало получше чем в прошлой версии. Но для небольших, простых задач самое то👌
https://x.com/deepseek_ai/status/2097930608790167907
Кратко (AI)
Компания DeepSeek представила новую модель V4.1-Flash, поддерживающую работу с изображениями и контекстное окно в 1 миллион токенов. Архитектура модели оптимизирована для снижения затрат на вычисления и потребления памяти GPU, а доступ к ней уже открыт через API.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖