Анализ производительности и галлюцинаций DeepSeek 4.1 Flash
A@ai_drivenAI-инженер
1 месРазбор результатов DeepSeek 4.1 Flash в бенчмарке AA-Omniscience, сравнение с GLM-5.3-Flash и важность внедрения автоматизированных evals.
Выбор LLM для бизнеса требует проверки на собственных данных, а не только на публичных бенчмарках.
- Популярные модели могут показывать отличные результаты в тестах, но быть склонными к выдумкам (галлюцинациям) в реальных задачах.
- Отсутствие автоматизированных тестов (evals) лишает компанию возможности безопасно переходить на более дешевые и эффективные модели.
- Использование RAG-агентов требует тщательного тестирования базовой модели на устойчивость к ошибкам при отсутствии релевантной информации.
DS 4.1 Flash и галлюцинации
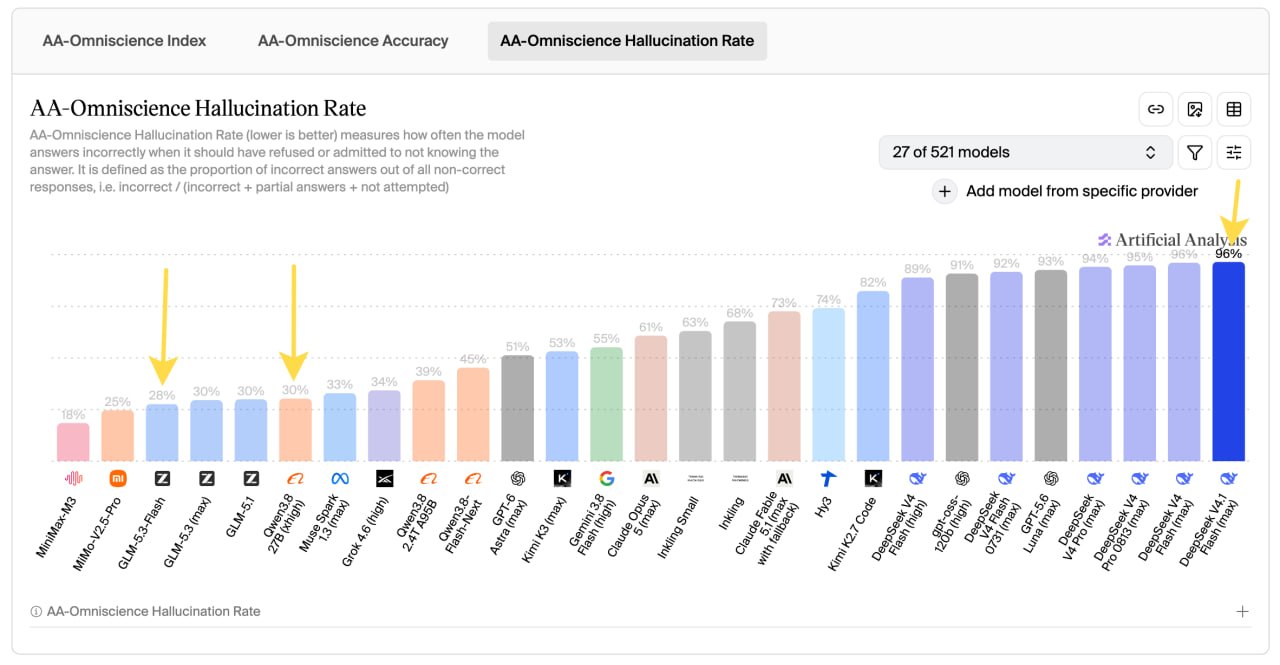
Там новый дипсик впечатляющие результаты показывает на бенчах и вообще выглядит как новый победитель по Парето-фронт (наиболее оптимальная модель по соотношению цены и качества). Но есть один нюанс, о котором мало кто говорит - это показатель модели в бенчмарке AA-Omniscience. И из топовых моделей довольно слабый результат: -5 в общем забеге (AA-Omniscience Index) и 95% в рейтинге галлюцинаций, и это прям антирекорд. Для сравнения у GLM-5.3-Flash 7 в AA-Omniscience Index и 28% показатель галлюцинаций.
Понятно, что AA-Omniscience измеряет родные знания моделей, без внешних tools - тем не менее, если ваш RAG агент все-таки не найдет релевантное, дипсик с большей вероятностью выдумает ответ.
Ну и конечно, напомню, что всегда следует проверять новые модельки на ваших evals, измеряющих возможности модели в ваших конкретных задачах - сейчас наличие таких бенчмарков особенно важно, т. к. новые модели выходят практически каждый месяц и потенциально могут уменьшить расходы компании на LLM в разы, не теряя при этом в качестве. Поэтому когда я на консультациях узнаю, что у команда до сих пор нет автоматизированных evals, это удивляет - ведь без них компания теряет как в деньгах, так и в качестве и вообще приходится двигаться практически вслепую. Гибкость, кстати, тоже уменьшается, т. к. с ручными проверками эксперименты становятся слишком трудозатратными, да и попросту необъективными.
А возвращаясь к ds flash - предыдущая версия на наших бенчмарках работала очень медленно нестабильно, и от коллег тоже слышал подобные отзывы. Поэтому конкретно дипсики еще более важно тщательно тестировать.
А как вам DeepSeek 4.1 Flash? Особенно интересно как она себя показала на ваших бенчмарках.
@ai_driven
Кратко (AI)
Автор анализирует новую модель DeepSeek 4.1 Flash, отмечая её высокие показатели в стандартных тестах, но критически низкие результаты в бенчмарке AA-Omniscience, где модель демонстрирует высокий уровень галлюцинаций. В посте подчеркивается необходимость использования собственных автоматизированных evals для проверки моделей перед внедрением в бизнес-задачи.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖