ttsСбросить фильтр ×

Inworld лидирует в рейтинге Text-to-Speech

A@ai_productAI-инженер
1 мес
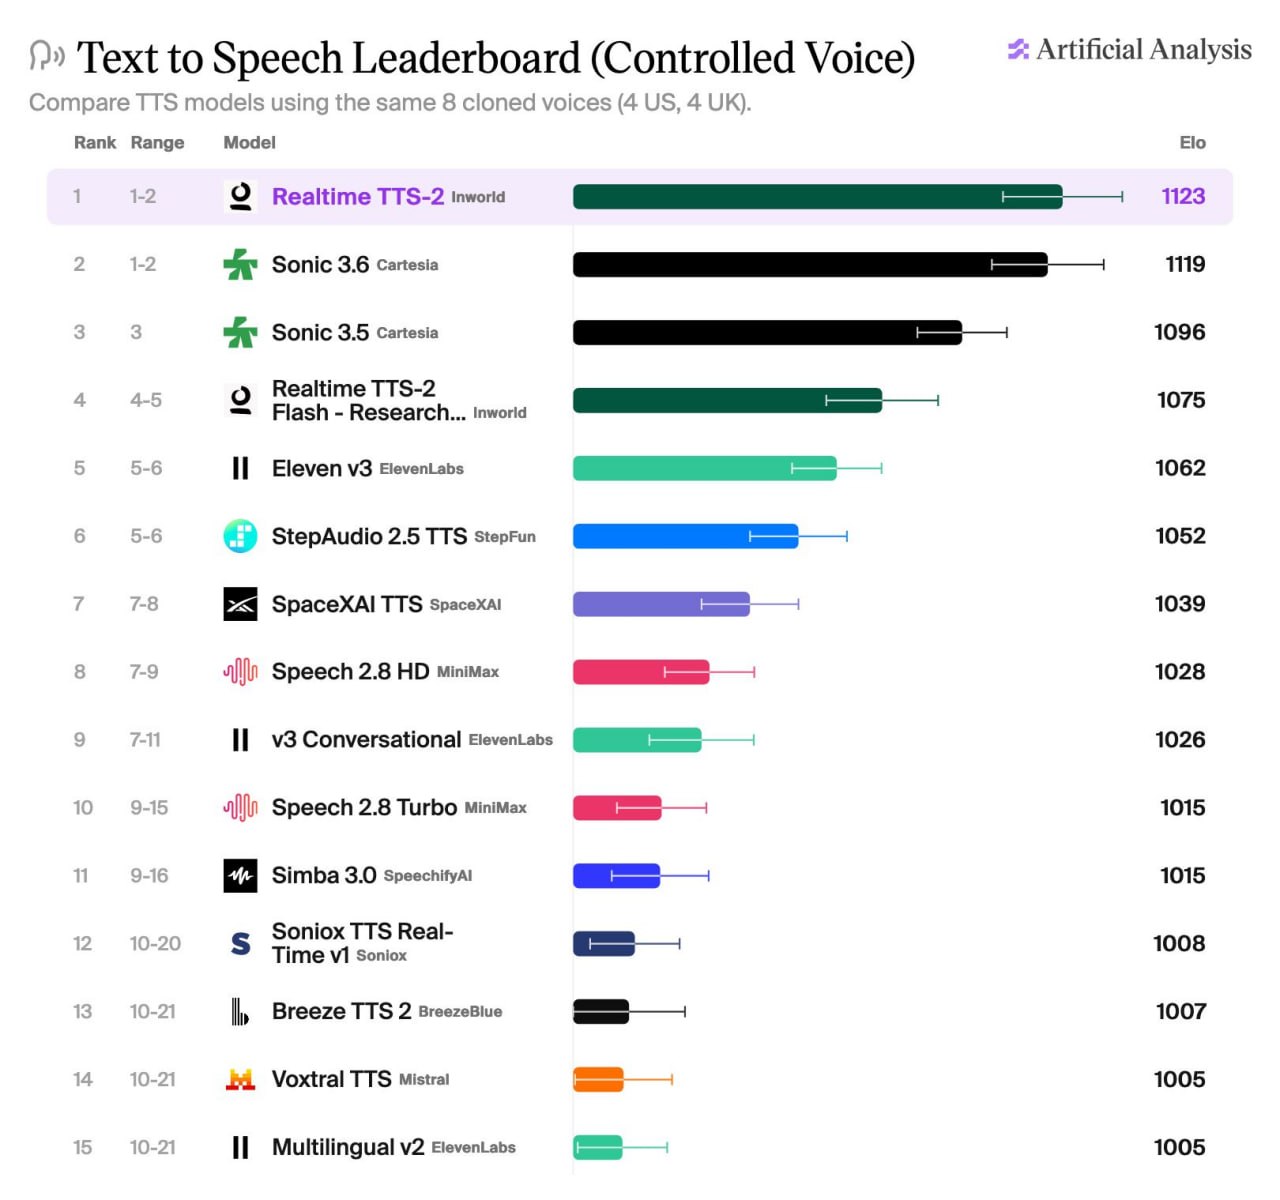
Text-to-speech от Inworld снова на первом месте по качеству. Очень рад за ребят. Я проводил интервью с их CSO и надеюсь доберусь до монтажа на этой неделе. Там много интересного, как маленькая лаборатория обходит грандов. И прикольно как уже 2 вендора обходят ElevenLabs, при том что Inworld стоит $20 за 1 миллион символов, а ElevenLabs - $100 https://artificialanalysis.ai/text-to-speech/leaderboard/controlled-voice
Inworld лидирует в рейтинге Text-to-Speech

ICE-012 Audio: многоязычная модель клонирования голоса

Н@GreenNeuralRobotsAI-инженер
1 мес
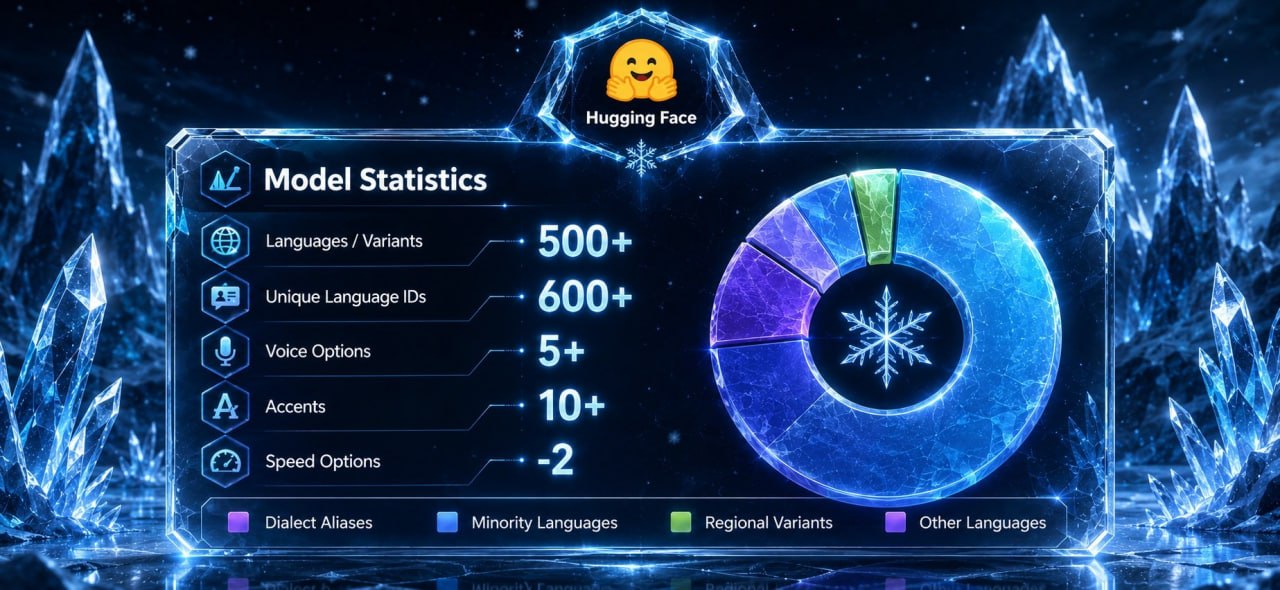
ICE-012 Audio (DarkPs) Многоязычная говорилка с клонированием голоса. 590 языков и диалектов, есть русский. - Клонирование голоса по 2 секундам - Управление голосом: пол, возраст, высота, акцент, стиль (шепот), скорость - Стриминг-генерация без ожидания полного файла - Активный акустический адаптер: обрабатывает кодек-эмбеддинги до и после основного блока Подходит для озвучки на редких языках, где коммерческие TTS отсутствуют #tts #russian #voicecloning VK | MAX
ICE-012 Audio: многоязычная модель клонирования голоса

Выпуск Sopro V2 Turbo: компактная модель для клонирования голоса

Н@GreenNeuralRobotsAI-инженер
1 мес
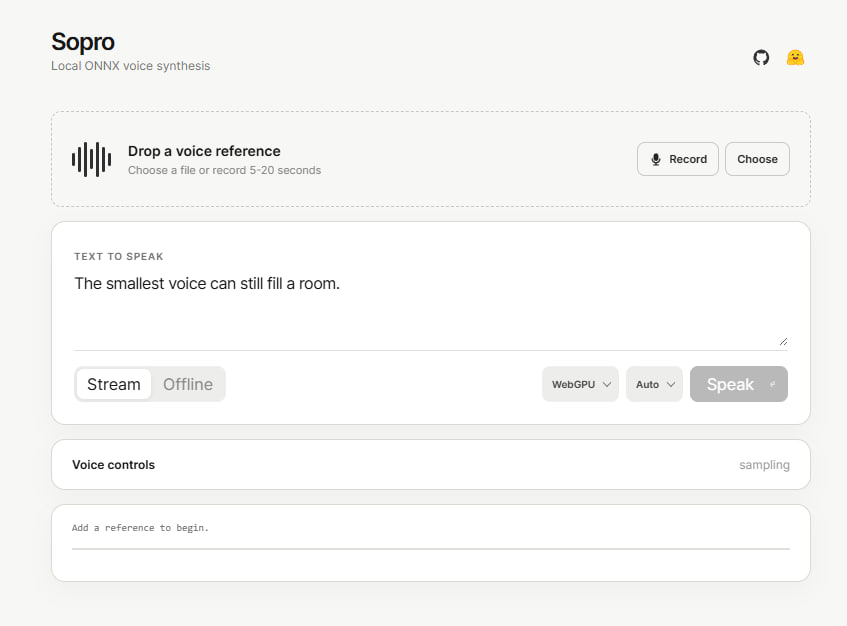
Sopro V2 Turbo Компактная говорилка на 120M параметров, клонирует голос по короткому образцу и работает полностью на устройстве • клонирование голоса по 5-20 секундам образца • первый звук уже через ~300 мс на обычном ноутбучном CPU • озвучка на английском, европейском португальском, французском и немецком • запуск локального веб-интерфейса одной командой uvx -from sopro soprotts serve • генерация в 5 раз быстрее реального времени на CPU Заточен под слабое железо - не нужен GPU и облако, голос клонируется прямо в браузере или на ноутбуке. Гитхаб HF Демо Демо HF #tts #compact #mobile VK | MAX
Выпуск Sopro V2 Turbo: компактная модель для клонирования голоса

Релиз Audio8 TTS Preview 0.1B

Н@GreenNeuralRobotsAI-инженер
1 мес
Audio8 TTS Preview 0.1B ONNX INT8 Компактная многоязычная говорилка с клонированием голоса по одному примеру. Работает на CPU без видеокарты. • RAM около 0.6 ГБ при загрузке основных сессий • звук на выходе 44,1 кгц, моно • скорость около 19 мс на токен медленной части и 8 мс на кадр быстрой 11 языков из коробки: китайский, кантонский, английский, французский, немецкий, итальянский, японский, корейский, польский, испанский, нидерландский Гитхаб HF #tts #voicecloning #compact VK | MAX
Релиз Audio8 TTS Preview 0.1B

Релиз Breeze TTS 2: модель для клонирования голоса и генерации речи в реальном времени

Н@GreenNeuralRobotsAI-инженер
2 мес
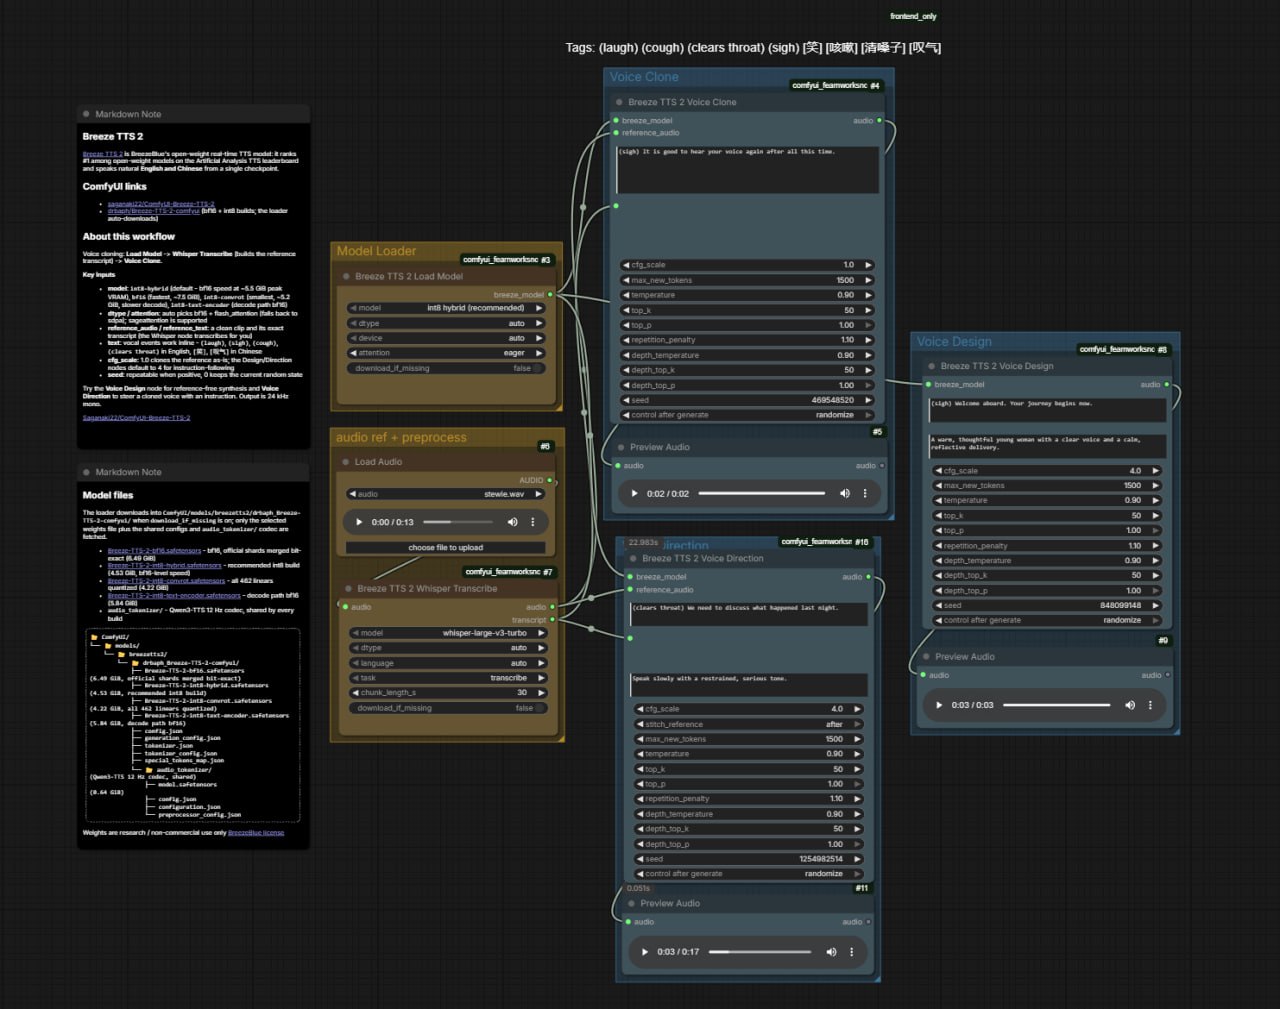
Breeze TTS 2 Рилтайм говорилка - Клонирование голоса: пара секунд речи + точная расшифровка → сохранение тембра, ритма, эмоций - Дизайн голоса без референса по промпту - Voice Direction: "говори медленно, серьезно" - голос остается, подача меняется - Вокальные события в тексте: (laugh), (cough), (sigh) - Стриминг с задержкой менее 40 мс до первого аудио, генерация в 3 раза быстрее реального времени - 3B, ~7.7 GB VRAM, min 12 GB GPU - английский и китайский Гитхаб HF Попробовать Демо Спасибо @m_franz #TTS #VOICECLONING #VOICEDESIGN VK | MAX
Релиз Breeze TTS 2: модель для клонирования голоса и генерации речи в реальном времени

Выход FireRedTTS3: новая модель для клонирования и редактирования голоса

Н@GreenNeuralRobotsAI-инженер
2 мес

Выход Raon-OpenTTS-1B: открытая zero-shot TTS-модель

Н@GreenNeuralRobotsAI-инженер
2 мес
Raon-OpenTTS-1B Открытая zero-shot TTS-модель. Клонирование голоса без дообучения - Работает в шуме, с эмоциями, разными акцентами и стилями речи - Встраивается в F5-TTS пайплайн - Две версии: 1B и 0.3B - Аудио: 80-канальный mel-спектр, 16 kHz Гитхаб HF Спасибо @m_franz #tts #voicecloning VK | MAX

Xiaomi представила MiDashengLM-Gen: генератор комплексных аудиосцен

2 мес
Xiaomi представила MiDashengLM-Gen: генератор комплексных аудиосцен

Speko: единый API и роутер для голосовых AI-моделей

A@ai_productAI-инженер
2 мес
Speko: единый API и роутер для голосовых AI-моделей

Выпуск TeraTTSv2: локальный движок синтеза речи

Н@GreenNeuralRobotsAI-инженер
2 мес

Интеграция Scenema Audio в ComfyUI

Н@GreenNeuralRobotsAI-инженер
2 мес
ComfyUI-ScenemaAudio Авторы говорилки Scenema Audio прикрутили ее в ComfyUI • клонирование голоса без обучения • генерация речи с эмоциями и интонациями по описанию • поддержка подсказок в квадратных скобках для эффектов • минимум 8 ГБ VRAM • скорость до 2x реального времени • при первом запуске качает ~30 ГБ весов Standalone Docker/API HF ComfyUI #TTS #voicecloning #voicedesign #comfyui

Выпущены GGUF-версии модели Qwen3-TTS

Н@GreenNeuralRobotsAI-инженер
2 мес
Qwen3-TTS-12Hz-1.7B-Base-GGUF Пачка GGUF версий говорилки Qwen3-TTS с клонированием голоса и управлением через текстовые инструкции.  - 4-bit Q4_K_M: размер файла 1.04 ГБ - 8-bit Q8_0: размер файла 1.85 ГБ - 16-bit BF16: размер файла 3.47 ГБ Спасибо @Endorpheen #tts #gguf

Alibaba выпустила Qwen-Audio-3.0-TTS — новую модель синтеза речи с поддержкой русского языка

Alibaba представила Qwen-Audio-3.0-TTSi — модель синтеза речи в двух версиях: Flash (для голосовых интерфейсов в реальном времени) и Plus (для генерации с упором на естественность и точную передачу тембра). Модель поддерживает 16 языков, включая русский, умеет клонировать голос по образцу и заняла 1-е место в рейтинге Artificial Analysis TTS Leaderboardi (версия Plus).

Голосом можно управлять как обычными текстовыми инструкциями («читай медленно», «как сказку перед сном», «голосом ведущей утреннего радио»), так и с помощью 86 встроенных тегов эмоций и звуков — например [angry], [whispers], [laughing], [sighing], [breaths]. Модель пока не выложена в open source, доступ продаётся через Alibaba Cloud.

16поддерживаемых языков
86тегов эмоций и звуков
3 минутымаксимум аудио за один проход

Полный разбор →

ByteDance выпустила Seed Audio 1.0 — модель для генерации целых звуковых сцен

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 3 мес назад

ByteDance Seed представила Seed Audio 1.0 — аудиомодель, которая по одному промпту генерирует целую звуковую сцену: речь, атмосферу и звуковые эффекты одновременно. Доступ к модели открыт через платформу BytePlusi.

Модель ориентирована на озвучку, подкасты и дубляж: она позволяет жёстко задавать тайминг репликi с точностью до 100 мс и создавать голоса как по текстовому описанию, так и по аудио- или визуальному референсу.

100 мсточность тайминга реплик
2 минутымаксимум аудио за один проход
20+ языковподдерживаемых моделью

Полный разбор →

Согласование контента о TTS с комплаенсом

g@grokaem_sebyмедиа / агрегатор
3 мес
Готовлю письмо для compliance, чтобы я могла законно писать здесь про tts. Мне конечно приятно, что имя техножрицы тут же выпадает, но я не такая крутая))) Вот так и путает он людей.

Открытый корпус выразительной русской речи Dialogs принят на Interspeech 2026

Илья Латышев и Борис (автор канала «Борис опять») подготовили статью «Dialogs: a studio-quality expressive conversational Russian speech corpus for dialog assistants», которую приняли на конференцию Interspeech 2026i. В основе статьи — открытый студийный корпус выразительной русской разговорной речи объёмом 20 часов, записанный тремя профессиональными актёрами театра с разметкой эмоций.

Особенность корпуса — актёры записывали диалоги, сидя друг напротив друга и видя мимику и жесты партнёра, хотя текст реплик был заранее подготовлен (scriptedi). Такой подход сделал речь заметно более естественной и эмоциональной по сравнению с записью дикторов по одному. Корпус предназначен в первую очередь для файнтюна моделей синтеза речи (TTSi) и распространяется по открытой лицензии для исследований.

20 часовобъём записанного корпуса
3профессиональных диктора-актёра

Полный разбор →

Статья о русском речевом корпусе Dialogs принята на Interspeech 2026

Команда с Ильёй Латышевым подготовила статью «Dialogs: a studio-quality expressive conversational Russian speech corpus for dialog assistants», которую приняли на конференцию Interspeech 2026i. В статье представлен открытый студийный корпусi выразительной русской разговорной речи, предназначенный в первую очередь для файнтюнiа моделей синтеза речи.

Особенность корпуса — способ записи диалогов: два актёра театра сидели друг напротив друга и читали заранее подготовленные реплики, видя мимику, жесты и эмоциональную реакцию собеседника, что сделало речь заметно более естественной и выразительной по сравнению с изолированной записью каждого диктора.

20 часовобъём речевого корпуса
3количество дикторов-актёров

Полный разбор →

Сравнение точности Apple SpeechAnalyzer и Whisper

Б@blognotAI-инженер
3 мес

Метрики задержки в TTS-системах

g@grokaem_sebyмедиа / агрегатор
3 мес

Hugging Face и Cerebras представили опенсорсного голосового агента

Н@GreenNeuralRobotsAI-инженер
3 мес
real-time voice AI Hugging Face и Cerebras собрали пример опенсорсного голосового диалогового агента в рилтайме • Gemma 4 VLM на Cerebras — быстрый инференс • Parakeet (Nvidia) — распознавание речи • Qwen3TTS (Alibaba) — синтез голоса • задержка минимальна, отклик почти мгновенный Работает в роботах Reachy Mini (свыше 9000 устройств) Гитхаб Демо #realtime #dialog #voicemode #vlm #multimodal #interactive #tts #stt #duplex

audio.cpp: высокопроизводительный C++ движок для аудиоинференса

Н@GreenNeuralRobotsAI-инженер
3 мес
audio.cpp C++ движок для аудиоинференса на ggml. заявлен прирост 1.8–5x по сравнению с Python‑реализациями, плюс есть оптимизация под CUDA. - синтез речи. - распознавание речи. - VAD (Voice Activity Detection) - детекция голосовой активности. - конвертация голоса (изменение тембра, пола и т. д.). - генерация музыки/аудиофрагментов Windows / Linux / macOS #tts #stt #vad #t2m #text2music #voice2voice
Ещё ↓