🧩 От слов к виджетам
Сегодня UI обычно подстраивается под задачу: отдельный экран для покупки, карты, настройки или аналитика. Но с генеративными моделями появляется другой сценарий — интерфейс сам собирается под человека и конкретную задачу, в зависимости от рекомендаций и предпочтений пользователя.
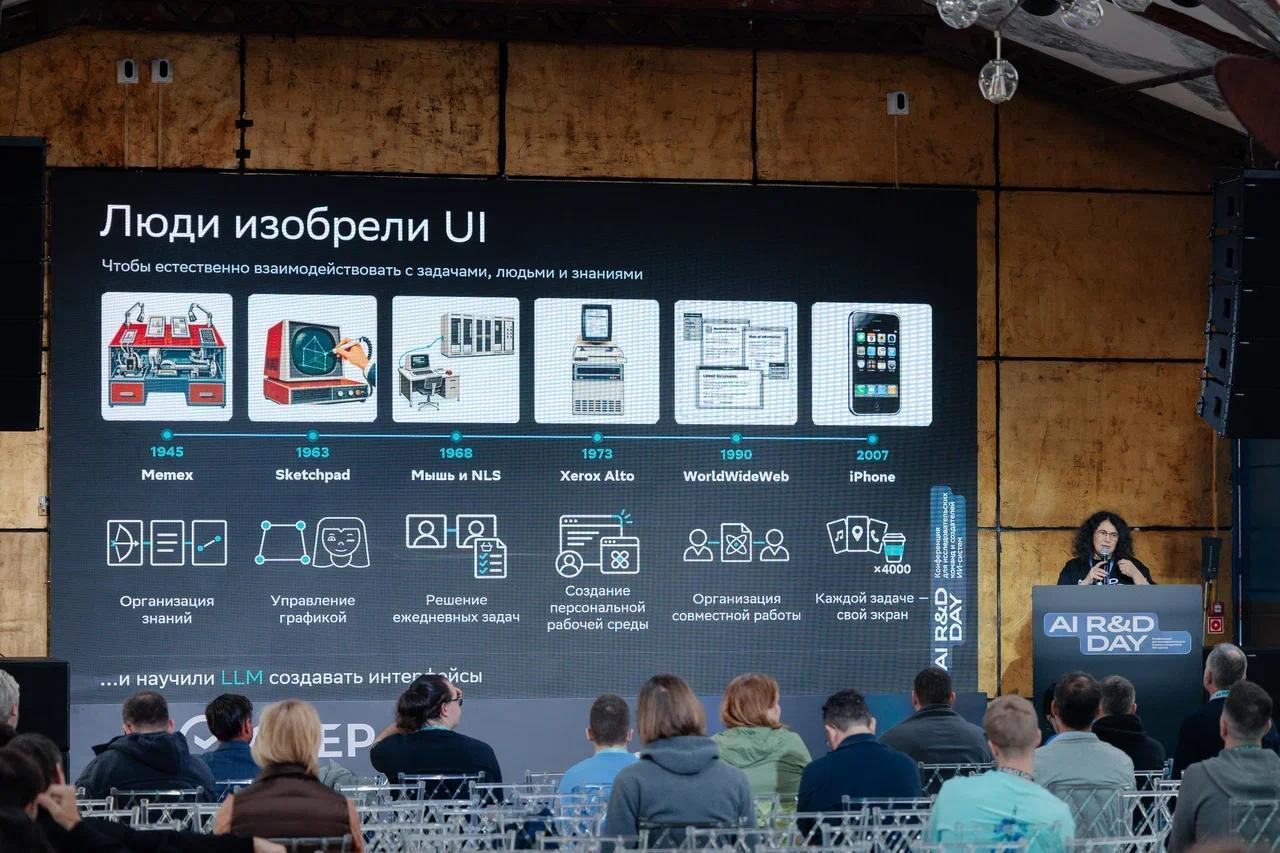
На AI RnD Day
Ира Пионтковская рассказала, как может выглядеть такой подход и какие технические проблемы возникают на практике.
📌 TLDR
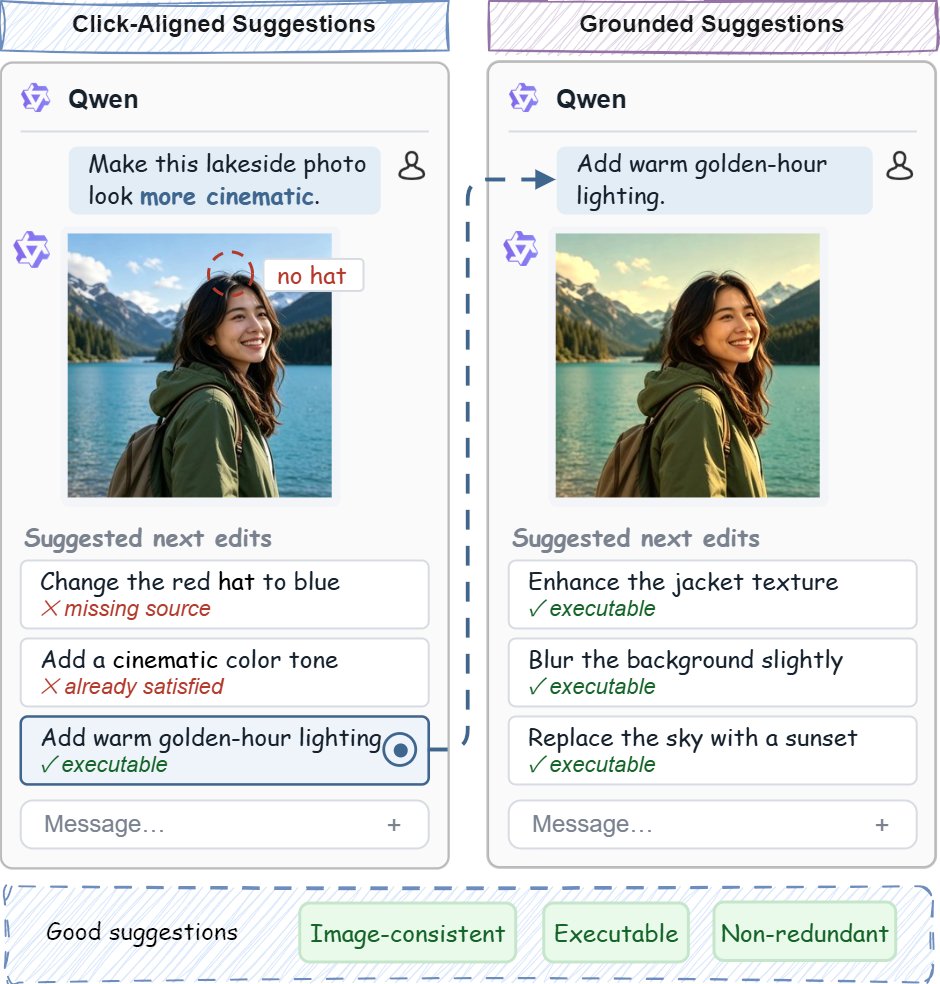
LLM пишет код, браузер превращает его в интерфейс. Но кто проверит, что кнопки работают, график не врёт, а виджет отвечает на исходный запрос? Generative UI — это не просто "LLM рисует HTML". Модель должна сгенерировать работающий интерфейс, пользователь — взаимодействовать с ним, а система — понять, действительно ли UI решает задачу с приемлемым качеством.
💥 Красиво ≠ правильно
У интерфейса как минимум три слоя проверки: внешний вид, поведение и смысл. Текст может читаться, кнопки — нажиматься, а задача всё равно останется нерешённой. Например, график расходов аккуратно сортирует дни недели по алфавиту. Визуально всё хорошо, а хронология потеряна.
🎙 Почему UI становится частью диалога
В классическом интерфейсе пользователь говорит: "покажи шкафы глубиной до 40 см", а приложение показывает экран с результатами. В GenUI модель может создать сам интерфейс под текущую задачу: показать варианты, дать выбрать один, открыть план комнаты и позволить перетащить шкаф.
Получается, что виджет становится частью реплики модели — примерно как жест или указание в разговоре. Это особенно интересно вместе с full-duplex voice: пользователь может сказать «этот сюда», модель — показать объект и место на экране, а пользователь — сразу изменить его положение.
🧠 Главная проблема — как проверить UI
Сгенерированный HTML может выглядеть красиво, но при этом содержать смысловую или функциональную ошибку. Поэтому мы исследуем VLM-as-a-judge, которая получает запрос, код и скриншоты двух виджетов и должна определить, какой лучше решает задачу. На примере бенчмарка дефектов: берём корректный график и намеренно добавляем один дефект — обрезанный текст, наложение элементов, пропавший объект, подпись не по теме или противоречие с данными.
Основной разброс появляется на задачах, где нужно обнаружить ошибку, а не просто прочитать изображение. Например, на обнаружении обрезанного текста Gemini 2.5 Pro дал 100% правильных ответов, GPT-5 — 92%, а Grok 4.20 — 31%.
🛠 Можно ли обучить самого судью?
Да. Мы собрали пары из хороших и намеренно испорченных виджетов: перекрытия, блюр, зависания, подмена темы и другие дефекты. Затем дообучили Qwen3.6-35B-A3B. На тесте после DPO точность на повреждённых виджетах выросла с 66% до 100%, а среднее время ответа сократилось примерно с 820 до 25 секунд.
🤖 Следующий уровень — GUI-агент
Визуальной проверки недостаточно. Интерфейс может выглядеть правильно, но кнопка не работать. Поэтому следующий шаг — дать GUI-агенту реальный сценарий: "Добавь дубовый шкаф в список покупок". Агент сам кликает по интерфейсу, выбирает нужный объект и проверяет состояние приложения. Если ожидаемый результат не достигнут, траекторию действий и ошибку можно вернуть генератору для исправления.
Так появляется полноценный цикл: LLM генерирует UI → GUI-агент взаимодействует → проверяется состояние → ошибка возвращается генератору.
🔚 Выводы
Generative UI — это следующий шаг после обычного chatbot-интерфейса: модель может не только отвечать, но и собирать форму взаимодействия под конкретную задачу. Но чтобы это работало в проде, одного сильного генератора недостаточно. Нужны проверяемые среды, модели-судьи и агенты, способные взаимодействовать с интерфейсом.
В конечном счёте хочется прийти к системе, где каждой задаче — свой интерфейс, а его качество проверяется автоматически.
А после доклада был задан очень хороший вопрос о недалеком будущем: "Будем ли мы жить в одном едином окне, в котором отражена вся наша жизнь?". Кажется, что все к этому идет!
🔗 Более подробно — в презентации Ирины (оставим в комментариях файлом) и в
записи выступления (тайминг: 5:04:40).
#genui #paperwatch #conference