Недавно для себя открыл, что приём из CUDA C Best Practices работает и на чипах Apple
Ядро GPU держит сразу несколько SIMD-групп, и когда одна группа ждёт данные из памяти, ядро выполняет инструкции другой. Можно подумать, что чем больше групп на ядре, тем лучше, однако все группы делят между собой регистры и shared memory ядра, поэтому если групп становится слишком много, регистры перестают помещаться на ядре, и данные уходят в кэш. Этот трафик мешает кернелу загружать собственные данные, из-за чего ядро замедляется. Собственно, [
приём] для CUDA заключается в том, что можно выделить кернелу shared memory больше, чем ему нужно - это приведет к уменьшению числа групп, и, как следствие, данные перестанут вытесняться.
До M3 на чипах Apple число групп ограничивали регистры, каждая группа сразу получала их под самый тяжёлый участок кернела. С M3 регистры выделяются по ходу работы, групп на ядро влезает больше, и чтобы их данные не вытесняли друг друга из кэша, Apple добавила блок, который называет occupancy manager (далее планировщик). На M3 и M4 он снижает число групп, когда из L1, общего для регистров, shared memory и кэша буферов, начинают вытесняться данные.
Но этот планировщик работает криво, потому что не снижает число групп, когда через L1 идут данные регистров. На умножении матрицы сразу на несколько токенов он держит 26-27 SIMD-групп на ядро, хотя быстрее всего кернел работает при 8-14. Такое умножение нужно для MTP, где модель набрасывает несколько следующих токенов и проверяет их за один проход.
Metal не даёт задать число групп вручную, но приём для CUDA можно заставить работать и здесь. Shared memory в Metal (threadgroup memory) выделяется сразу на одну или несколько SIMD-групп, и новые группы ядро не запускает, пока для их памяти нет места, поэтому лишняя память уменьшает число групп. Чтобы компилятор её не выкинул, в кернел добавляется запись в эту память, которая никогда не выполняется.
Лучшее число групп у разных матриц разное, в той же Qwen3.8 на 4 токенах умножение 5120×17408 быстрее всего при 10 группах, 17408×5120 при 24, а от типа квантования лучшее число меняется от 6 до 24. Я пытался вывести формулу по числу регистров, байтам на вес, объёму вычислений на байт и прочим переменным, но не вышло. По лучшей составной формуле кернел в среднем на 5-7% медленнее, чем с оптимумом, найденным перебором. К тому же на той же матрице при 16 группах трафика регистров уже нет, а умножение всё равно по скорости такое же, как и без ограничения (413 мкс против 418), и лучшее время в 349 мкс получается только при 10 группах. Что тормозит кернел между 16 и 10 группами, я так и не понял. Возможно, размер регистрового файла и другие константы чипа помогли бы разобраться, но Apple их не публикует. Поэтому для тестов в llama.cpp число групп подбирает тюнер, который в первые проходы генерации пробует для каждой матрицы вариант без лишней shared memory и несколько её объёмов от 2 до 32 КБ и оставляет самый быстрый, на это уходит около 2 секунд работы GPU.
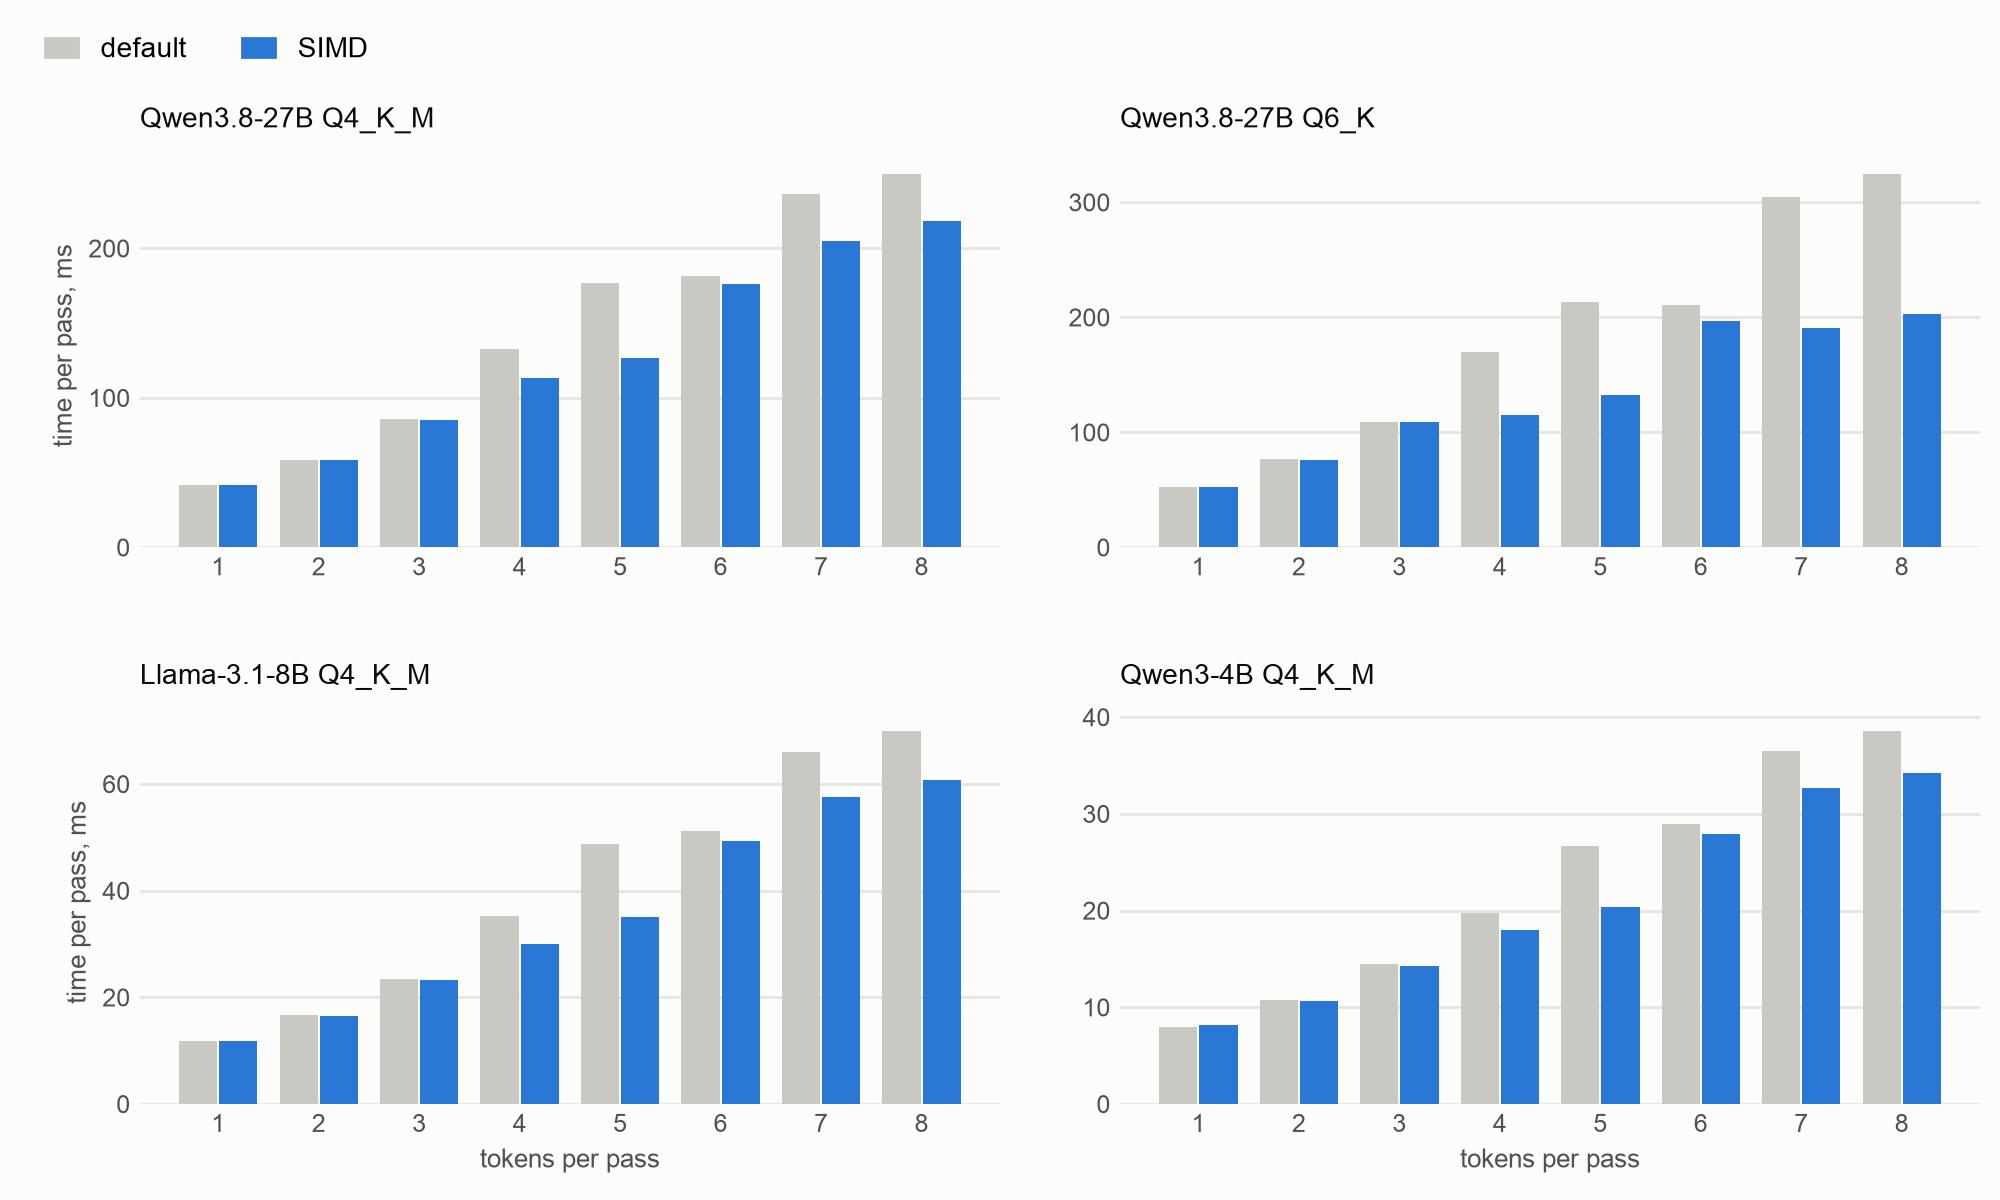
На первой картинке время прохода четырёх моделей в llama.cpp без тюнера и с ним. У Qwen3.8-27B в Q4_K_M проход на 4 токена сокращается со 133 до 113 мс, на 5 со 177 до 127 мс, а у той же модели в Q6_K выигрыш доходит до 38% (на 1-3 токенах llama.cpp работает другим кернелом, которому ограничение не помогает, а на 6 выигрыш почти пропадает, там кернел считает токены двумя частями по 3).
На второй картинке то же умножение матрицы 5120×17408 в MLX. В f32 ограничение числа групп ускоряет его на 4 токенах с 374 до 288 мкс, правда в bf16, в котором MLX считает модели, выигрыш сильно меньше. Видимо, в bf16 кернелу нужно меньше регистров