Запуск больших ИИ-моделей с использованием ОЗУ вместо VRAM
I@itcnewsruавтор про «tech»
1 месТестирование запуска MoE-моделей на видеокартах с малым объемом памяти за счет использования системной ОЗУ.
Этот метод позволяет запускать мощные нейросети на обычном домашнем компьютере без покупки дорогостоящих видеокарт.
- Снижает порог входа для работы с большими языковыми моделями.
- Позволяет использовать старые или бюджетные видеокарты для задач ИИ.
- Показывает эффективность архитектуры MoE при ограниченных аппаратных ресурсах.
ОЗУ позволяет запускать огромные ИИ-модели на видеокартах с небольшим объёмом VRAM
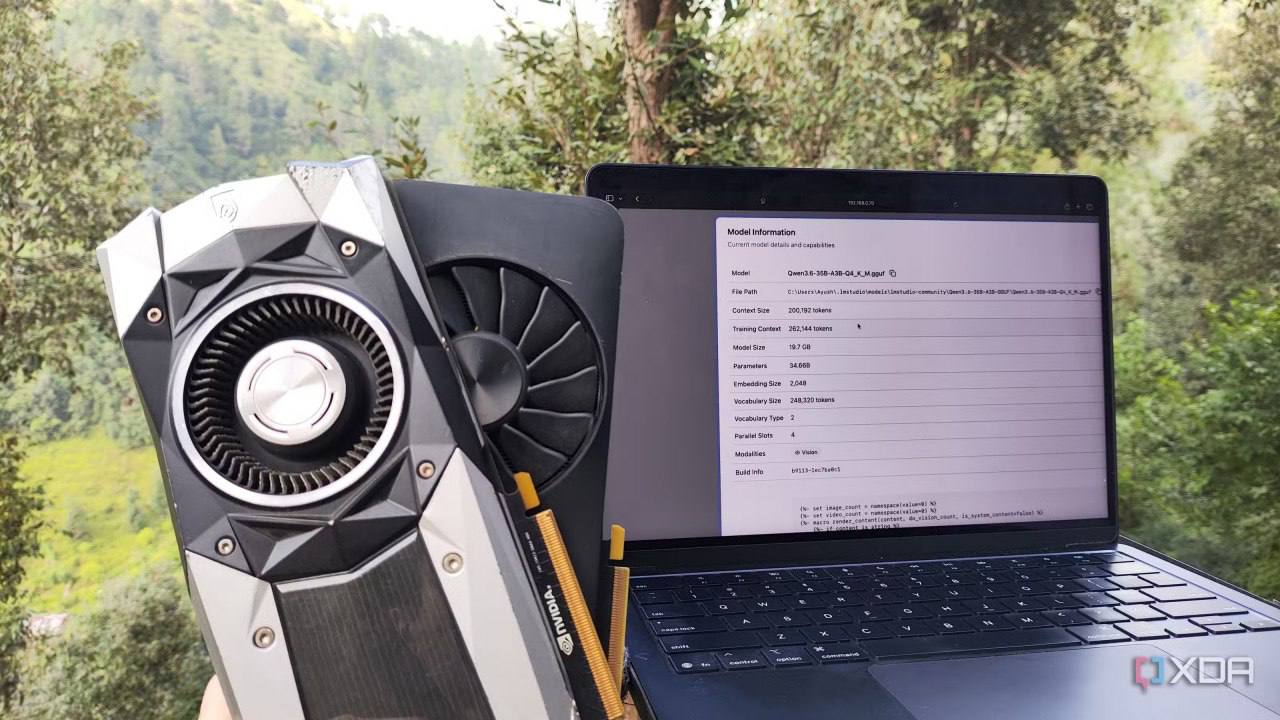
XDA протестировала локальные модели с архитектурой Mixture-of-Experts (MoE). Она активирует только нужных экспертов во время работы, поэтому часть данных можно вынести из видеопамяти в обычную ОЗУ.
Например, на RTX 3080 Ti с 12 ГБ VRAM удалось запустить Qwen3.6-35B-A3B в формате Q4_K_M через llama.cpp. Модель содержит 35 млрд параметров, но работала со скоростью около 25 токенов/с.
Ещё интереснее результат с GeForce GTX 1080 на 8 ГБ: на ней запустили Gemma-4-26B-A4B Q4_K_M со скоростью 14 токенов/с. Главное условие такого подхода - суммарного объёма VRAM и ОЗУ должно хватать для всей модели.
Кратко (AI)
Издание XDA протестировало возможность запуска крупных ИИ-моделей с архитектурой Mixture-of-Experts на видеокартах с ограниченным объемом видеопамяти. Благодаря выгрузке части данных в системную ОЗУ через llama.cpp, удалось запустить модели Qwen3.6-35B-A3B и Gemma-4-26B-A4B на картах с 8-12 ГБ VRAM с приемлемой скоростью генерации.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖