generaciiaСбросить фильтр ×

Релиз серии LoRA для реализма Famegrid 2nd Gen

Н@GreenNeuralRobotsAI-инженер
2 мес
Famegrid 2nd Gen (Krea 2 / Z-Image / Qwen) Серия LoRA на реализм с закосом под смартфон - Работает в связке с Turbo Distill LoRA — 6 шагов первый проход, 2 шага второй - Вес LoRA: 0.7–0.9 (0.7 более естественно, 0.9 сильнее стиль, но чисто) - С character LoRA вес не выше 0.6 - Триггер-слово: rls #lora #realism #krea2 #zimage #qwenimage VK | MAX
Релиз серии LoRA для реализма Famegrid 2nd Gen

Выпуск LoRA для Krea 2 Turbo

Н@GreenNeuralRobotsAI-инженер
2 мес
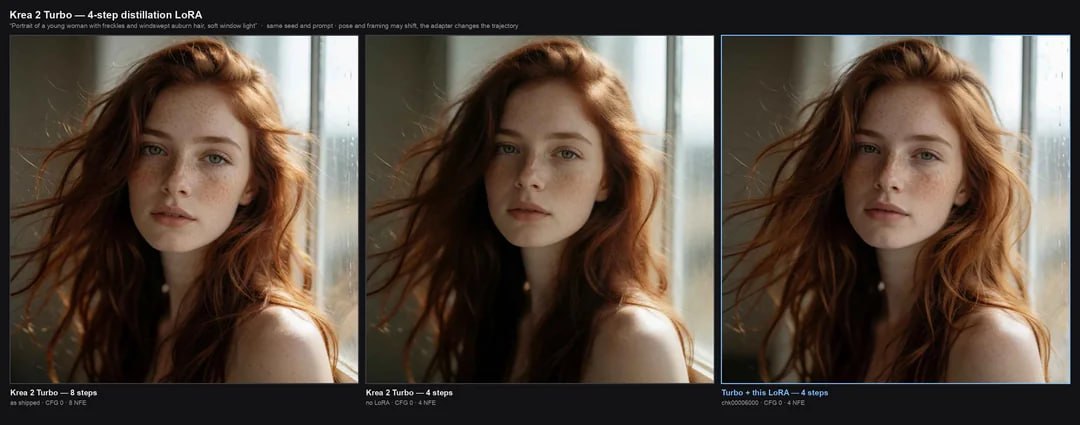
Krea 2 Turbo Distill — 4-Step LoRA LoRA для Krea 2 Turbo, снижает минимальное количество шагов генерации с 8 до 4. В процессе разработки. Актуальный чекпойнт krea2_turbo_4step_rank_64_lora_latest.safetensors Есть версия для ComfyUI #krea2 #lora VK | MAX
Выпуск LoRA для Krea 2 Turbo

Вышел Hi3D V3.0: генератор 3D-моделей из изображений

Н@GreenNeuralRobotsAI-инженер
2 мес
Hi3D V3.0 Обновился коммерческий генератор 3D-моделей из одной картинки, когдато бывший опенсорсным. Главный фокус - точность геометрии, структуры и текстур. Мелкие детали больше не теряются - воксельное разрешение 2048³ - сохраняются морщины, гравировка, тонкие части - Лучше структура сложных форм и скрытых зон, которые раньше додумывались криво - Текстуры до 8K с улучшенной UV-разверткой - Два режима: Quality - детальные одиночные объекты, Master - сложные композиции, многосоставные скульптуры, миниатюрные сцены Сравнение с Meshy 7 #imageto3d VK | MAX

Как отличать сгенерированные изображения от реальных

️@neyroseti_drAI-инженер
2 мес
Привет, друзья! А все ли из вас умеют отличать сгенерированные изображения от реальных? Сегодня я опубликовал на VC статью, после прочтения которой вы будете более уверенно их определять. #полезное
Как отличать сгенерированные изображения от реальных

MaskVidExperiments: набор инструментов для работы с масками в ComfyUI

Н@GreenNeuralRobotsAI-инженер
2 мес

Критика ИИ-контента на стриминге Roku

v@vcnewsмедиа / агрегатор
2 мес
«После многочасового надругательства над мозгом и глазами мне остаётся надеяться только на то, что ИИ-студии наймут людей, у которых есть вкус». В августе на стриминге Roku запустили круглосуточный канал со сгенерированными фильмами и сериалами. The Verge тогда сравнило ощущения от просмотра с «кормёжкой из корыта», но некоторые журналисты осмелились сформировать своё мнение. Один словно побывал в бреду, а другой усомнился в собственном здравомыслии (как и автор заметки) vc.ru/opinions/3092257

Музыкальное видео-эксперимент: брейк-данс в средневековом сеттинге

М@cgeventAI-инженер
2 мес

Muse V2: чат-панель с LLM для ComfyUI

Н@GreenNeuralRobotsAI-инженер
2 мес
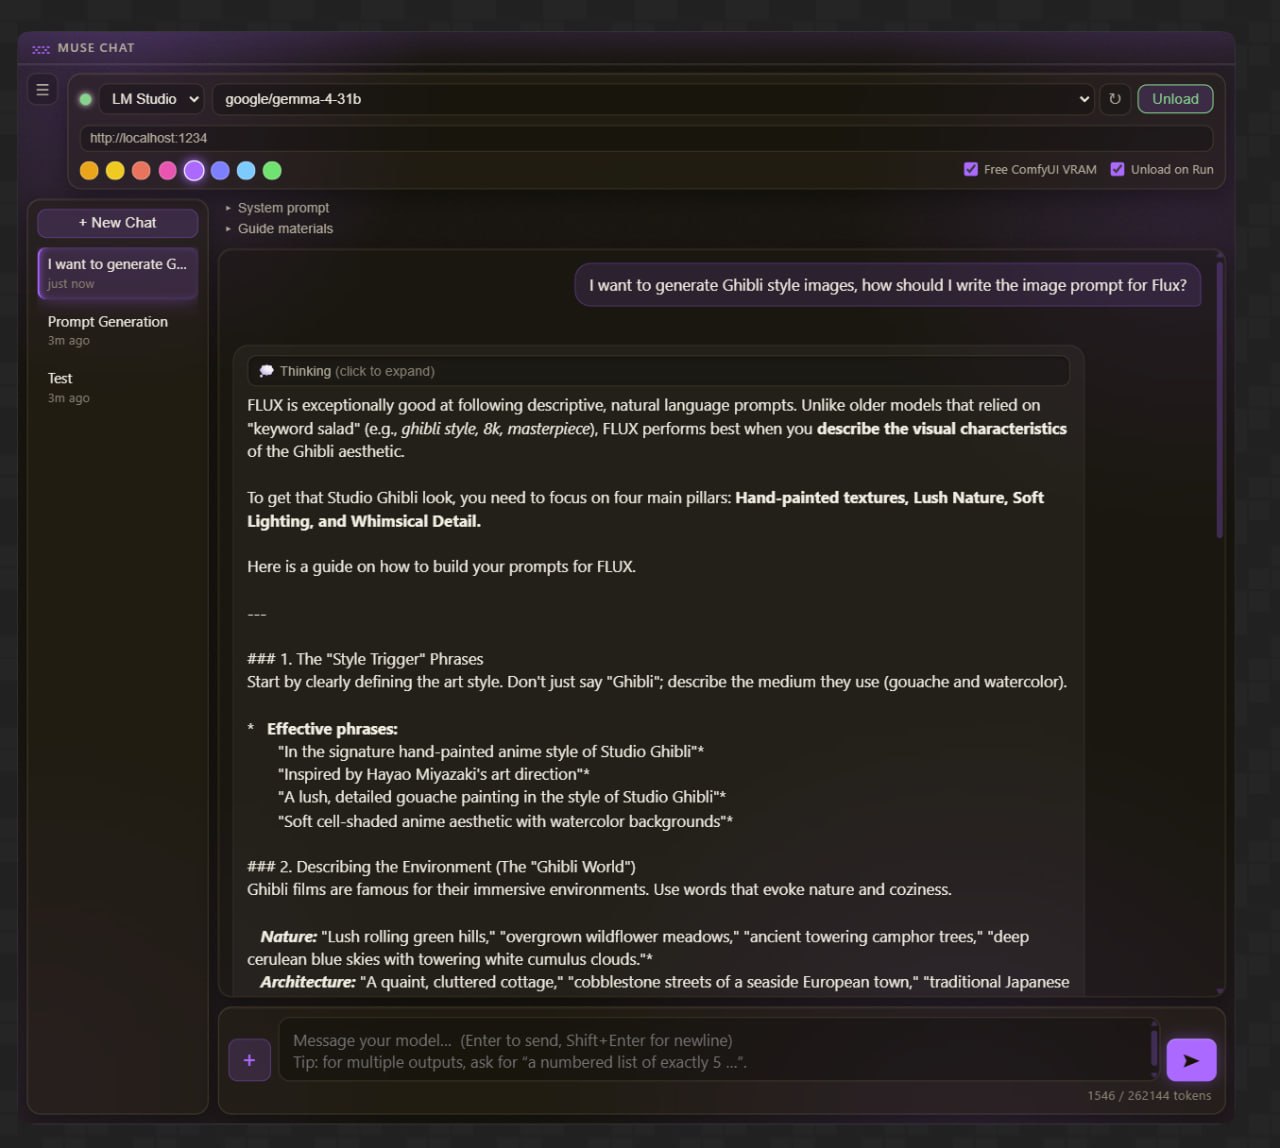
Muse V2: чат-панель с LLM для ComfyUI

Выпуск LoRA-моделей LTX 2.5 для улучшения видео и изображений

Н@GreenNeuralRobotsAI-инженер
2 мес
LTX 2.5 - CQ Video and Image Enhancer LoRAs Две лоры #LTX25 улучшайзеры-апскейлеры картинок и видео спасибо @m_franz #lora #upsacale #enhance #imagerestoratoipn #videorestoration VK | MAX

Тестирование модели MAI 2.6

э@ai_newzAI-инженер
2 мес
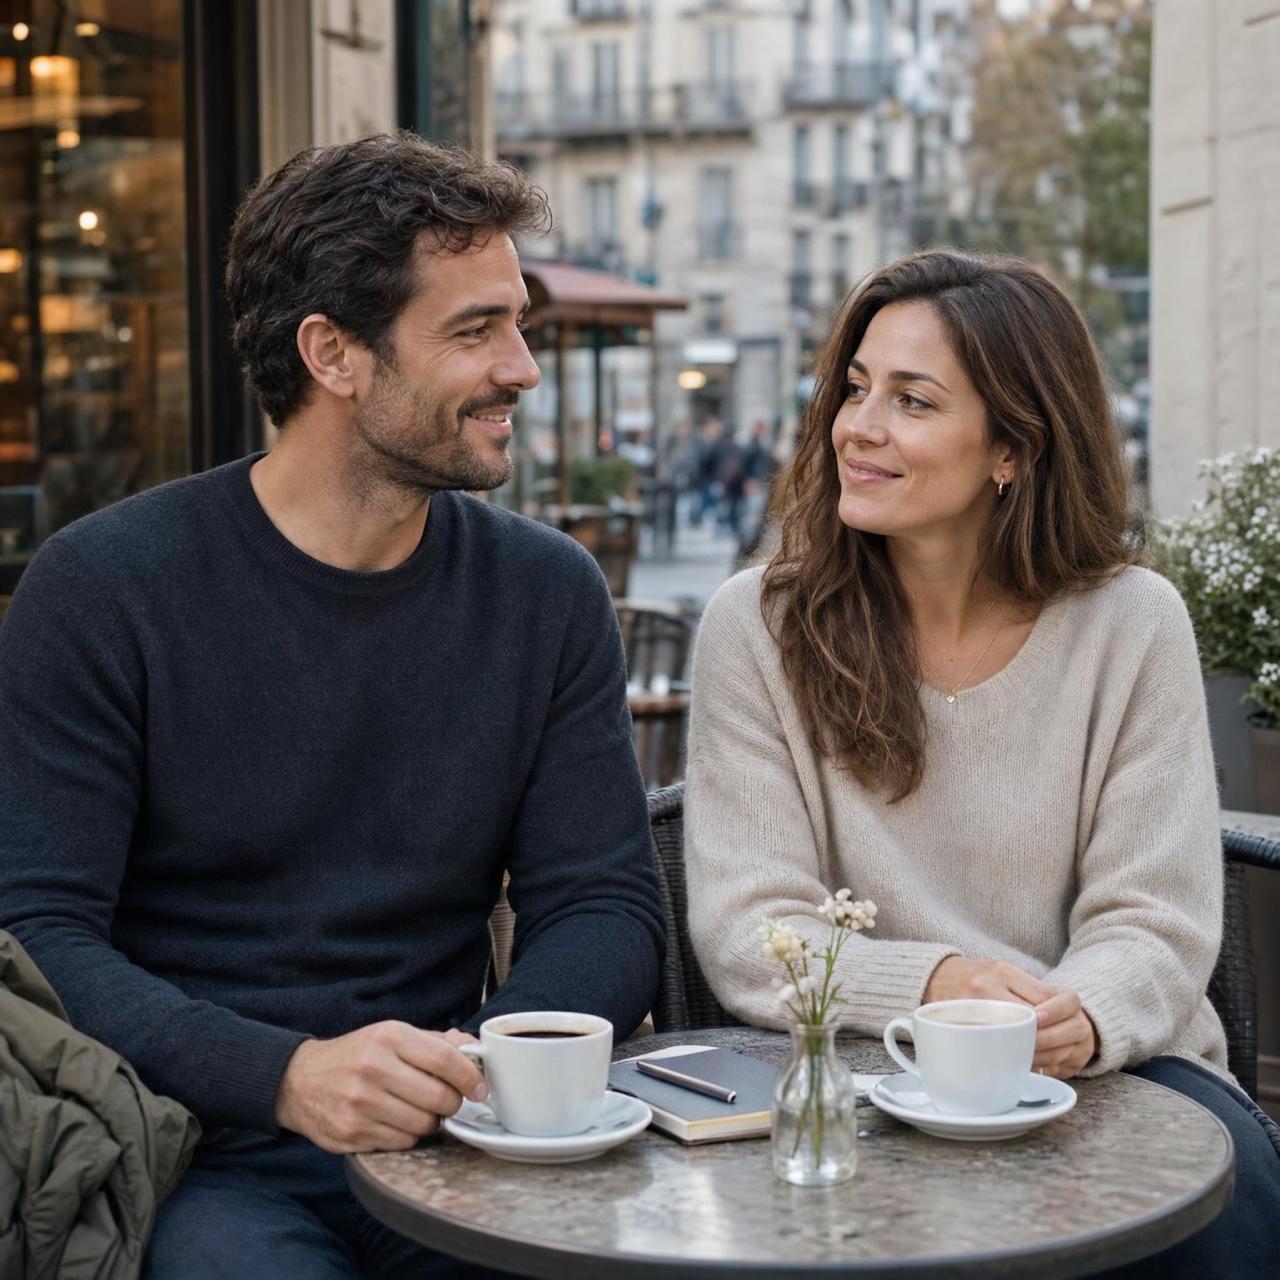
MAI 2.5-pro потестить нигде не дают - поэтому я потестил 2.6 Разнообразие генерации просто на нуле. Четыре раза сгенерил с промптом "a man and a woman", и модель выдала 4 почти идентичных картинки, как будто модель жутко дистиллирована. Даже лица у людей не меняются. И на 2/4 у женщины неопрядок с пальцами. Вот вам и арена. Думайте. @ai_newz
Тестирование модели MAI 2.6

Disney Research представили модель для генерации точной анимации барабанщика по аудио

М@cgeventAI-инженер
2 мес

ComfyOrg выпустили MCP-сервер для локального ComfyUI

Н@GreenNeuralRobotsAI-инженер
2 мес

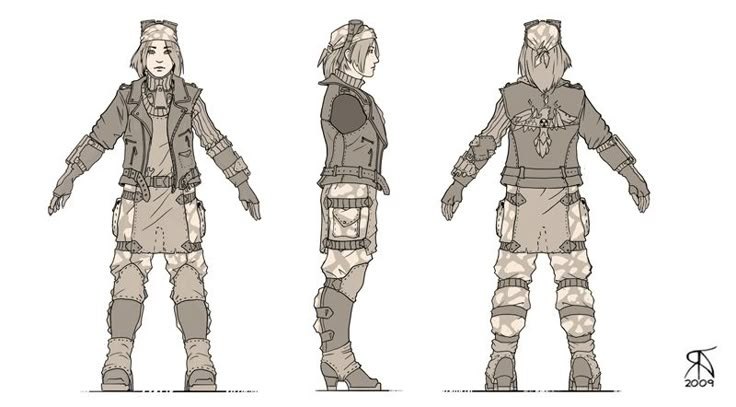
Проблема качества AI-генераций для Character Turnaround Sheets

G@GameDEVгеймдев
2 мес
Just needed to find a real example for Character Turnaround Sheets and holy crap — this medium is poisoned by: - AI with inconsistent elements between views making it impossible to model a final combined output - Cheap odd DnD characters, Roblox Characters, VR Chat avatars, and such. Basically useful only and only for this specific user and not as a general reference
Проблема качества AI-генераций для Character Turnaround Sheets

VibeWorlding: фреймворк для генерации 3D-миров агентами

Н@GreenNeuralRobotsAI-инженер
2 мес
VibeWorlding Фреймворк от HKUST и Tencent для агентов, которые строят интерактивные 3D-миры по текстовому запросу. Единый стек: бенчмарк, песочница для RL и модели. Агент сам понимает интент, планирует сцену, вызывает 3D-инструменты и рефлексирует по фидбеку. • Сборка 3D-мира от запроса до готовой сцены без ручной работы • многошаговое взаимодействие с окружением - планирование, вызов инструментов, рефлексия • Поиск и редактирование ассетов, рендер сцены через MCP-инструменты • Флагман VibeWorlder-30B-A3B, есть версии 8B и embedding 4B Гитхаб HF #textto3d #3d #agent VK | MAX

ComfyUI Image Conveyor: управление референсами для генерации

Н@GreenNeuralRobotsAI-инженер
2 мес

OrbitSheets: инструмент для создания референс-листов на базе MiniMax H3

Н@GreenNeuralRobotsAI-инженер
2 мес

Alaya Lab представила Evoke: модель для генерации бесконечных видео-миров

Н@GreenNeuralRobotsAI-инженер
2 мес

Google Sheets научились превращать таблицы в мини-приложения по текстовому промпту

Google добавила в Google Sheets новую функцию Canvasi: пользователь пишет текстовый промпт (например, «сделай визуальный трекер учёбы»), и Geminii собирает поверх обычных строк и столбцов интерактивное мини-приложение — с дашбордами, drag-and-drop и наглядным интерфейсом.

Главная особенность — двусторонняя синхронизация: правки в canvas-макете сразу обновляют данные в таблице, и наоборот. Это избавляет пользователей от необходимости разбираться в сырых строках/столбцах и превращает Google Sheets в конструктор приложений без кода.

Полный разбор →

Создание короткометражного фильма MOTHER с использованием ИИ

М@cgeventAI-инженер
2 мес

ComfyUI-H3-FaceRefine для улучшения лиц в видео

М@cgeventAI-инженер
2 мес
Для Минимаксеров: ComfyUI Minimax-H3 FaceRefine Улучшатор маленьких лиц, которые обычно портятся. - tracks, crops, regenerates faces at native resolution to fix distance-blurring - YOLOv8 + InsightFace for identity-locked tracking - img2img latent injection + temporal denoise scaling - влезает в 12GB VRAM via GGUF. https://github.com/Carasibana/ComfyUI-H3-FaceRefine @cgevent

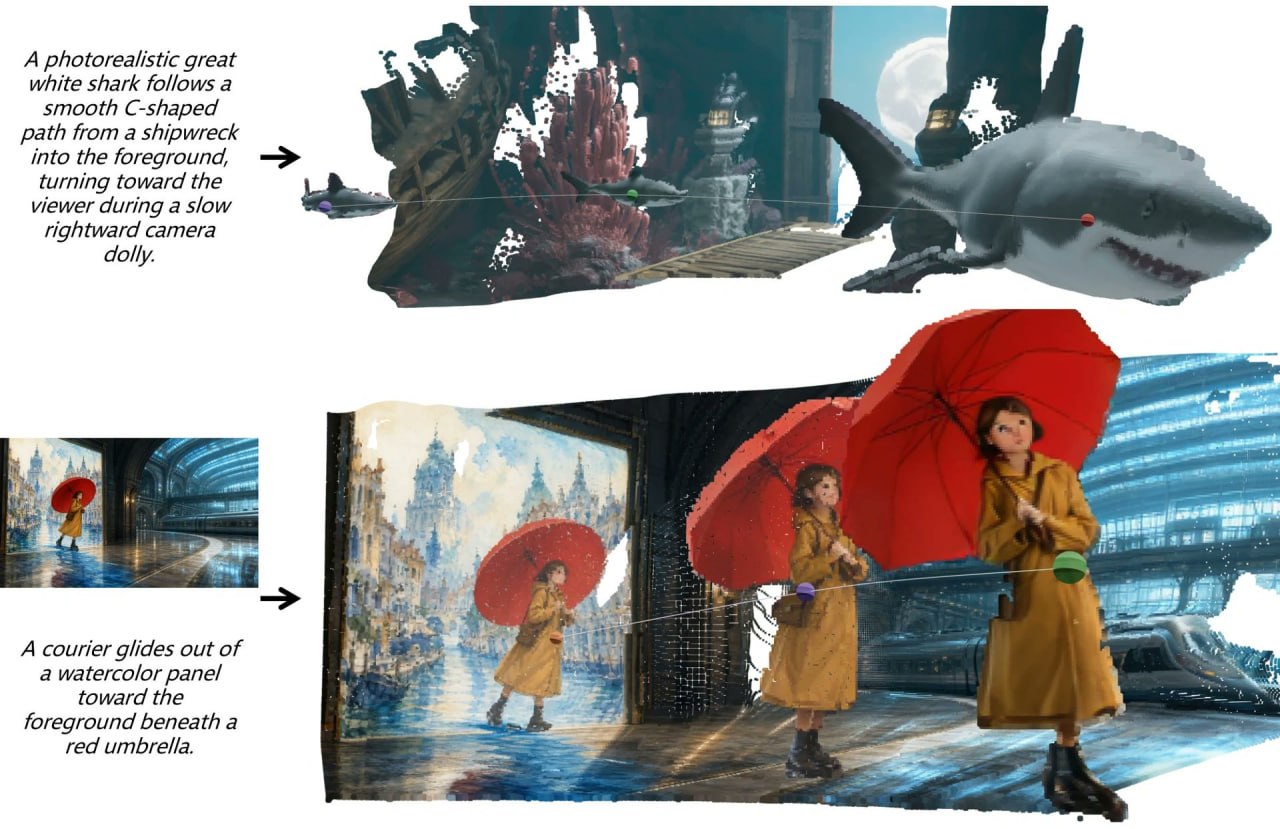
Latent-to-4D: генерация 4D-сцен напрямую из латентного пространства

Н@GreenNeuralRobotsAI-инженер
2 мес
Latent-to-4D: генерация 4D-сцен напрямую из латентного пространства

Sonauto переименовался в Treblo и предлагает бесплатную безлимитную генерацию музыки на фоне ограничений Suno

Сервис генерации музыки Sonauto 3 июня официально сменил название на Treblo. На фоне того, что Suno вводит ограничение на скачивание треков (не более 7 за всю жизнь аккаунта), Treblo выглядит подозрительно щедрым конкурентом: последняя модель Melodia v3i доступна обычным пользователям бесплатно и без лимитов — без кредитов, дневных квот и урезанной старой версии, причём ограничений на использование сгенерированных треков нет даже на бесплатном тарифе.

Treblo позиционируется как альтернатива для тех, кто хочет «валить» из Suno: генерация идёт по текстовому промпту и более чем 4160 стилевым тегам, поддерживаются свои или авто-сгенерированные лирика, микс языков в одном треке, инструменталы, а также редактирование — inpaint секций, замена текста, extension, remix и stem separationi.

7лимит скачиваний в Suno на весь аккаунт
4160+стилевых тегов в Treblo
<1 на 10 000заявленный false-positive Treblo Classifier

Полный разбор →

Tencent представила WorldClaw — систему генерации редактируемых 3D-миров по текстовому промпту

Команда Hunyuan3D из Tencent опубликовала технический отчёт о WorldClaw — фреймворке, который по одной текстовой фразе строит полноценную трёхмерную сцену открытого мира: рельеф, поверхности, постройки, растительность и транспорт. На выходе получаются полигональные текстурированные модели, совместимые с Blender и доступные для ручного редактирования — то есть не видео и не сплаты, а настоящая 3D-геометрия.

У WorldClaw нет собственной единой модели — это агентный конвейерi, связывающий несколько уже существующих систем: Claude Opus 4.8 разбирает запрос и планирует сцену, GPT-Image-2 рисует карты и композиции, семейство SAM3 сегментирует объекты, Hunyuan3D доводит геометрию и текстуры, а сборка происходит в Blender.

Полный разбор →

Tencent представила Hunyuan3D-Buffalo 1.0 — 3D-модель с «пониманием» структуры объектов

Tencent показала Hunyuan3D-Buffalo 1.0 — экспериментальное развитие своей линейки Hunyuan3D. В отличие от обычной генерации 3D по картинке или тексту, Buffalo умеет понимать структуру объекта: отвечать на вопросы о нём, находить отдельные детали по текстовому описанию, удалять или заменять их, а также генерировать геометрию прямо из текста — всё в одном пайплайне, без отдельных моделей под каждую задачу.

Главный акцент разработки не на красоте image-to-3Di генерации, а на осмысленном редактировании и работе с частями модели — то есть система сначала «понимает», где у объекта крылья, колёса или другие детали, а затем может что-то с ними сделать по команде.

ВыводВ основе системы лежит генератор Hunyuan3D-2.1, к которому добавили 3D-VLM (визуально-языковую модель), работающую как «мозг» системы

1.0версия релиза Hunyuan3D-Buffalo
2.1версия базового генератора Hunyuan3D

Полный разбор →

Ещё ↓