videoСбросить фильтр ×

Alaya Lab представила Evoke: модель для генерации бесконечных видео-миров

Н@GreenNeuralRobotsAI-инженер
2 мес
ComfyUI-H3-FaceRefine для улучшения лиц в видео

М@cgeventAI-инженер
2 мес
Для Минимаксеров: ComfyUI Minimax-H3 FaceRefine Улучшатор маленьких лиц, которые обычно портятся. - tracks, crops, regenerates faces at native resolution to fix distance-blurring - YOLOv8 + InsightFace for identity-locked tracking - img2img latent injection + temporal denoise scaling - влезает в 12GB VRAM via GGUF. https://github.com/Carasibana/ComfyUI-H3-FaceRefine @cgevent

Автоматизация создания видео-туториалов: локальный стек и лицензионные нюансы

A@qachanellавтор про «it»
2 мес

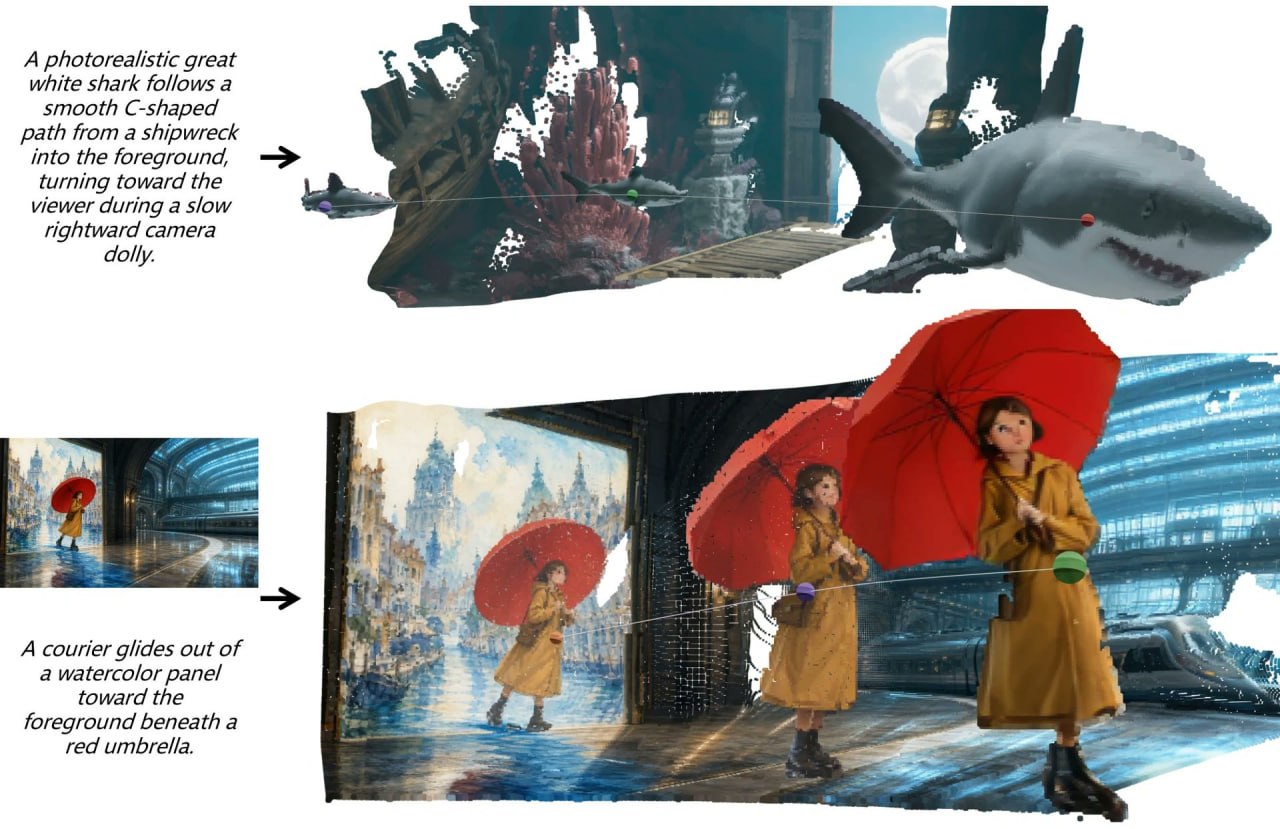
Latent-to-4D: генерация 4D-сцен напрямую из латентного пространства

Н@GreenNeuralRobotsAI-инженер
2 мес
Latent-to-4D: генерация 4D-сцен напрямую из латентного пространства

Почему фаундерам не стоит читать с телепромптера

С@nikitonsky_pubмедиа / агрегатор
2 мес

VK внедрил «нейропрофиль» пользователей на основе трансформера для рекомендаций

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

VK запустила новую ИИ-модель — трансформерный «нейропрофильi», который объединяет поведенческие сигналы пользователя из разных сервисов экосистемы (VK Видео, VK Клипы, ВКонтакте) в единую анонимизированную цепочку событий. Это позволяет точнее ранжировать рекомендации контента, решая задачу представления десятков разрозненных действий пользователя единым понятным профилем.

По данным компании, внедрение уже дало измеримый эффект: выросло время просмотра клипов, пользователи чаще делятся контентом и чаще смотрят его в полноэкранном режиме. Параллельно VK выпустила для авторов контента инструмент автоматической разметки длинных видео на смысловые главы.
5,5%рост времени просмотра клипов
15%рост частоты шеринга контента
до 1,2 млрд рублейоценка инвестиций в проект

Полный разбор →

JoyAI-Video-Edit: 16B-модель для редактирования видео в реальном времени

N@neurohiveAI-инженер
2 мес

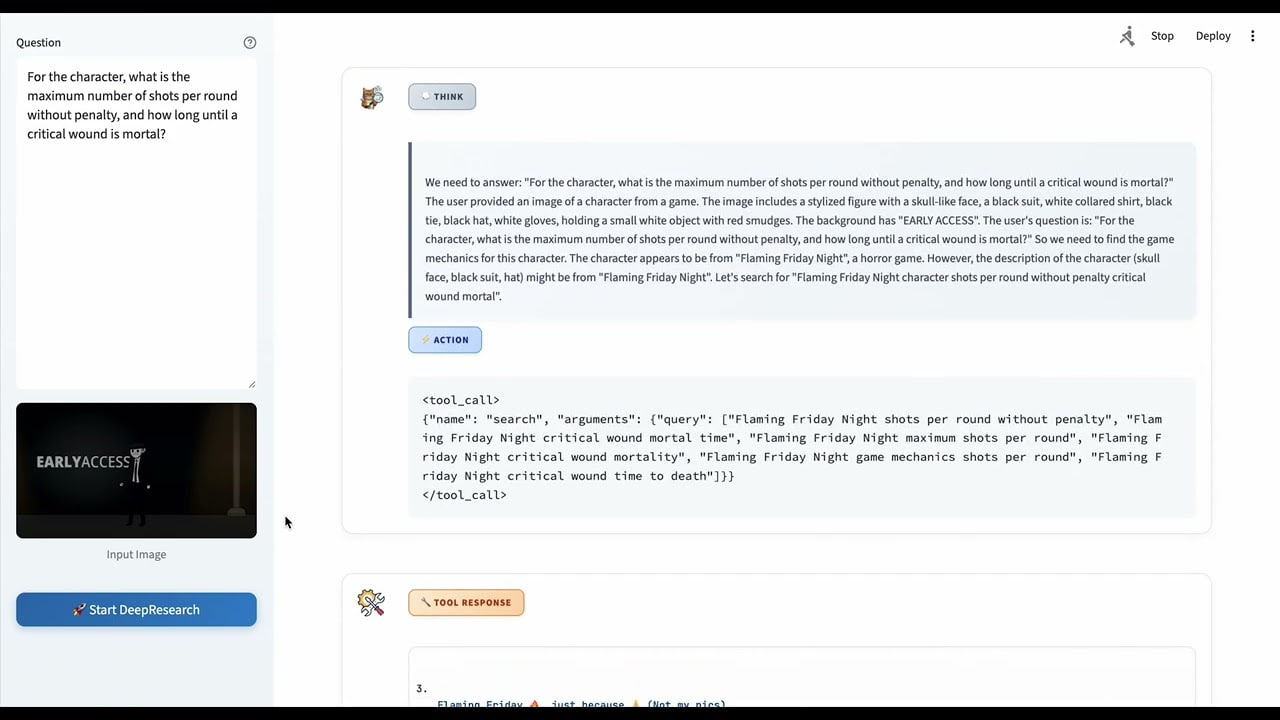
Video-DeepResearch: новый подход к мультимодальным агентам

Н@GreenNeuralRobotsAI-инженер
2 мес
Video-DeepResearch: новый подход к мультимодальным агентам

Alibaba выпустила Wan Animate 2 — аниматор персонажей без скелетов и с текстовым управлением камерой

Alibaba представила Wan Animate 2 — новую версию модели для переноса движения на персонажей (motion transfer). Главное отличие от предыдущего подхода: модель теперь напрямую анализирует driving videoi (видео с образцом движения) без построения скелетов и промежуточных костылей, что снижает дрейф идентичности персонажа при сложных движениях. Модель передаёт мимику, движения рук и умеет работать с несколькими персонажами одновременно.

Ключевая новая фича — управление ракурсом камеры текстом, независимо от исходного видео: раньше камера была жёстко привязана к driver-видео, теперь её можно отвязать и задавать словами, не ломая при этом движение персонажа. По смыслу Wan Animate 2 сравнивают с конкурентом SCAIL-2: SCAIL-2 пока обкатаннее в задачах replacement и сложных multi-character сценах, а Wan Animate 2 выигрывает именно как связка motion transfer + camera control.
24 fpsзаявленная скорость streaming Lite-версии
10-stepшагов у дистиллированной версии модели
14Bразмер модели (Wan2.2-Animate-2-14B)

Полный разбор →

Третий эпизод «Эпохи GTA»: история создания GTA III

I@igmtvгеймдев
2 мес
🎥Сегодня у нас третий эпизод «Эпохи GTA» и посвящён он культовой третьей части! Мы наконец перебрались в прайм-эру «великого автогонщика», которая развернулась в полноценном 3D в начале 2000-х. Вспомним о том, как Rockstar создали легендарную игру, на основе которой позже подарила нам ещё более великих колоссов. Приятного просмотра. 😏Подписаться на IGM
Третий эпизод «Эпохи GTA»: история создания GTA III

Нейрорендер 2D: After Effects вместо Blender для управления AI-видео

Автор канала @cgevent (кросс-пост в «Метаверсище и ИИще» и «Нейросети и Блендер») описывает наблюдение: если модель, которую он называет «Сиданский», чаще всего связывают с Blenderi, то для модели «Минимаксенкоi» больше примеров использования именно с After Effectsi.

Идея в том, что After Effects можно использовать как инструмент управления AI-видеогенерацией — светом, анимацией и формой объектов, — получая своего рода «нейрорендер 2D» без необходимости осваивать 3D-пакет вроде Blender.

Полный разбор →

JoyAI-Video-Edit: авторегрессивная модель для потокового редактирования видео

Н@GreenNeuralRobotsAI-инженер
2 мес
JoyAI-Video-Edit Авторегрессивная диффузионная модель для потокового редактирования видео • стиль видео по промпту • добавление/удаление объектов • замена фона на лету • локальные правки без пересчёта всего ролика • 720p в реальном времени • ~30 FPS на одном GPU • 16B параметров Гитхаб HF Демо - там только для своих, нужен инвайт #streaming #videoediting #v2v #realtime

Lift4D: открытый код для 4D-реконструкции движущихся объектов из одного видео

Исследователи выпустили фреймворк Lift4Di, который восстанавливает полную 4D-модель динамичного объекта — геометрию, текстуры и нежёсткие деформации во времени — используя только обычное монокулярное видео с одной камеры. Система достраивает даже ракурсы, которые не были видны в исходной съёмке, реконструируя полный 360° обзор объекта.

Код и статья опубликованы в открытом доступе, есть интерактивная демо-страница проекта, где можно самостоятельно покрутить полученную 3D/4D-модель. Работа тестировалась на GPU NVIDIA A100i.

ВыводLift4D реконструирует не только геометрию и текстуры, но и нежёсткие деформации движущихся объектов — то есть отслеживает, как форма объекта меняется во времени

360°полный обзор восстановленной геометрии объекта

Полный разбор →

Black Forest Labs выпустила FLUX 3 Video в API и плейграунде

Black Forest Labs (BFLi) официально открыла доступ к FLUX 3 Video — модели генерации видео длительностью до 20 секунд со звуком, липсинком, несколькими сценами и заявленной поддержкой русского языка. Доступ дан через API и веб-плейграунд (платно), сама модель для текста и изображений (FLUX 3 Image) пока не выпущена.

Модель умеет продолжать готовое видео (до 4 секунд исходника со звуком), работать по ключевым кадрам, начальному и конечному кадру, а также содержит Draft Modei — дешёвый черновик, который при желании можно пересчитать в полном качестве с тем же движением, композицией и seed. Первые тесты показывают, что длинные планы держатся без рассыпания, а персонажи иногда «помнят» события пятисекундной давности.
20 секундмаксимальная длительность видео
$0,17цена за секунду генерации в 720p
1080pмаксимальное разрешение через апскейлинг

Полный разбор →

ComfyUI Video Tiler: оптимизация памяти при обработке видео

Н@GreenNeuralRobotsAI-инженер
2 мес
ComfyUI Video Tiler Тайлер для видео и изображений в #ComfyUI, снижает потребление памяти при обработке за счёт разбиения на тайлы (плитки) протестирован в апскейле LTX 2.3 и MiniMax H3 Спасибо @m_franz #upscale #lowvram

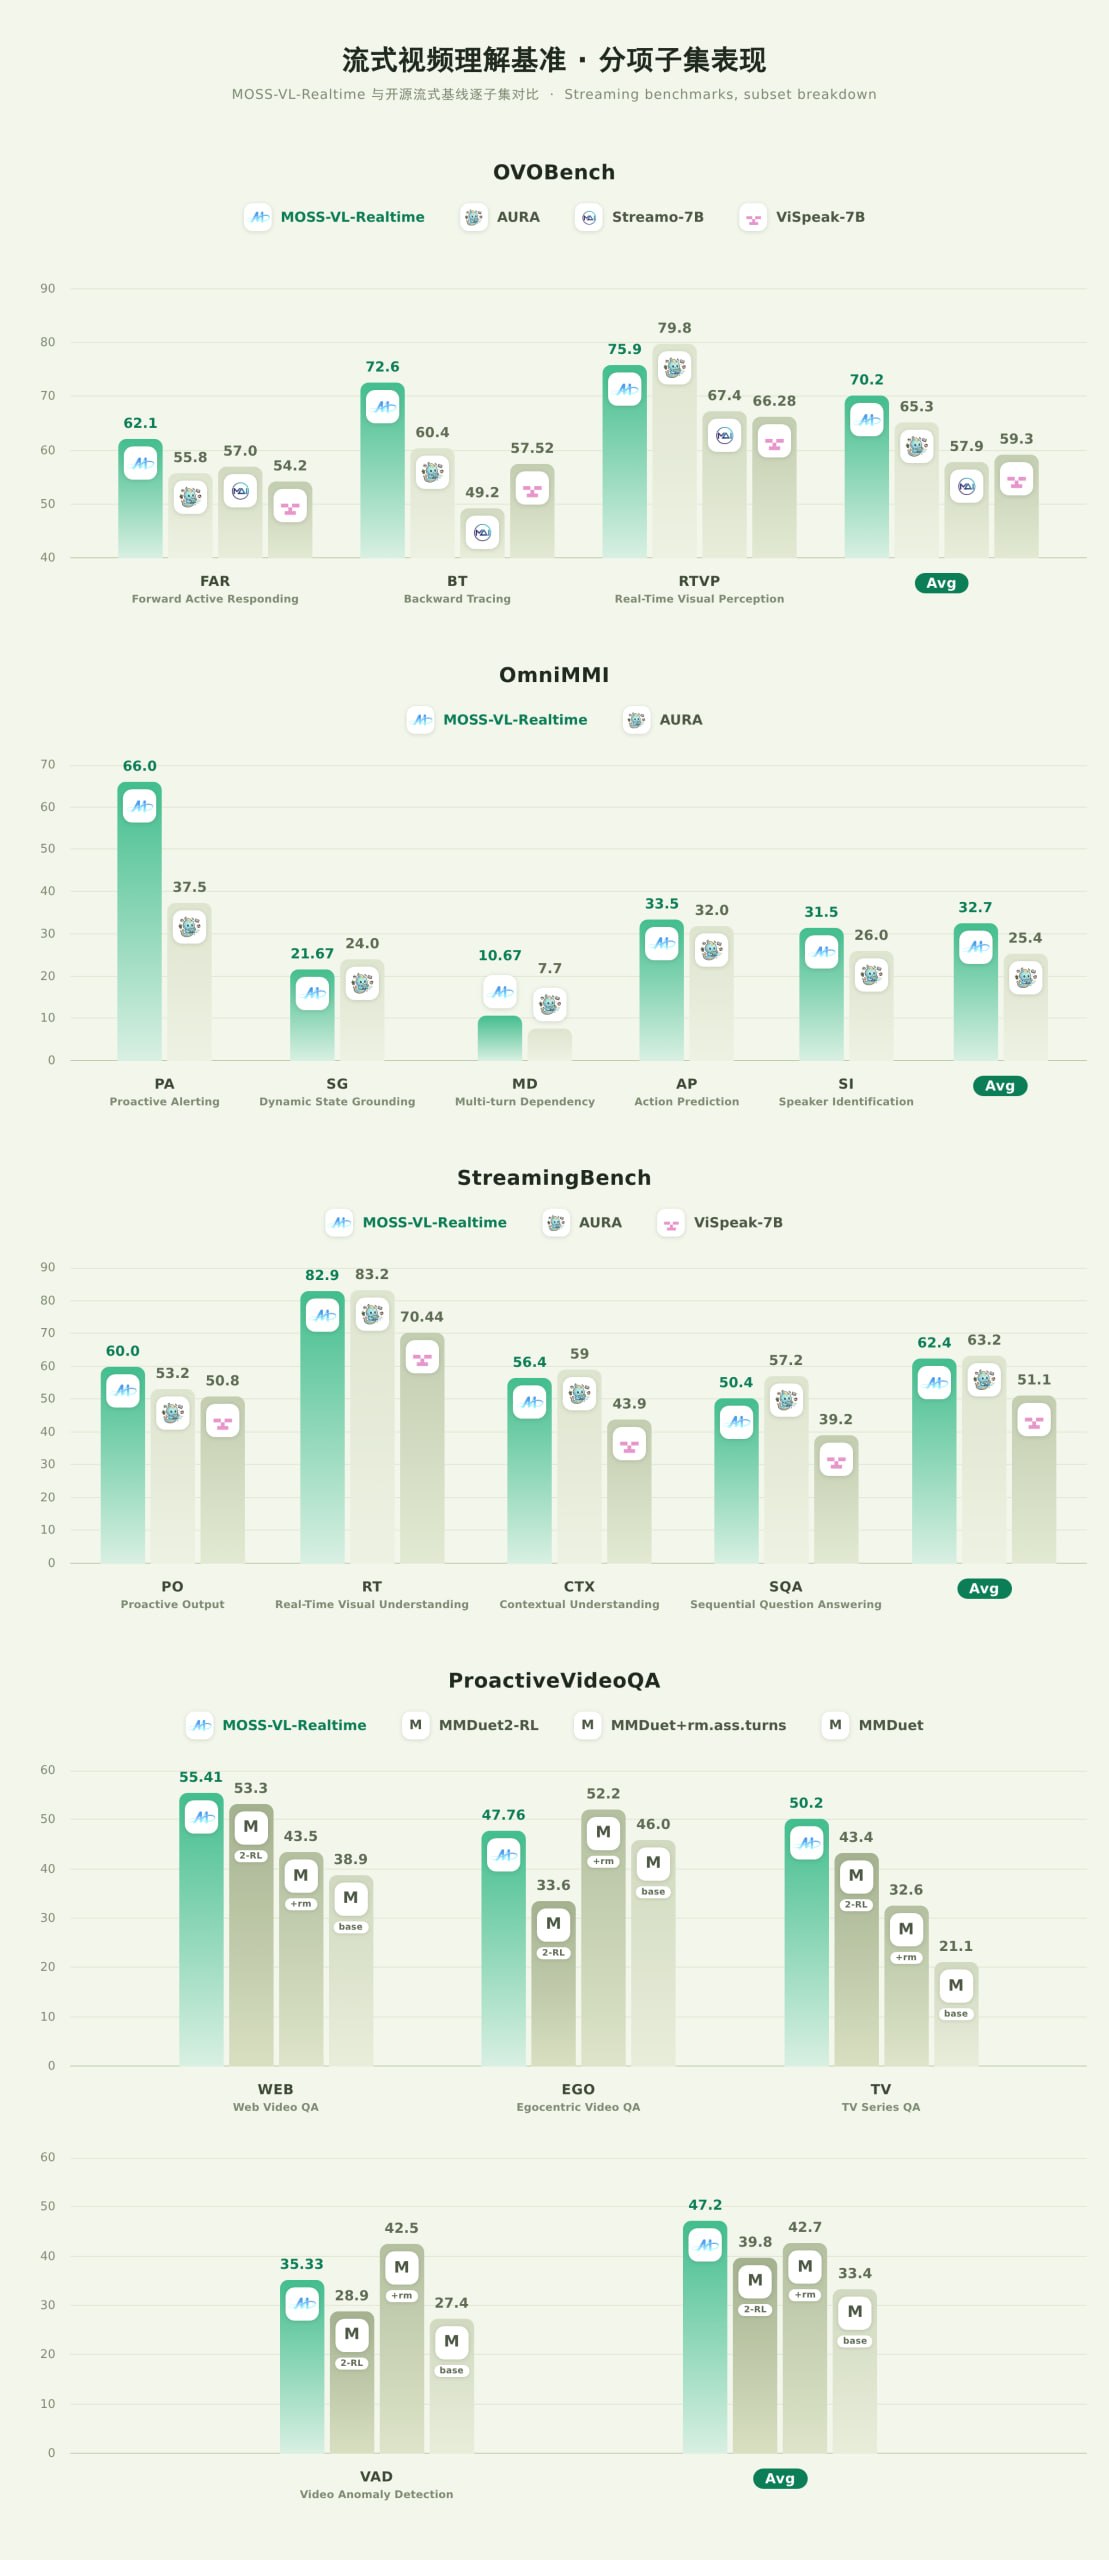
OpenMOSS представила MOSS-VL-Realtime

Н@GreenNeuralRobotsAI-инженер
2 мес
MOSS-VL-Realtime Потоковая видеоязыковая модель от OpenMOSS на 11B параметров, понимает видео в реальном времени • обработка кадров с привязкой к таймстампам • прерываемое взаимодействие в потоке • динамическая коррекция ответов по новым кадрам • режим проактивной тишины при отсутствии событий • контекстное окно 256K • работа с потоковым видео без ожидания конца Демо Демо2 #streaming #vlm #qa #realtime
OpenMOSS представила MOSS-VL-Realtime

Как устроено хранение и доставка видео в интернете

К@d_codeмедиа / агрегатор
2 мес
🤩 Где хранятся все видео из интернета Фильмы, трансляции и миллионы пользовательских роликов занимают петабайты памяти. При этом видео должно быстро загружаться и в Москве, и во Владивостоке, и в другой точке мира. Для этого видеосервисы распределяют контент между дата-центрами, основными хранилищами и сотнями CDN-серверов. Популярные ролики заранее размещают ближе к зрителям, а редко востребованные отправляют в «холодное» хранилище. По ссылке разобрались, где находятся все эти видео и какой путь они проходят до экрана пользователя: ☀️ https://kod.ru/gde-hranyatsya-video-i-kak-rabotaet-cdn
Как устроено хранение и доставка видео в интернете

Godox C100 — компактная камера без экрана и с прозрачным видоискателем

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

В сети завирусилась необычная камера Godox C100, которую называют самой странной камерой 2026 года. У неё нет привычного дисплея — вместо него прозрачный видоискательi, через который пользователь смотрит прямо на объект съёмки, а поверх картинки накладываются только рамка кадра, индикатор заряда и основные настройки.

Посмотреть снятые фото или видео на самой камере невозможно — для этого нужно подключить её к телефону или компьютеру. При этом устройство снимает фото и видео в 1080p, а стоит около $30 (~2400–2500 рублей), что делает его доступным гаджетом для тех, кто ищет нестандартный опыт съёмки.
65 граммоввес камеры Godox C100
128 ГБмаксимальный объём карты памяти
$30 (~2400–2500 рублей)цена устройства

Полный разбор →

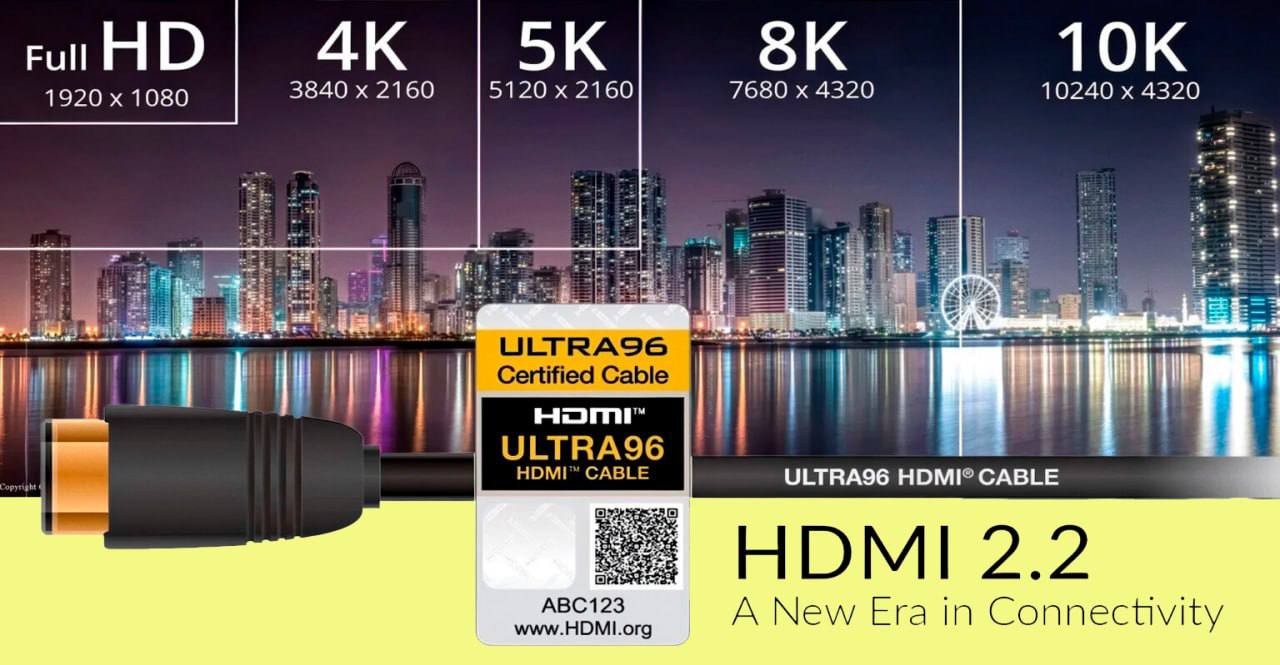
HDMI 2.2: перспективы и реальная необходимость

I@itcnewsruавтор про «tech»
2 мес
HDMI 2.2: перспективы и реальная необходимость
Ещё ↓