#рецепт
В чём настоящая ценность Agent Skills.
Часть 2
В прошлой части я докрутил мысль, что skill - это workflow package, а не промпт в папочке. Теперь о том, почему у одних скиллы работают, а у других превращаются в markdown-папку с надеждой на чудо или вообще не вызываются
Главный подвох: настоящий прикол не только в
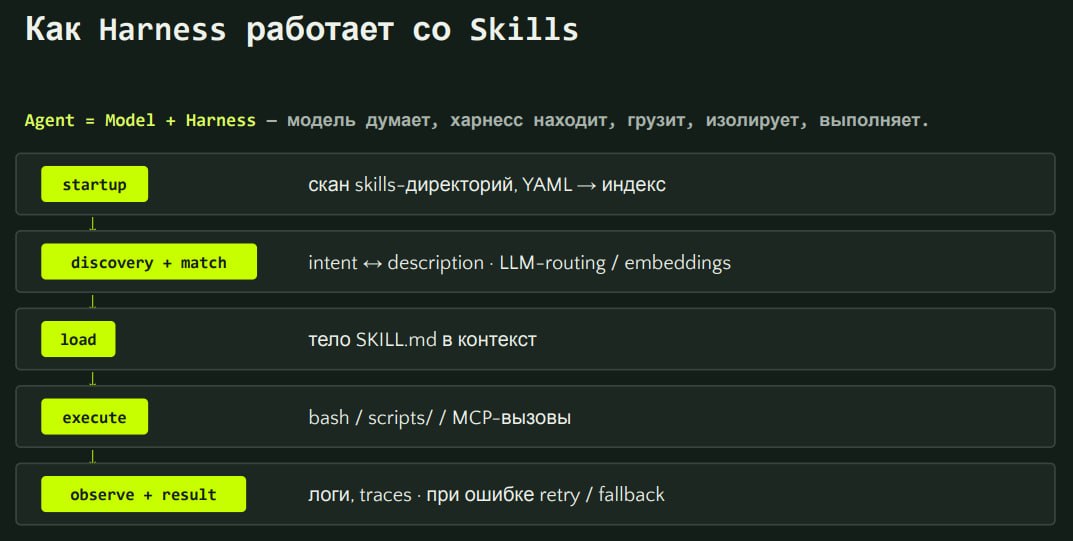
SKILL.md, а в связке Skill + Agent Harness. Harness - это рантайм вокруг модели: поиск skills, выбор нужного, загрузка инструкций, запуск tools/MCP/shell, права, traces, approvals. Хороший инженерный разбор есть у Addy Osmani:
https://addyosmani.com/blog/agent-harness-engineering/
1) Progressive disclosure - причина почему скиллы масштабируются
Агент не должен держать в контексте всю корпоративную библиотеку знаний. Сначала он видит только name + description, потом при выборе грузит
SKILL.md, а уже после этого читает references/, assets/, examples/ или исполняет scripts/
Именно поэтому skill лучше гигантского
AGENTS.md на 3000 строк.
AGENTS.md - always-on фон, skill - on-demand способность. У Codex это описано тут:
https://developers.openai.com/codex/skills, у Claude Code тут:
https://code.claude.com/docs/en/skills (с CC конечно есть нюансы)
Практический совет: в
SKILL.md оставляй короткую процедуру, а длинные политики, API-доки, JQL-справки, шаблоны отчетов и примеры выноси в references/assets/examples. Если
SKILL.md раздулся в трактат, вероятность его работы крайне низка
2) description - главный триггер, а не аннотация для красоты
Частая ошибка: красивое тело скилла и бесполезный description. Агент выбирает skill именно по description, поэтому "Helps with code" - мусор. Это как задача в Jira с названием "Сделать нормально"
Нормальный description отвечает: какую задачу делает skill, когда применять, какие слова его триггерят, какие входы нужны, какой результат вернуть и когда НЕ использовать. Пиши скиллы на 1 языке, не используй англорусский, шалоказахский и хинглиш
Плохой пример: Helps with project management
Лучше: Checks Jira sprint health, finds blocked issues, stale tasks, missing owners and release risks. Use before daily status update or weekly project report. Do not use for backlog prioritization
Для проектирования смотри skill-creator от Anthropic:
https://github.com/anthropics/skills/blob/main/skills/skill-creator/SKILL.md
3) Anti-rationalization надо писать прямо в инструкции
Агент любит срезать углы не хуже менеджера перед пятничным демо. Он легко скажет изменение маленькое, визуально норм, тест-ран тут большой не надо запускать и тд. Поэтому в skill надо писать правила против отговорок
Примеры:
- - -
- если есть diff, сначала inspect, потом summary, потом plan
- если действие меняет внешнюю систему, сначала dry-run
- если есть write/delete/update, нужен explicit approval
- если нет данных, верни missing context, а не додумывай
- если scanner не запускался, не пиши что проверка пройдена
- - -
В twinby я бы такие штуки паковал в jira-daily-radar, spec-quality-checker, release-readiness, browser-manual-test и confluence-sync. Не "агент, расскажи статус", а процедура: откуда читать, что считать риском, какой формат отчета, где нужен человек
4) Skill надо тестировать не только на результат, но и на срабатывание
Минимальный набор:
- explicit activation test: вызвался руками
- implicit activation test: вызвался по естественному запросу
- negative test: не вызвался там, где не должен
- golden samples: вход -> ожидаемый выход
- unit tests для scripts/
- trace review: видно какие шаги реально прошли
- with/without skill: есть ли прирост качества, времени или стабильности
По evals полезны OpenAI материалы:
https://developers.openai.com/blog/eval-skills и разбор Phil Schmid:
https://www.philschmid.de/testing-skills
Хороший skill скучный: он умеет только 1 штуку делать, явно триггерится, явно проверяет, явно падает и явно просит апрув. Всё остальное обычно демка для LinkedIn/X/чата ваших фанатов в телеграм