ИИ

SoftBank привлекает $11 млрд через облигации для инвестиций в OpenAI

1 мес
SoftBank привлекает $11 млрд через облигации для инвестиций в OpenAI

Темпы внедрения платных ИИ-сервисов в США

G@aiofthedayAI-инженер
1 мес
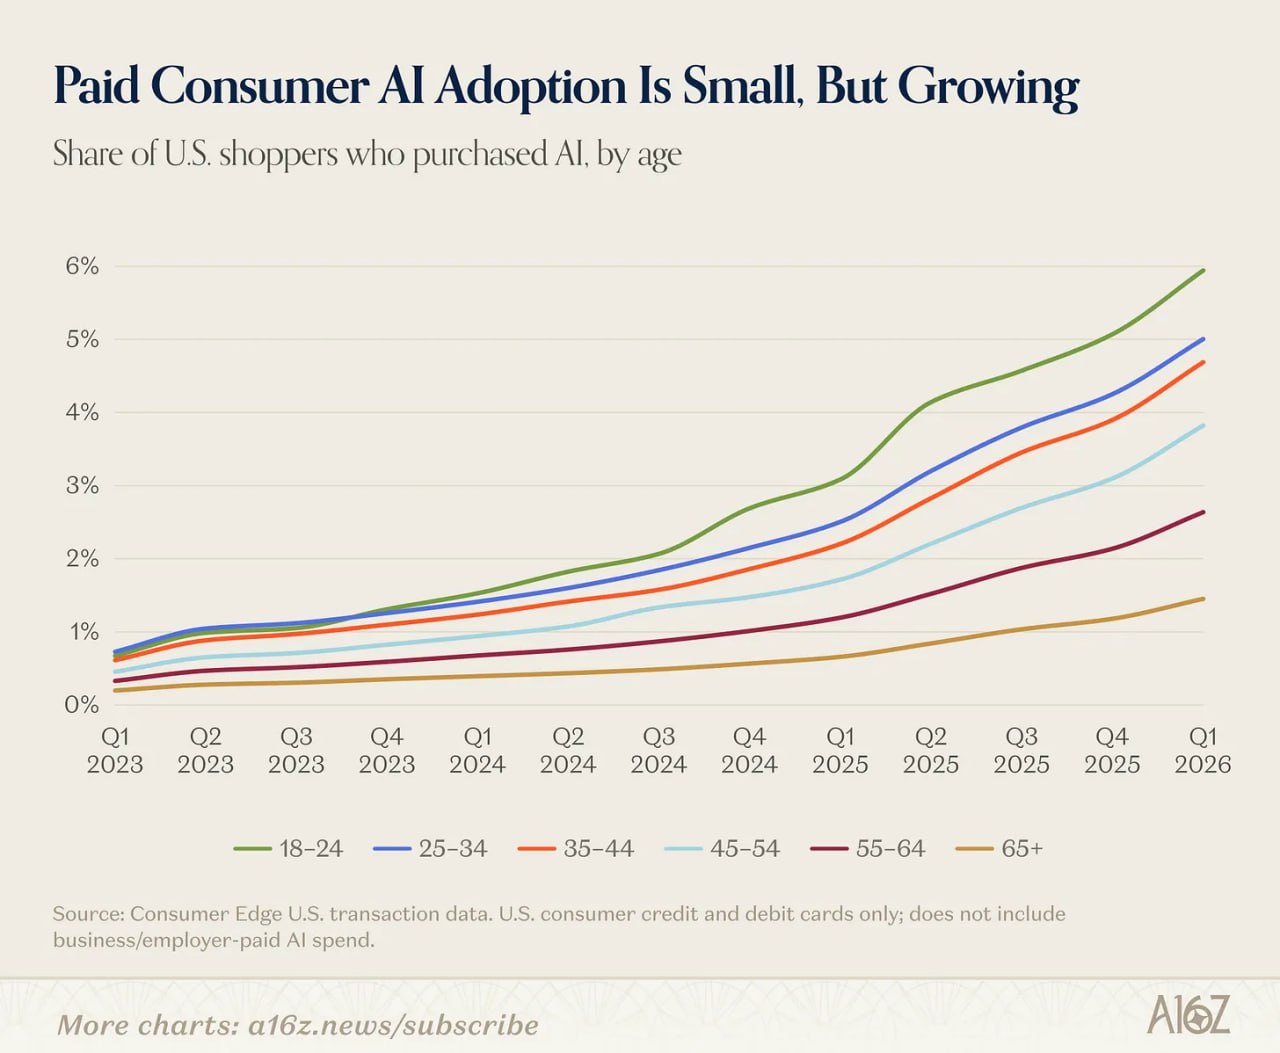
Даже в США платную версию ChatGPT или аналога используют единицы процентов населения. Это всё равно очень быстро, если сравнивать с электричеством, телевизором и т. п.. Но все-таки очень медленно, если думать о 95%, которые ещё не прониклись. График взял тут.
Темпы внедрения платных ИИ-сервисов в США

Подозрения на скрытую подмену моделей в Codex

A@abstractDLAI-инженер
1 мес
Замечаете, как Codex иногда неожиданно тупеет? Возможно, вместо Astra вам отвечает… Luna. Все ругались на антропик из-за тихого опутпения Fable на "потенциально опасных задачах", но кажется у Codex нашёлся свой вариант этого развлечения - в ответе gpt-6-astra тихо подменяется на gpt-5.6-luna. Я полез в трейсы и нашёл такое примерно в 2% ответов. Это не только моё наблюдение, есть ещё несколько связанных репортов. Печаль.

AI решает старые открытые задачи математики: подборка прорывов

Т@tech_priestessAI-инженер
1 мес

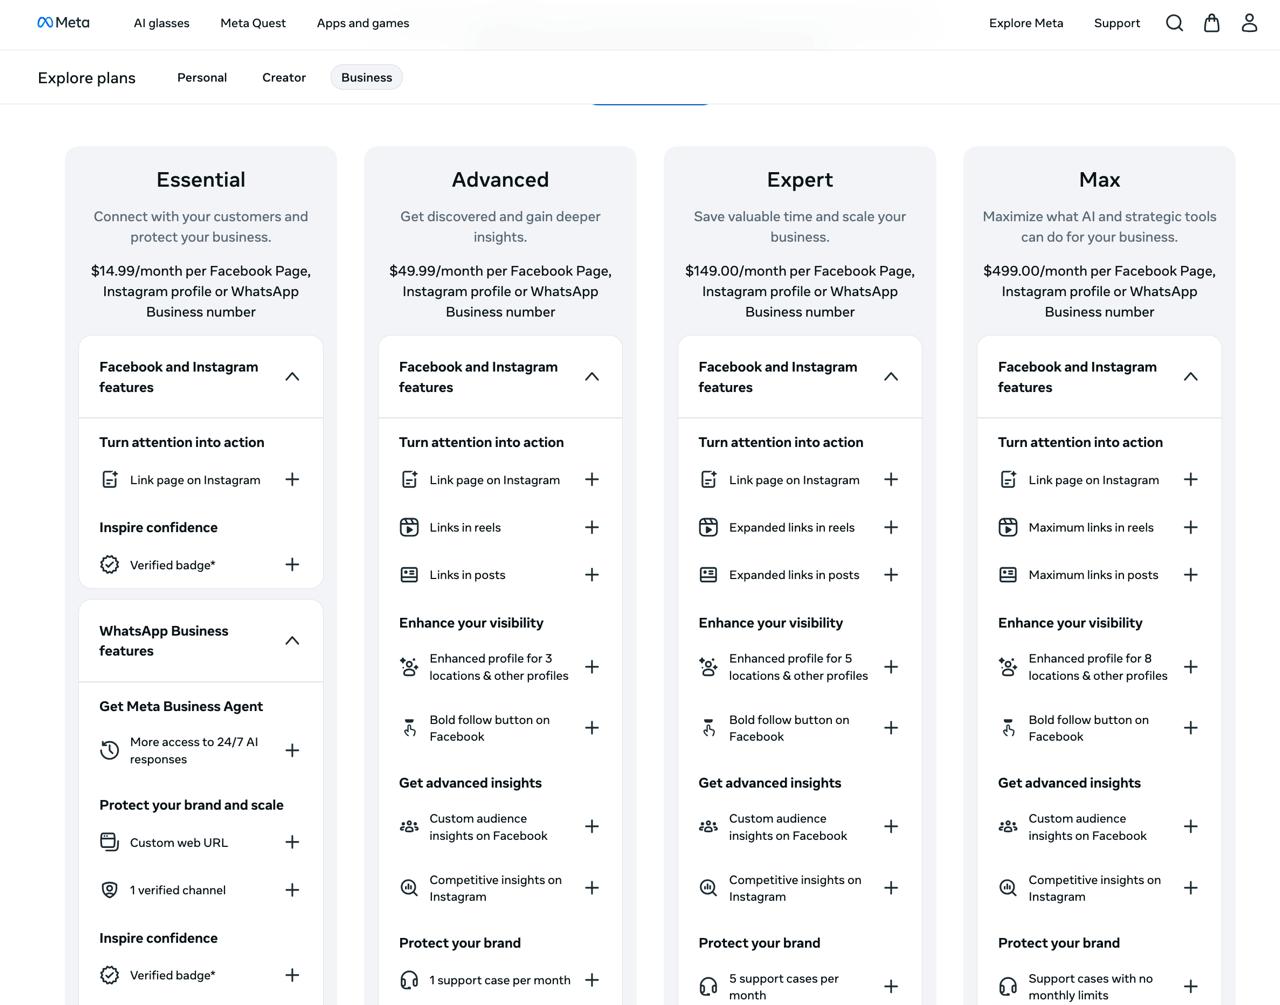
Обзор обновлений в Meta, Google Ads и AI-индустрии

Б@ezhov_targetingавтор про «marketing»
1 мес
Обзор обновлений в Meta, Google Ads и AI-индустрии

Поиск облачных альтернатив Strophe для генерации изображений и видео

U@uxliveмедиа / агрегатор
1 мес
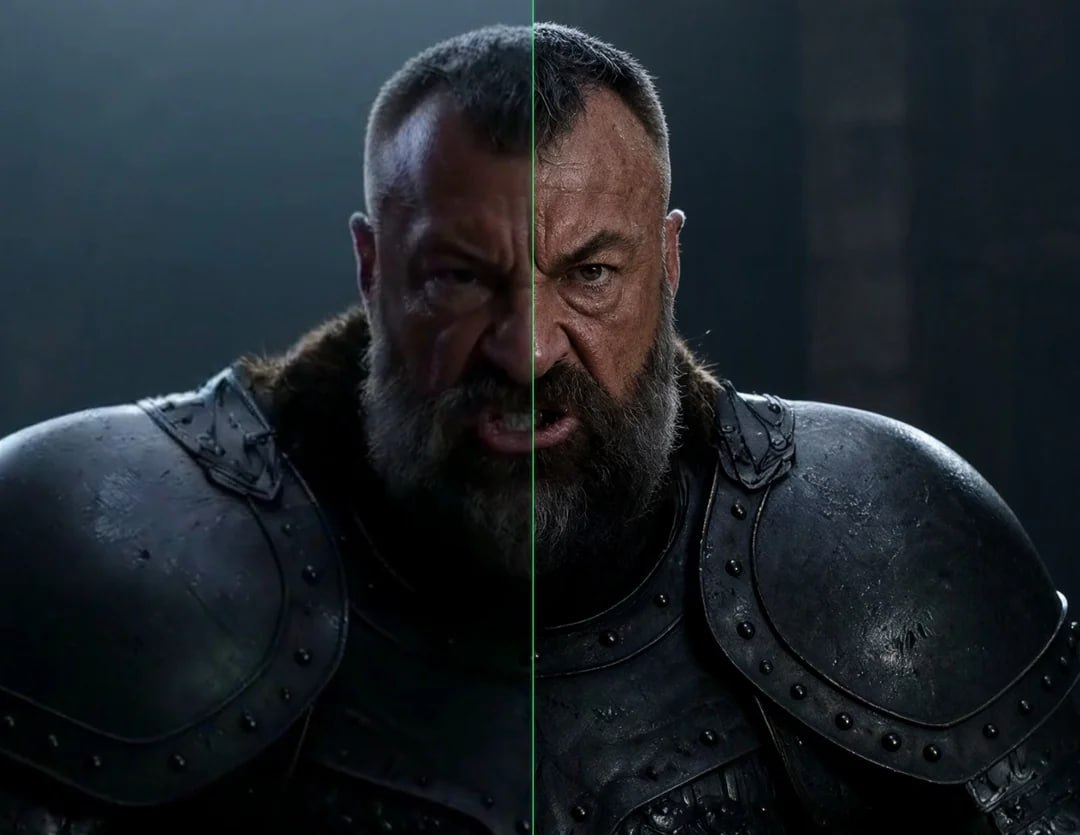
Какой сейчас самый заебатый агрегатор нейронок для картинок\видео, желательно с нодовой системой? Я почти год пользовался https://strophe.app/ и меня всё в нём устраивало, но теперь хочется попробовать что-то ещё. Чем пользуетесь? ComfyUI и прочий локальный кал не предлагать, интересуют сидэнсы, бананы и прочее.

OpenJev: разработчик AlexWortega воспроизвёл «хайповую модель из твиттера» через MLP над Qwen 4B

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 1 мес назад

Разработчик под ником AlexWortega обучил простую MLPi-надстройку над языковой моделью Qwen 4Bi и выложил результат на Hugging Facei под названием openjev, заявив, что модель работает «буквально как та хайповая модель из твитера». Пост опубликован в канале Love. Death. Transformers. 16 сентября 2026 года.

Спустя пять дней, 21 сентября, автор дополнил проект публичным демо-спейсом с веб-интерфейсом, поблагодарив за помощь других участников комьюнити — так модель стала доступна для тестирования без локального запуска.
4Bразмер параметров базовой модели Qwen

Полный разбор →

В Калифорнии планируют внедрить «стоп-кран» для AI-моделей

G@aiofthedayAI-инженер
1 мес
В Калифорнии хотят обязать AI-компании создать «стоп-кран» Губернатор Калифорнии подписал закон об усилении контроля за передовыми моделями. Пока это список предложений. До 16 ноября эксперты должны решить, как технически реализовать возможность отключения мощных моделей, если что-то пошло не так. Предполагается, что независимые проверяющие будут регулярно проверять работоспособность выключателя и проводить аудит безопасности внутри крупных AI-компаний. https://www.gov.ca.gov/2026/09/18/governor-newsom-issues-executive-order-to-accelerate-independent-oversight-and-advance-the-creation-of-an-ai-kill-switch/

Выпущены модели QI2.1 Prompt Enhancer для ComfyUI

Н@GreenNeuralRobotsAI-инженер
1 мес
Выпущены модели QI2.1 Prompt Enhancer для ComfyUI

Утечки о следующей модели OpenAI под кодовым именем Bel

М@cgeventAI-инженер
1 мес

Дайджест инструментов и обновлений для MiniMax-H3

Н@GreenNeuralRobotsAI-инженер
1 мес
Дайджест инструментов и обновлений для MiniMax-H3

DeepSeek-V4.1-Flash: оптимизация LLM для агентных задач

D@datastorieslanguagesAI-инженер
1 мес

Внебалансовые гарантии техгигантов на AI-инфраструктуру

Б@blognotAI-инженер
1 мес

Новый метод претрейна LLM: усреднение токенов на входе и предсказание «мешка» токенов на выходе ускоряют обучение

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 1 мес назад

Исследователи предложили способ сэкономить вычислительные ресурсы при предобучении языковых моделей: на первом этапе претрейна модель учится не на отдельных токенах, а на усреднённых эмбеддингах нескольких подряд идущих токенов, при этом на выходе предсказывается не следующий токен, а «мешок» (bag-ofi) из нескольких следующих токенов без учёта их порядка. После этой стадии обучение продолжается в стандартном режиме.

Экономия достигается за счёт того, что через модель прогоняется в s раз меньше токенов, а значит за тот же вычислительный бюджет модель успевает увидеть больше данных из корпуса — в r·s + (1 − r) раз больше, где r — доля обучения на усреднённых токенах, s — размер окна усреднения.

ВыводМетод проверен на трёх dense llama-like моделях размером 270M, 600M и 3B, а также на MoE-модели 10B-A1B.
0.2–0.4оптимальная доля r обучения на усреднённых токенах
5–8оптимальный размер окна усреднения s
270M/600M/3B/10B-A1Bразмеры протестированных моделей

Полный разбор →

Как ИИ-агенты меняют новостную журналистику

Д@disruptors_officialмедиа / агрегатор
1 мес
Как ИИ-агенты меняют новостную журналистику

Анализ эффективности и маркетинга новых LLM-классификаторов

L@lovedeathtransformersAI-инженер
1 мес

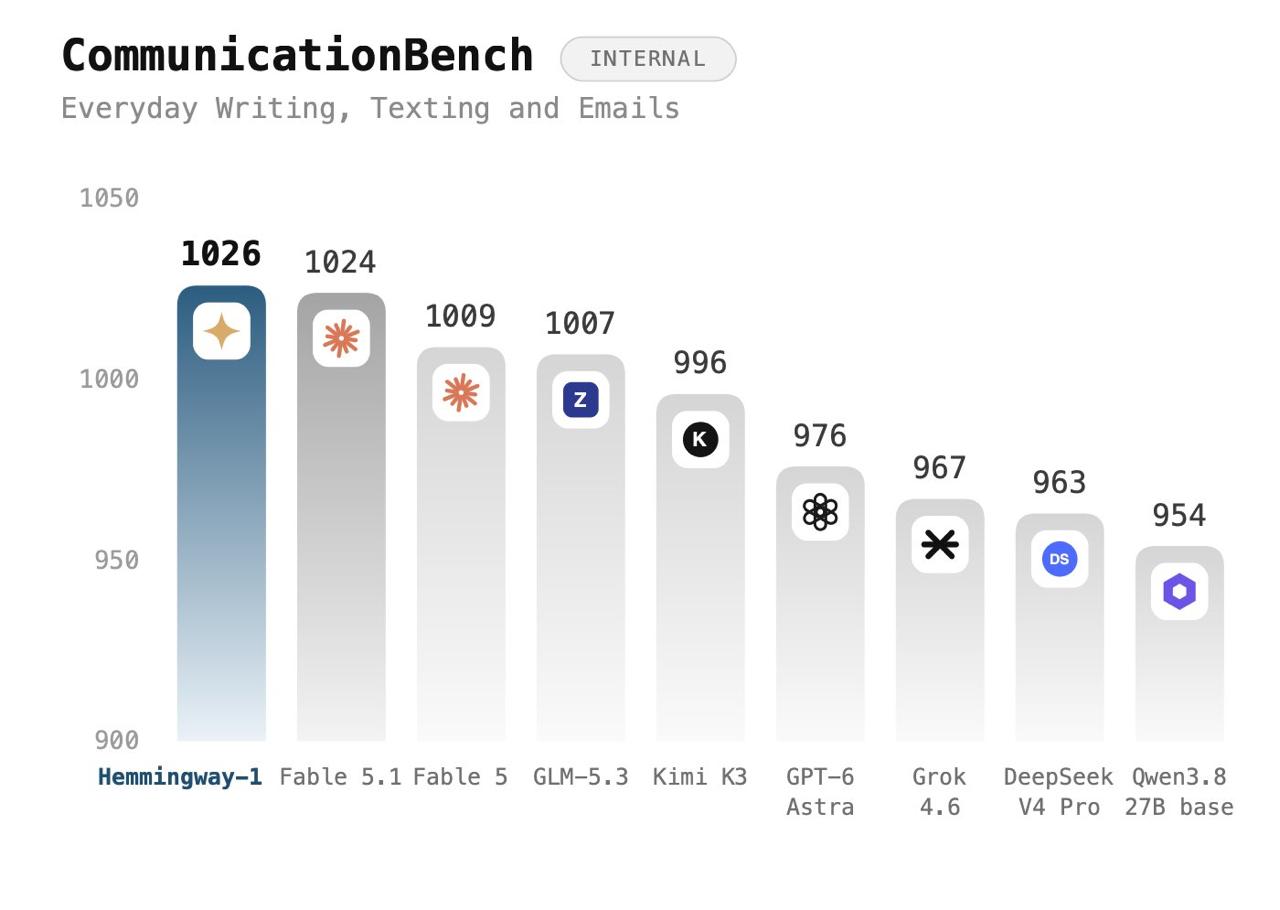
Выпущена открытая модель Hemmingway-1 для естественного письма

1 мес
Выпущена открытая модель Hemmingway-1 для естественного письма

Amazon заблокировала доступ AI-агента Muse от Meta к своему маркетплейсу

Б@blognotAI-инженер
1 мес

DeepSeek V4.1 Flash оказался лучшим ИИ-хакером в тесте Enclave

Компания Enclave прогнала несколько ИИ-моделей через свой бенчмаркi автономного хакинга: изолированные копии Grafana, Jenkins и Nextcloud с реальными уязвимостями, задача — получить выполнение кода на сервере без готового эксплойта и подсказок. Неожиданно лучший результат показала не топовая Opus или GPT, а дешёвая «флешка» DeepSeek V4.1 Flash — 11 успешных атак из 11 на уязвимые цели, при этом все 4 пропатченные версии выстояли.

Главный тревожный вывод: стоимость такой атаки — около $5, а время — минуты. Это меняет расклад в защите систем: теперь угрозу представляют не отдельные пентестеры, а потенциально тысячи параллельных автономных агентов, перебирающих гипотезы взлома за копейки.

ВыводМедианное время успешной атаки — 4 минуты 38 секунд, Grafana взламывалась за 52–90 секунд

11 из 11взломанных уязвимых целей
$4.65стоимость успешной атаки
2 349выполненных bash-команд за прогон

Полный разбор →

Ещё ↓