SOMA восстанавливает движения мышц по многокамерной съемке
Н@GreenNeuralRobotsAI-инженер
вчера
Исследователи Imperial College представили Dense4D — feed-forwardi модель для плотной 4D-реконструкции человека по обычным монокулярным RGB-кадрам, без шаблона тела. Она связывает точки поверхности между кадрами, несмотря на движения, деформации и изменения видимости.
Модель нацелена на проблему, при которой существующие методы получают несколько смещённых копий тела — по одной на кадр. В тесте 4D-Dress Dense4D лучше согласуется со сканами даже тогда, когда опорный кадр показывает лишь часть тела.
ВыводDense4D присваивает каждому пикселю человека 3D-позицию поверхности на общем опорном времени, формируя Human Point Maps (HPM).
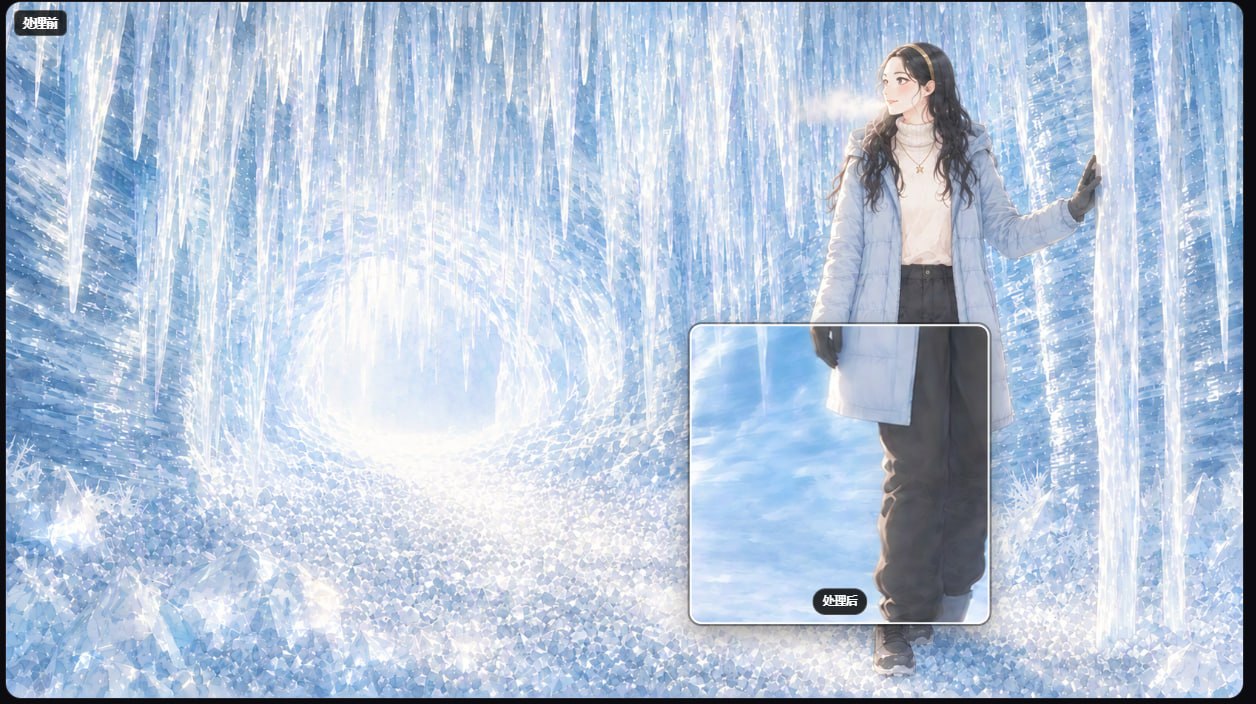
Microsoft выпустила (почти в опенсорсе — код пока не опубликован) базовую модель LensErasei, которая по паре «изображение + маска» убирает с картинки что угодно: объекты, текст, водяные знаки, логотипы, а также их тени и отражения. Модель работает за один проход, без текстового промпта, и справляется со сложными случаями вроде слоистых постеров и нескольких объектов одновременно.
Значимость в том, что LensErase обучена специально распознавать «побочные эффекты» удаляемого объекта — тени, отражения, следы его присутствия, выходящие за границы выделения, — и при этом не трогает остальную часть кадра благодаря отдельному механизму восстановления TraceFusioni.
ВыводСхема работы: на входе изображение и маска выделения (нарисованная вручную или через SAM 2), текстовый промпт не требуется, на выходе — чистый кадр