Tencent представила WeVisOne-VL-2B для задач компьютерного зрения
Н@GreenNeuralRobotsAI-инженер
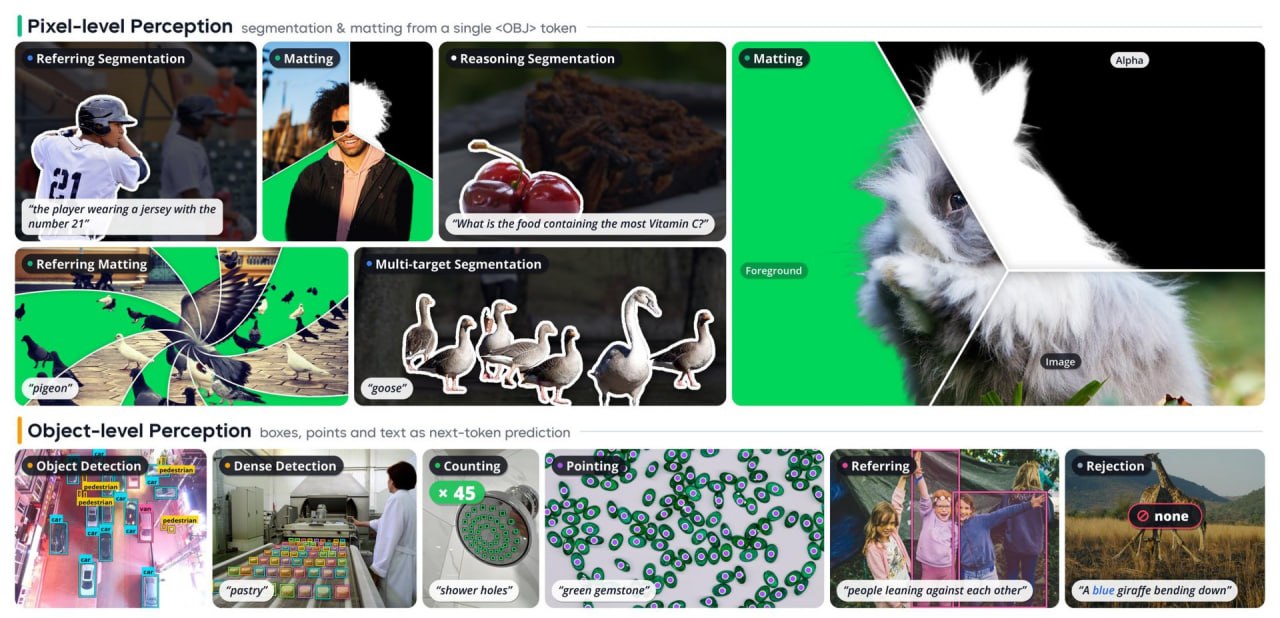
4 днWeVisOne-VL-2B объединяет детекцию, поиск по описанию, подсчет объектов, OCR, сегментацию и маттинг по подсказке.
Одна модель может выполнять сразу несколько задач анализа изображений, которые обычно решают отдельными инструментами.
- Модель объединяет детекцию, подсчет, OCR, сегментацию и маттинг по подсказке.
- Она может искать и локализовать объекты по текстовому описанию.
- Работает с отдельными изображениями, но не с сеткой видео.
WeVisOne-VL-2B
Одна модель Tencent на замену пачке узких: детекция, поиск по описанию, счет объектов, указание точки, #OCR, сегментация и маттинг по подсказке
Все задачи сводятся к структурному предсказанию токенов, поэтому один проход закрывает рамки, маски и альфу в полном разрешении. Работает с одиночными картинками, сетку видео не принимает. Слабое место - сложная прозрачность и сильные перекрытия
• Находит объекты без заранее заданного списка классов
• Локализует по описанию словами и ставит точку на объекте
• Считает объекты и читает текст с координатами
• Режет объект по текстовому запросу
• Делает альфу с мягкими краями, например для вырезания человека
База Qwen3-VL, 2B
github.com/Tencent/WeVisOne-VL
huggingface.co/tencent/WeVisOne-VL-2B
huggingface.co/spaces/hugging-apps/wevisone-vl-4b
#detection #cv #segmentation
MAX
Кратко (AI)
Tencent представила WeVisOne-VL-2B — модель на базе Qwen3-VL, которая объединяет несколько задач компьютерного зрения: детекцию, поиск объектов по текстовому описанию, подсчет, OCR, сегментацию и маттинг. Она работает с одиночными изображениями, но не принимает сетку видео; среди ограничений названы сложная прозрачность и сильные перекрытия.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖