генерация изображенийСбросить фильтр ×

Krea 2 настроили для работы с Pose Studio

Н@GreenNeuralRobotsAI-инженер
12 ч

Canva выпустила дизайн-модель генерации изображений Craft

Canva представила Craft — свою первую модель генерации изображений, разработанную Canva Research специально для графического дизайна. Она сначала планирует композицию, а затем создает изображение; модель доступна в Canva бесплатно, через Dream Lab и публичный API.

Craft предназначена для коммерческих макетов — например, постеров, рекламы и обложек. В отличие от генераторов, ориентированных преимущественно на фотореализм, она учитывает расположение объектов, визуальную иерархию и текст, а результат можно дорабатывать в редакторе Canva.

2Kмаксимальное разрешение
55языков для текста
четвертое местопозиция в DesignArena

Полный разбор →

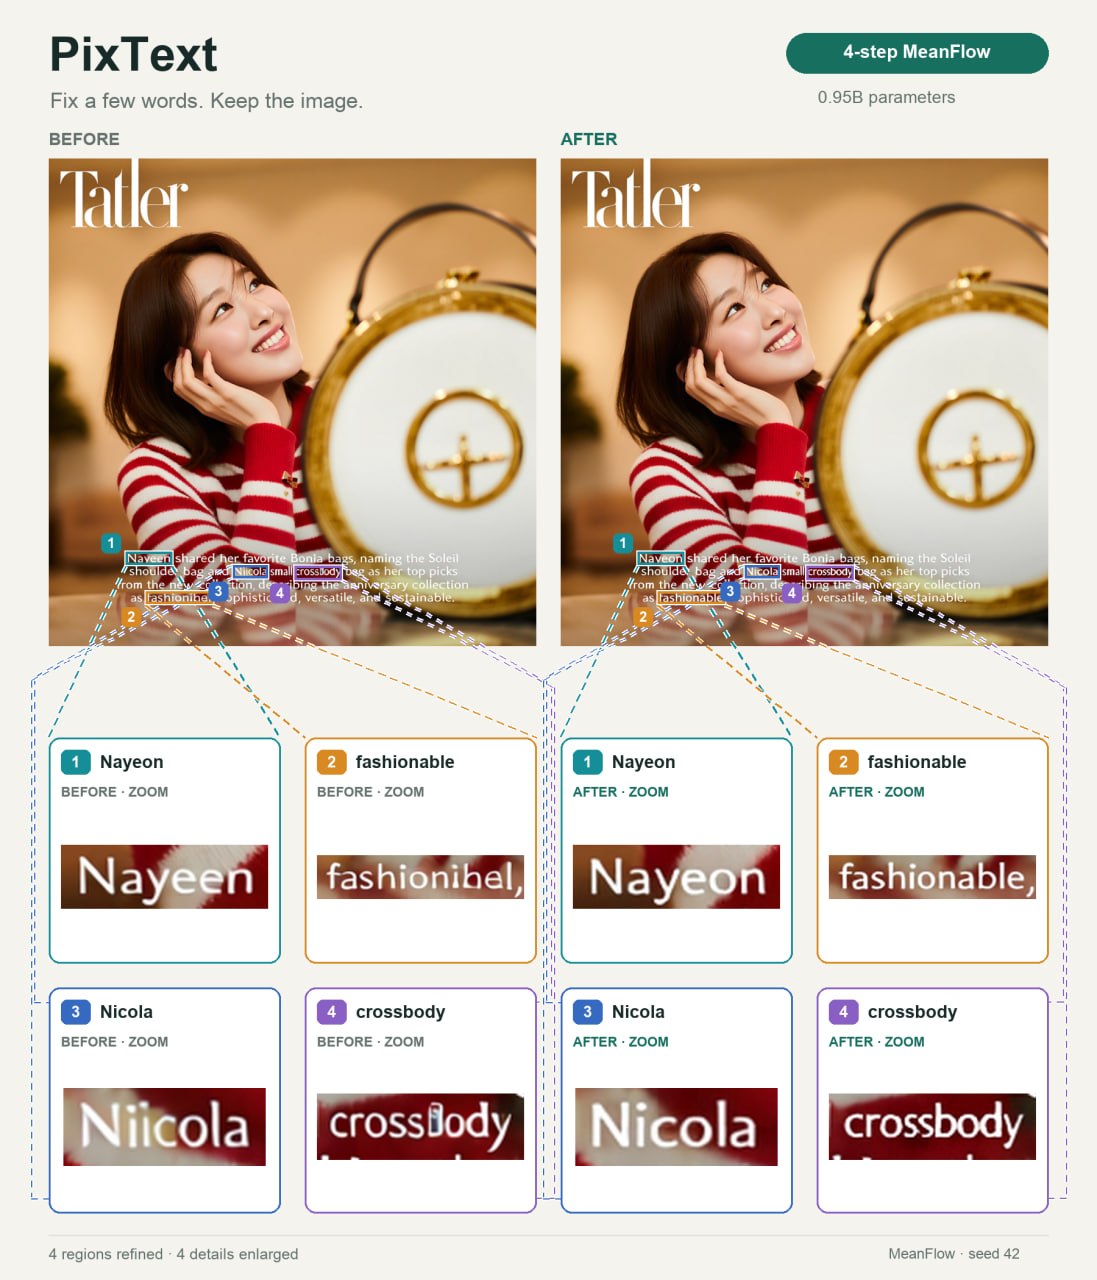
PixText исправляет текст на готовых изображениях

Н@GreenNeuralRobotsAI-инженер
3 дн
PixText исправляет текст на готовых изображениях

Opus 5.5 подготовил изображения в духе Самайна

F@FuturisAI-инженер
4 дн
Тут древний кельтский праздник, который знаменовал окончание сбора урожая, завершение светлой половины года и начало зимы начинается - Сама́йн если кто не знал🌚 Он же Хэллоуин, так вот Opus 5.5 подготовил пачку потустороннего вайба в разных стилях🎃 К этой теме будем ещё возвращаться на неделе🌟 вот сразу разница с китайскими модельками видна💀

Comfy-Org выпустила LoRA для генерации изображений от 4 МП

Н@GreenNeuralRobotsAI-инженер
4 дн
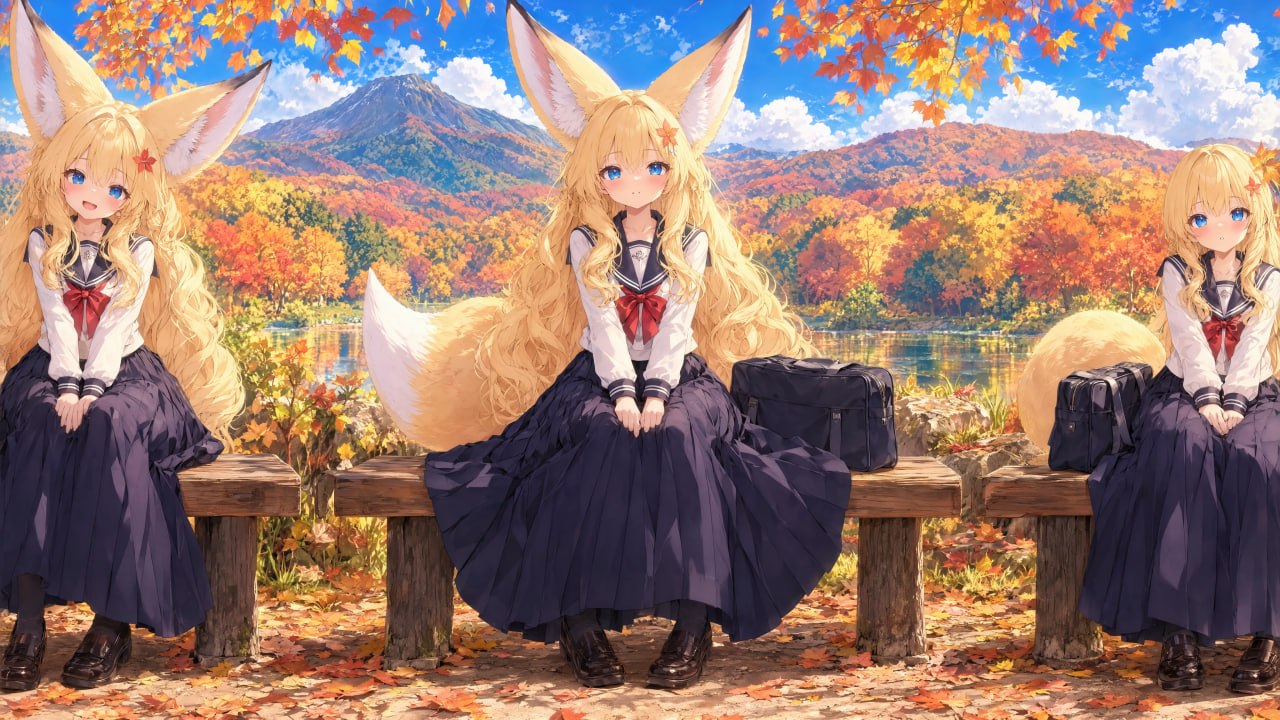
MOSS-Image MAX ULTRA hires LoRA Экспериментальная лора #MOSSImage от Comfy-Org обученная на генерацию от 4 мегапикселей. Обычно модели на таких разрешениях начинают повторять объекты и мылят мелкое, здесь это правят на уровне весов Первая картинка без лоры, вторая с лорой на 0.3 • Генерация в 4 МП и выше без апскейла • LoHa-адаптер, ставится поверх базовой модели • Три версии, v0.1, v0.2 и v0.3 • Примеры в 9 МП с прямым сравнением против базы • Обучено на смеси аниме и фотографий от 3,5 до 10 МП • База MOSS-Image-Base, сборка от Comfy-Org Демо #lora MAX
Comfy-Org выпустила LoRA для генерации изображений от 4 МП

Антигравити обошёл блокировки генератора и собрал постер

М@cgeventAI-инженер
4 дн
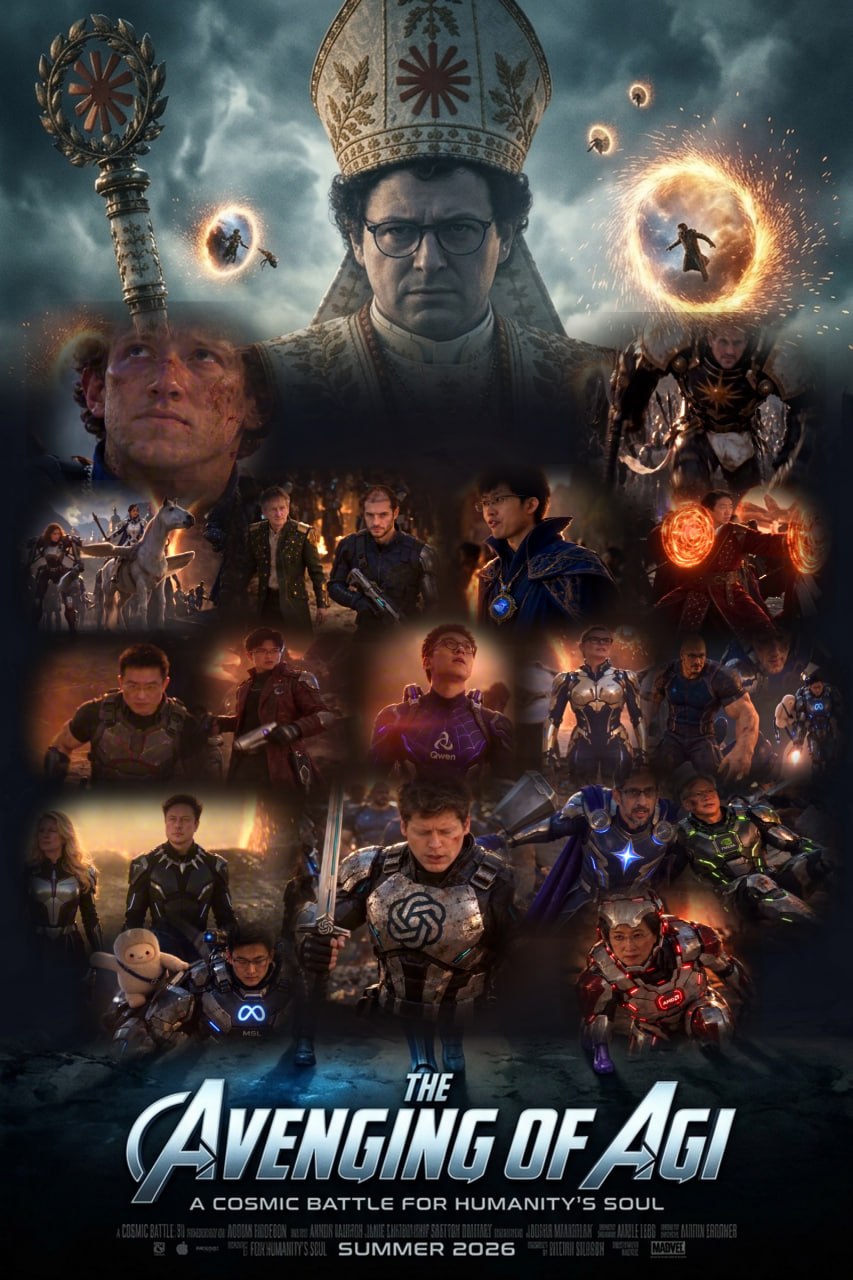
Антигравити обошёл блокировки генератора и собрал постер

Fibo 2.0 генерирует изображения в 2K без растяжения

Н@GreenNeuralRobotsAI-инженер
4 дн
Fibo 2.0 генерирует изображения в 2K без растяжения

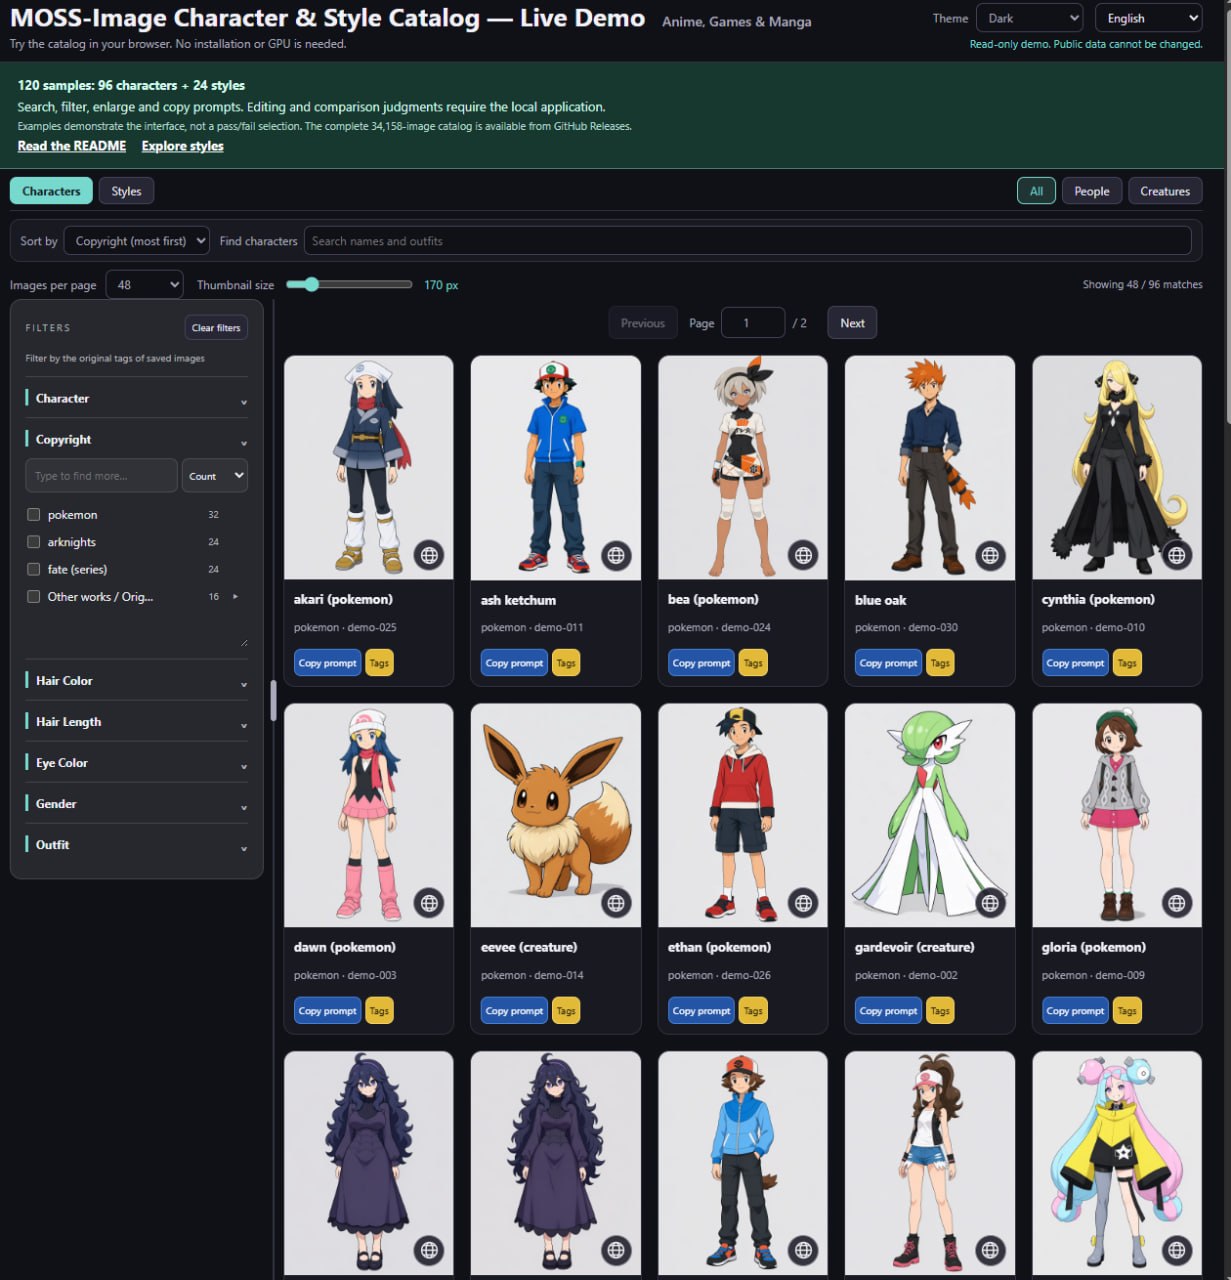
LoRA, инструменты и воркфлоу для MOSS-Image

Н@GreenNeuralRobotsAI-инженер
5 дн
LoRA, инструменты и воркфлоу для MOSS-Image

Adaptive Step Samplers добавляет настройки для sa_solver в ComfyUI

Н@GreenNeuralRobotsAI-инженер
6 дн

Black Forest Labs открыла веса генератора изображений FLUX 3 Image Klein

Black Forest Labs выпустила FLUX 3 Image Klein — модель генерации и редактирования изображений с открытыми весами. Она принимает до 10 референсов, поддерживает управление объектами через рамки и, по заявлениям источников, генерирует изображения вплоть до 4K.

Модель рассчитана на запуск на потребительских видеокартах: для оптимизированной INT8-сборки указывают минимум 8 ГБ VRAMi. Это делает локальную генерацию и редактирование доступнее, хотя для BF16-версии требуется значительно больше памяти.

5,6 млрдпараметров генератора
до 10референсов на вход
8 ГБминимум для INT8-сборки

Полный разбор →

Bria выпустила Fibo 2.0 Dev для генерации и редактирования изображений

Н@GreenNeuralRobotsAI-инженер
6 дн

LILIE предлагает смысловую функцию потерь для обучения генерации изображений

Н@GreenNeuralRobotsAI-инженер
1 нед
LILIE Энкодер из Стэнфорда, делает потери при обучении картинок умнее Пиксельная ошибка одинаково наказывает за шум на небе и за размытый самолет, хотя смысл у них разный. LILIE учит пространство, где расстояние ближе к смыслу. • Обратимый энкодер: картинка разбирается и собирается обратно без потерь • Обучен так, чтобы языковая модель по зашумленным признакам восстанавливала подпись • Дает готовую функцию потерь для текст-в-картинку, работает вместе с обычным пиксельным лоссом • В комплекте кодировщики и генеративные модели github.com/SuchirAgarwal/lilie huggingface.co/suchiragarwal/lilie #encoder #training MAX

Инструменты и доработки для MOSS-Image

Н@GreenNeuralRobotsAI-инженер
1 нед
Инструменты и доработки для MOSS-Image

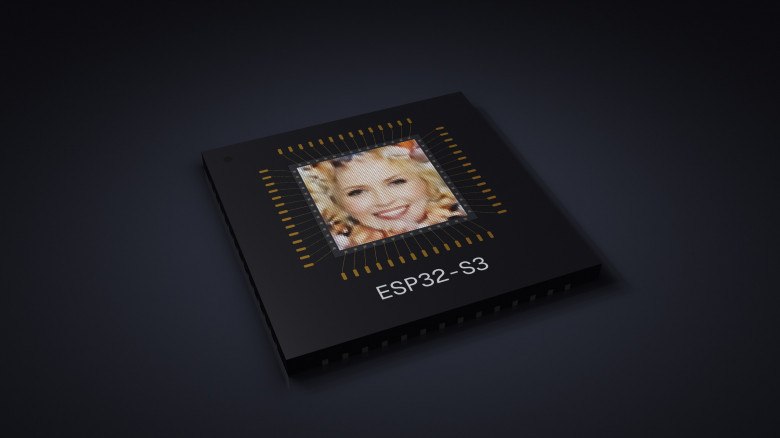
Диффузионный трансформер генерирует лица на ESP32-S3

Х@habr_comмедиа / агрегатор
1 нед
Диффузионный трансформер генерирует лица на ESP32-S3

Опубликован код Gaussian Light Transport и добавлена поддержка Ideogram 4 в AReA

Н@GreenNeuralRobotsAI-инженер
1 нед
Опубликован код Gaussian Light Transport - глобальное освещение как смесь 13-мерных гауссиан github.com/StokastX/gaussian-light-transport #gaussian #GI #rendering ——— В AReA прикрутили поддержку #ideogram4 (был только FLUX.1-Krea-dev) github.com/KooroshRH/AReA #4k #t2i MAX

Разработчик MOSS-Image ответил на вопросы о модели и планах

Н@GreenNeuralRobotsAI-инженер
1 нед

Meta представила модели Muse Wonder для долгого кодинга и ИИ-агентов

AI-редакция
17 источников · показать все· свернуть
FuturisMeta тестирует модель Muse Wonder для программированияFuturisMeta представила модели Muse Wonder и Muse Wonder Full для программирования и агентовvc.ruMeta представила модели Muse Wonder и Muse Wonder FullData SecretsMeta представила серию моделей Muse WonderMachinelearningMeta представила линейку моделей Muse Wonder для агентных задачБлоGнотMeta представила серию моделей Muse WonderКод.руMeta представила модели Muse Wonder и Muse Wonder Full3DNewsMeta представила ИИ-модели Muse Wonder и Muse Wonder FullGPT/ChatGPT/AI Central Александра ГорногоMeta представила модели Muse Wonder и Muse Wonder FullНейронавт | Нейросети в творчествеАнонс линейки моделей Muse Wonder для агентных задачМетаверсище и ИИщеMeta представила флагманские LLM Muse Wonder и Muse Wonder FullХайтек+Meta представила флагманские ИИ-модели Muse Wonder и Muse Wonder FullтехноданяMeta представила модель Muse WonderGPT/ChatGPT/AI Central Александра ГорногоЦукерберг планирует масштабные инвестиции в AIHow2AIРелиз Muse Wonder и Gemini 4 Argon: сравнение моделей️Нейросети: Волшебство ИИ, IT и маркетинг⚡️Meta представила ИИ-модели Muse Wonder и Muse Wonder FullБорис опятьДайджест AI/ML: новые модели, инструменты и обновления за неделю
хайп · 17обновлено 1 нед назад

Meta выпустила Muse Wonder и Muse Wonder Full — флагманские модели для программирования, персональных ИИ-агентов и длительных задач. Компания заявляет, что старшая версия конкурирует с Claude Opus 5.5 и GPT-6 Astra, а на части тестов превосходит их; независимые оценки подтверждают сильные результаты, но условия некоторых сравнений не полностью контролировались.

Muse Wonder доступна через Meta Model API и Muse Code, тогда как Full пока предлагается только на платных уровнях Muse Code. Запуск усиливает конкуренцию Meta с OpenAI и Anthropic и поддерживает её курс на создание персонального ИИ-помощника.

1 млн токеновмаксимальный контекст Wonder
79% против 74,2%результат DeepSWE 1.1
56 балловиндекс Artificial Analysis

Полный разбор →

Meta выпустила открытые веса Muse Spark Open

Meta выпустила Muse Spark Open — нативно мультимодальную модель с открытыми весами, ориентированную на программирование, ИИ-агентов и сложные многоэтапные задачи. В модели 816 млрд параметров, из которых активны около 42 млрд; контекстное окно — до 1 млн токенов. Meta называет её самой сильной американской моделью с открытыми весами.

Локальный запуск возможен на Apple silicon, но требования к памяти высоки: конфигурация, описанная источниками, предполагает две Mac Studio с M5 Ultra и суммарно 1 ТБ памяти. При этом Unsloth выпустила GGUF-версию с динамической 2-битной квантизацией, для которой достаточно машины с 256 ГБ памяти, хотя увеличение контекста требует дополнительной памяти.

816 млрдпараметров модели
1 млн токеновмаксимальный контекст
256 ГБпамять для компактной GGUF

Полный разбор →

Сравнение GPT Image и открытых моделей по пониманию промптов

М@cgeventAI-инженер
1 нед
Сравнение GPT Image и открытых моделей по пониманию промптов

Surjo-Image-Preview — микротрансформер для быстрой генерации изображений

Н@GreenNeuralRobotsAI-инженер
1 нед
Surjo-Image-Preview — микротрансформер для быстрой генерации изображений

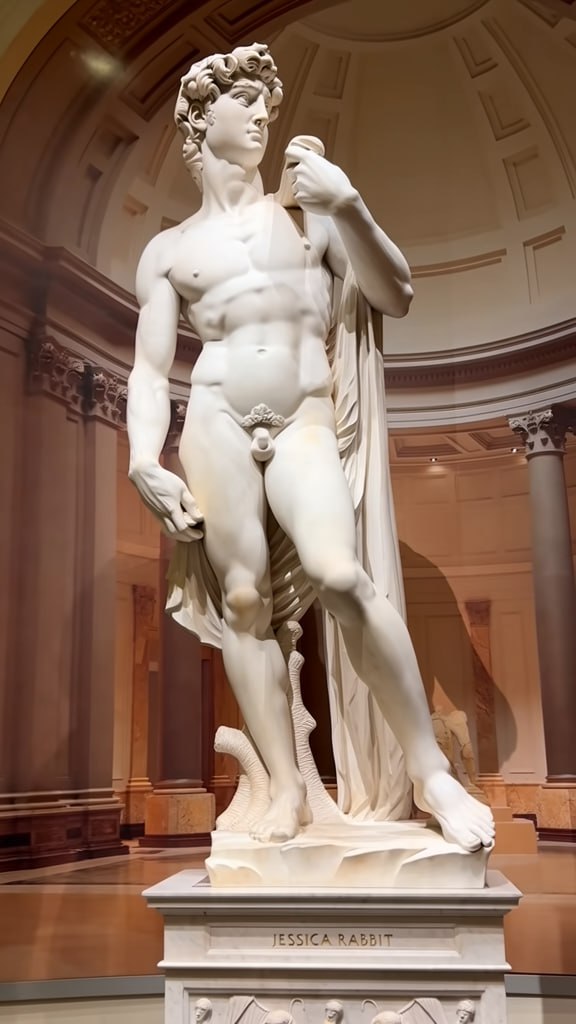
Тест MOSS: Джессика Рэббит в образе мраморной статуи

М@cgeventAI-инженер
1 нед
Тест MOSS: Джессика Рэббит в образе мраморной статуи

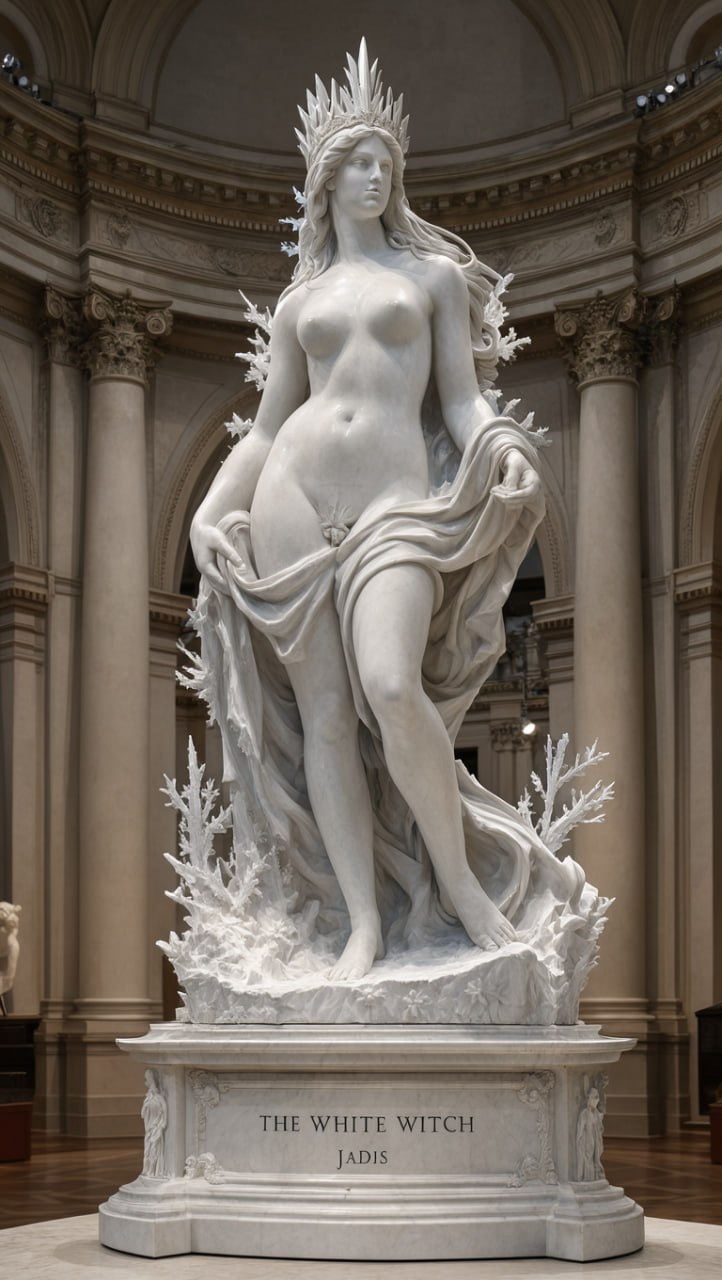
Flux Klein в тесте генерации музейных скульптур

М@cgeventAI-инженер
1 нед
Flux Klein в тесте генерации музейных скульптур

BudgetPix распределяет вычисления между участками изображения

Исследователи UIUC и Google представили BudgetPix — метод адаптивной токенизации для пиксельных моделей генерации изображений. Он выделяет больше токенов сложным областям сцены и меньше простым фонам, позволяя одной модели работать при разных вычислительных бюджетах.

Код BudgetPix опубликован 16 октября; метод рассчитан на интеграцию в существующие пиксельные диффузионные модели без их переделки.

ВыводОдна чекпойнт-модель поддерживает бюджеты от 100% до 10% токенов.

100% до 10%диапазон бюджета токенов
8опубликованные чекпойнты
16 октябрядата публикации кода

Полный разбор →

Ещё ↓