Анонс линейки моделей Muse Wonder для агентных задач
Н@GreenNeuralRobotsAI-инженер
2 недMeta представила модели Wonder и Wonder Full для агентных задач, превосходящие Claude Opus 5.5 в ряде бенчмарков, включая SWE-Marathon и Harvey.
Появление новых моделей для автоматизации сложных интеллектуальных задач может изменить стандарты эффективности ИИ-агентов.
- Модели Wonder ориентированы на длительные процессы, такие как написание кода и юридический анализ.
- Результаты тестов показывают значительный отрыв от текущих лидеров рынка в специализированных бенчмарках.
- Использование архитектуры Active Memory и Active Focus направлено на снижение галлюцинаций в сложных задачах.
Muse Wonder
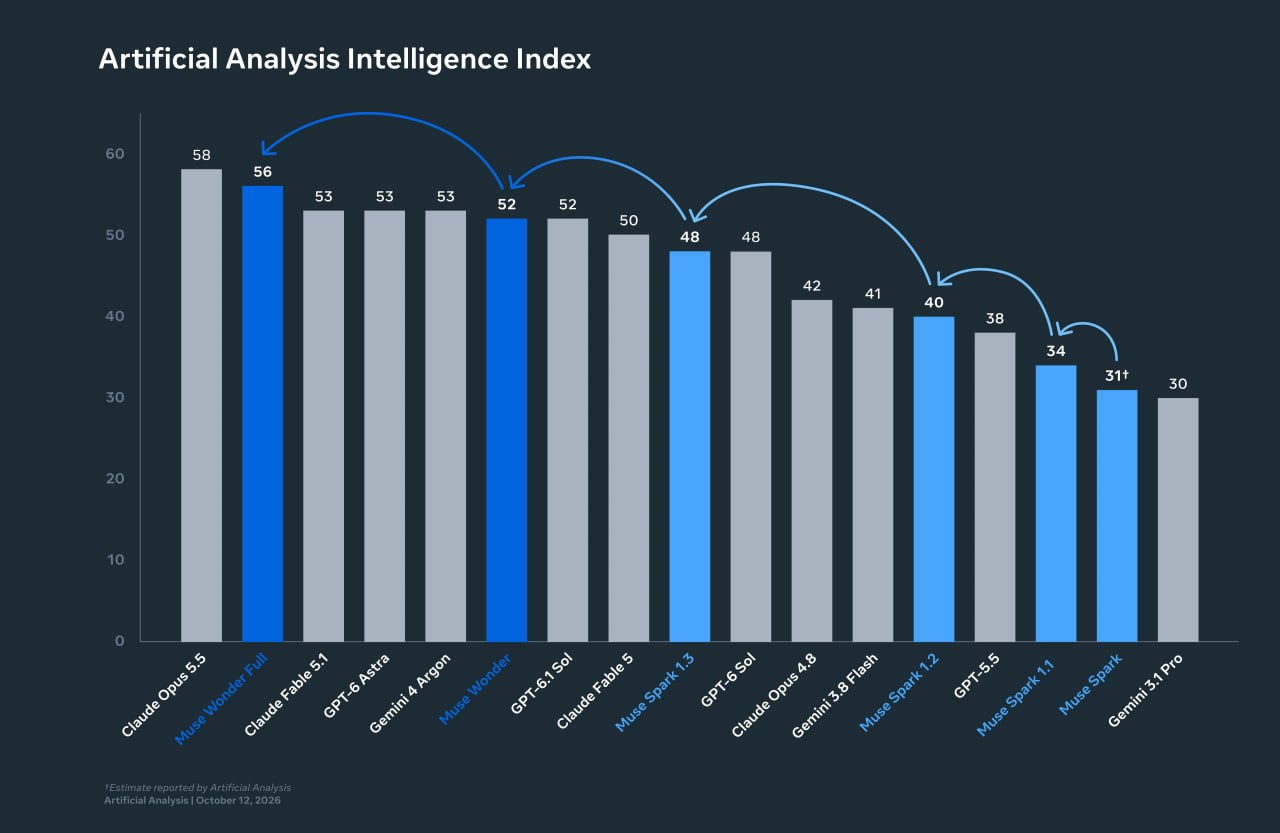
линейка сильных моделей для агентных задач: Wonder и старший Wonder Full. По данным Meta, Full обходит Claude Opus 5.5 на 8 из 14 бенчмарков.
• Долгий кодинг, юридическая работа, автоматизация бизнес-процессов
• Обгоняет GPT-6 Astra и Claude Fable 5.1 на длинных задачах
• Сверхдлинный инженерный тест SWE-Marathon: 57.5 против 46.3 у Opus 5.5
• Юридический агентный бенчмарк Harvey: 13.1 против 4.2 (без единой галлюцинации)
• Архитектура на Active Memory и Active Focus
• Wonder — через Meta Model API и Muse Code, Full — только подписчикам Muse Code
В SWE-Marathon Full работал на максимальном уровне рассуждений, а конкуренты — внутри своих агентов Codex и Claude Code. Так что это не строго контролируемое сравнение. Цифры Harvey низкие у всех — доводить сложные юридические задачи до конца пока не умеет никто. Прогоны делали независимые третьи стороны
#flagship #agent #coding
MAX
Кратко (AI)
Компания Meta анонсировала линейку моделей Wonder и Wonder Full, предназначенных для сложных агентных задач, таких как программирование и юридическая работа. Согласно заявленным данным, модель Full превосходит Claude Opus 5.5 в тестах SWE-Marathon и Harvey, используя архитектуру Active Memory и Active Focus.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖