📱
7.818 сообщений с родителями, и четверть из них – прогноз
Я уже давно залипаю на
r/dataisbeautiful. Увидел там недавно
интересный график про переписки с родителями, рассказываю
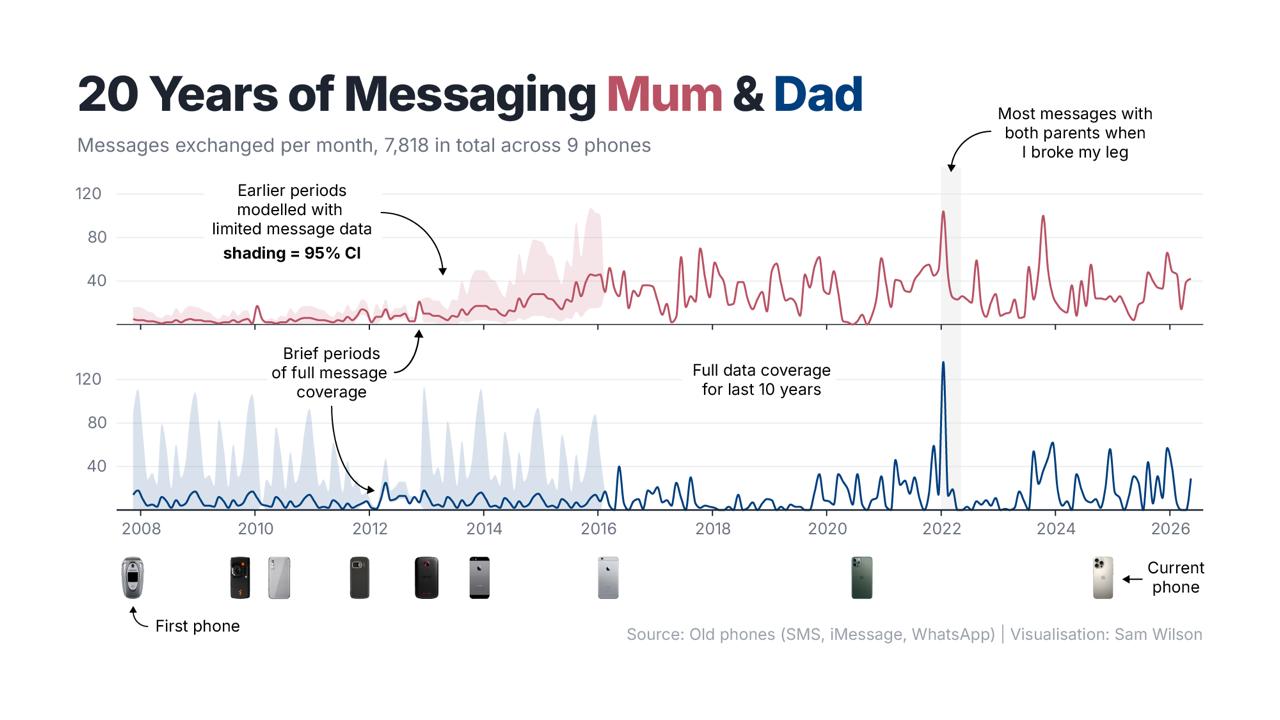
Сэм Уилсон свел в одну картинку 20 лет переписки с мамой и папой:
7.
818 сообщений с 9 телефонов, от раскладушки до нынешнего айфона
Самый плотный месяц за 20 лет – январь 2022, когда Сэм сломал ногу. С папой вышло
136 сообщений при обычных 8 в месяц, с мамой 104 при обычных 26. Второй пик – осень 2023, расставание и переезд
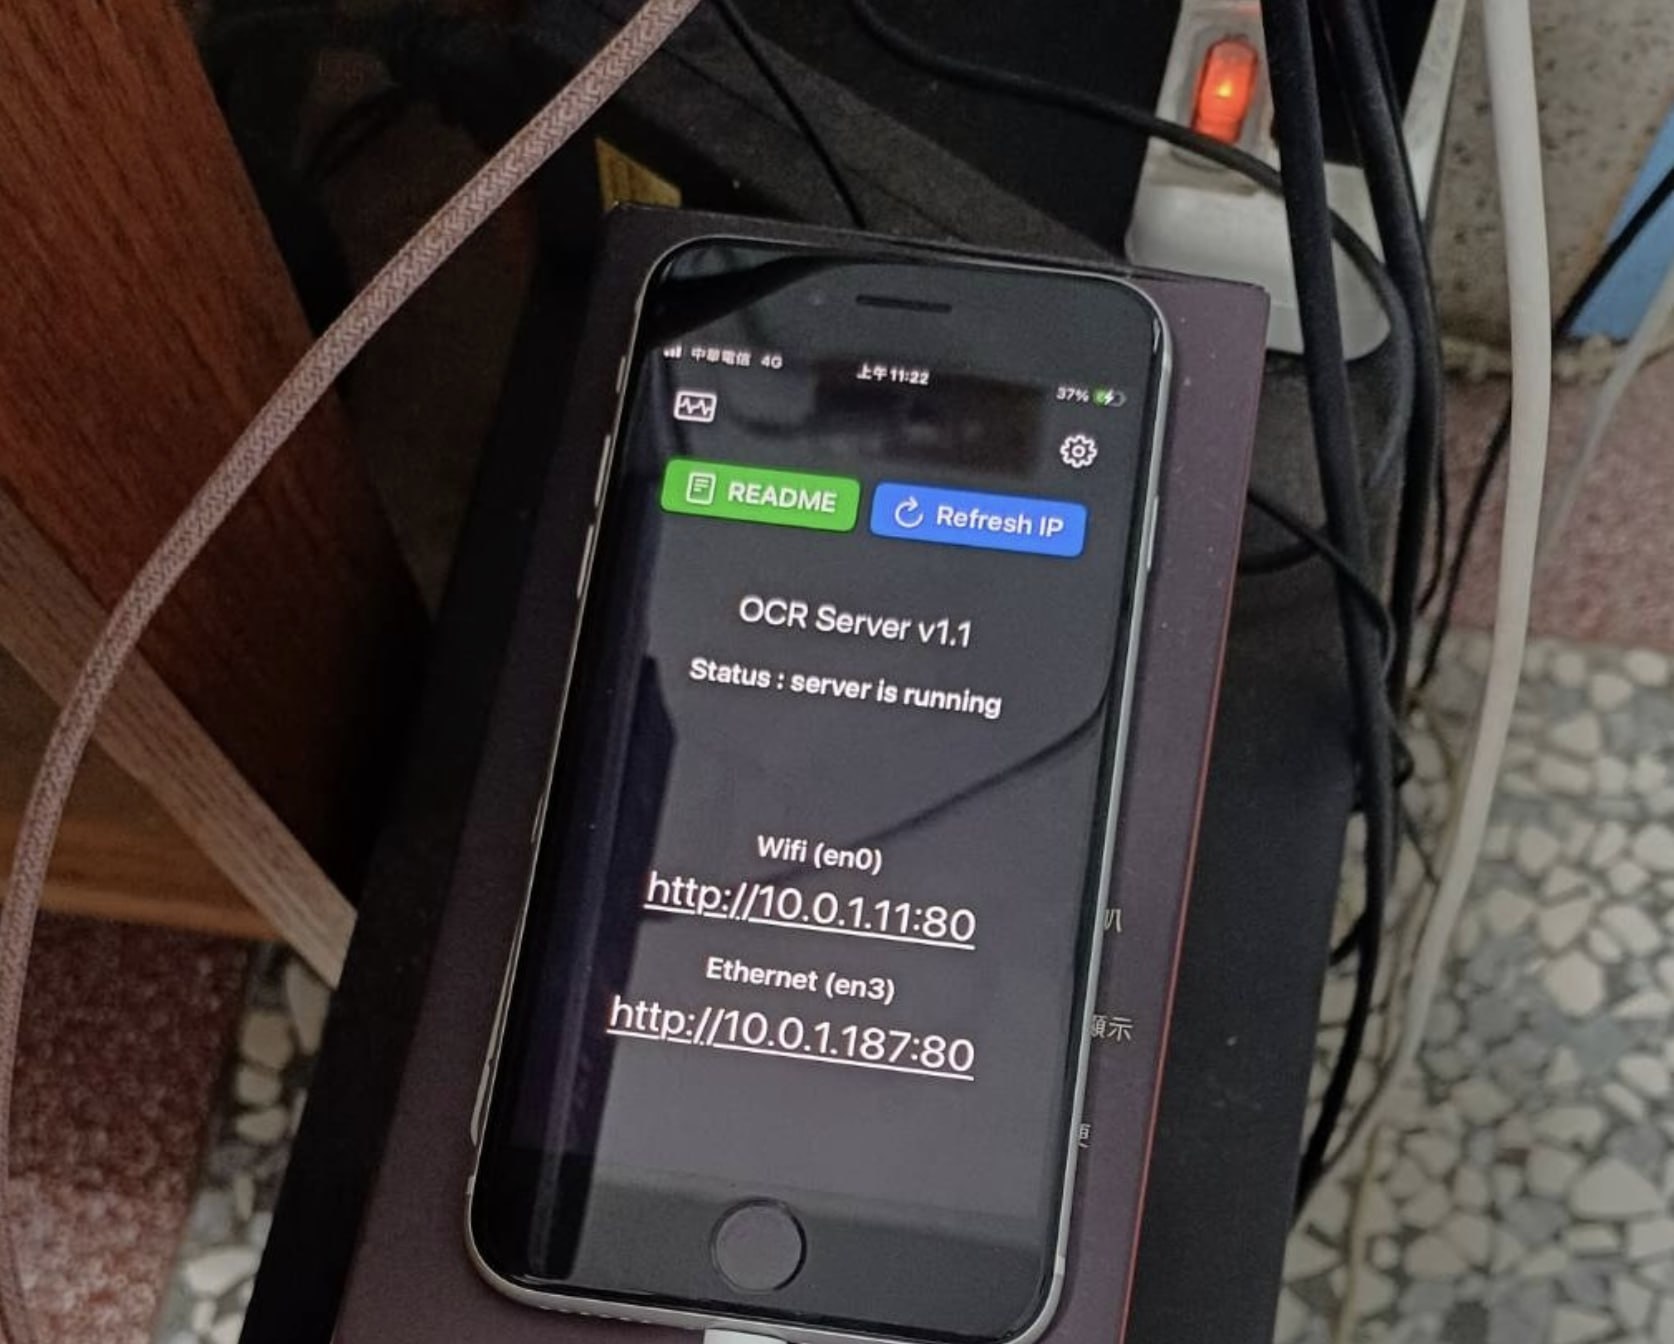
Больше всего мне понравилось, как это собиралось. С последними десятью годами просто: база iMessage на маке и экспорт чатов из WhatsApp. У старых телефонов выгрузки нет вообще, поэтому Сэм собрал стенд, который фоткает каждое сообщение на экране, и прогнал снимки через OCR. Ушел целый день, и он сам признает, что руками перепечатать вышло бы, скорее всего, быстрее
Дальше идут пропуски. На старых телефонах кончалась память, на одном выжили только входящие, а один айфон Сэм сбросил до заводских настроек и стер три года переписки. Дыры он закрыл моделькой:
• Где выжили входящие, отправленные восстанавливает через их соотношение. Соотношение берет из полных месяцев той же эпохи
• Полных месяцев из той эпохи на каждого родителя нашлось три, так что неопределенность самого соотношения тоже уходит в интервалы: бета-распределение плюс отрицательный бином
• Где пусто совсем, модель опирается на сезонность – всплески на Рождество, провалы во время учебы – и на медленно плывущий общий уровень
Проверял честно: прятал куски настоящих данных и смотрел, восстановит ли модель. Интервалы накрывали правду примерно с заявленной частотой, а точечные оценки в месяцах без опоры выходили слабые
Голубые горы на нижнем графике до 2016 года – как раз неуверенность модели. Сама оценка там ползет у дна, около 10 сообщений в месяц, а верх интервала местами доходит до сотни
В итоге из 7.818 сообщений на картинке реально существуют около 5.700. Больше 2.000,
примерно четверть, досчитала модель
И самая честная строчка из README: модель не умеет восстанавливать разовые события. Случись какой-то инцидент внутри пропуска – никакая сезонность его не найдет. Но оно и понятно
Сломай Сэм ногу в 2013-м, на графике была бы ровная волна с горбиками под Рождество. Модель знает про Рождество, а про переломы – ничего. Вспоминайте ногу Сэма каждый раз, когда видите на дашборде аккуратно заполненные пропуски
Еще мелочь по дизайну, которую стоит утащить себе. В комментах пошутили, что график ненавидит дальтоников. Сэм ответил, что специально взял цвета разной светлоты, и следом пришел комментатор с дальтонизмом сказать спасибо. Проверяется за секунду: переводите график в ч/б и смотрите, различаются ли линии
А лучший коммент в треде такой:
Впечатляет, что ты достаточно странный, чтобы такое сделать, и при этом у тебя, судя по всему, здоровые отношения с родителями
Код лежит на
GitHub: iMessage и WhatsApp из коробки, под Телеграм придется дописать парсер, экспорт чата в JSON есть в десктопной версии. Вся история – в 19-минутном
видео с говорящим названием
Stop Throwing Away Your Old Phones. Люблю такие истории 😐
@tagir_analyzes