Baidu представила Unlimited-OCR 2 для распознавания длинных документов
М@cgeventAI-инженер
16 чBaidu выпустила Unlimited-OCR 2 с механизмом SR-SWA, который поддерживает примерно постоянную вычислительную стоимость обработки длинных документов.
Новый механизм может сделать распознавание очень длинных документов менее затратным по вычислениям.
- Модель обращается к текущей странице и ограниченному набору фрагментов документа.
- По тестам Baidu, отдельные шаги декодирования ускоряются до 7 раз относительно полного внимания.
- Код и веса доступны под лицензией MIT, в том числе для коммерческого использования.
Baidu бахнула Unlimited-OCR 2: модель для распознавания документов практически любой длины
Она умеет извлекать текст из сканов и PDF, обрабатывать таблицы, формулы и многостраничные материалы.
Но главная новизна работы не столько в качестве OCR, сколько в способе обработки очень длинных документов.
У современных OCR-моделей на базе LLM есть проблема: чем больше страниц они обрабатывают и чем длиннее становится генерируемый текст, тем больше вычислений и памяти требуется для продолжения работы. Модель вынуждена постоянно обращаться к растущему объёму предыдущего контекста.
Первая Unlimited-OCR уже частично решала эту проблему, ограничивая объём сохраняемой истории генерации. Но визуальные данные всех страниц по-прежнему могли создавать растущую вычислительную нагрузку.
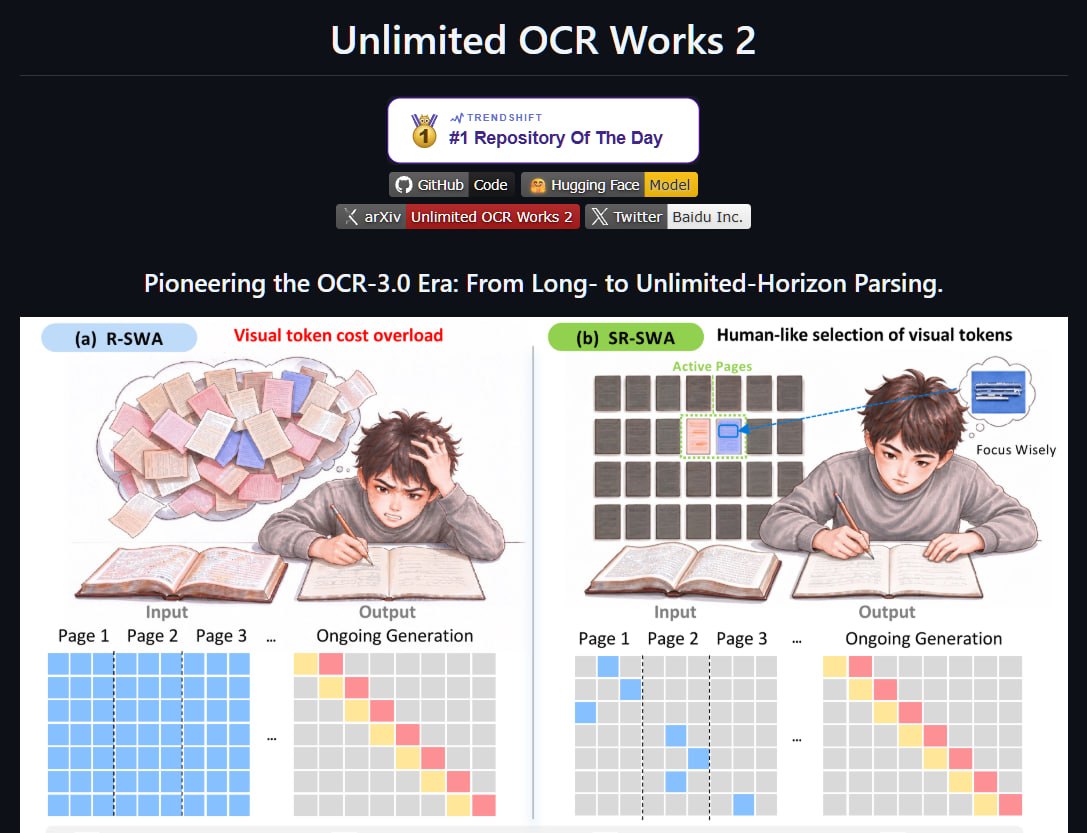
В Unlimited-OCR 2 Baidu предложила механизм Sparse Reference Sliding Window Attention (SR-SWA).
Его идея довольно проста: при распознавании очередного фрагмента модель сосредотачивается на текущей странице и обращается лишь к небольшому набору наиболее полезных фрагментов из остального документа.
Вместо постоянного просмотра всей накопленной информации она использует ограниченную рабочую память - например, 512 опорных токенов.
В результате вычислительная стоимость каждого следующего шага остаётся приблизительно постоянной, даже когда документ становится значительно длиннее.
Все как у кожаных: переписывая длинную книгу, мы смотрим прежде всего на текущую страницу, а не перечитываем все предыдущие после каждого предложения.
Что на итоге?
По собственным тестам Baidu, на документах объёмом около 100 страниц новый механизм обеспечивает ускорение отдельных шагов декодирования до 7 раз относительно полного внимания и до 5.6 раза относительно предыдущего механизма.
Дополнительно модель использует обработку страниц перекрывающимися блоками, что позволяет освобождать память после завершения очередного участка документа.
Модель содержит около 3 млрд параметров. Код и веса опубликованы под лицензией MIT, в том числе для коммерческого использования.
Ссылки:
• GitHub: https://github.com/baidu/Unlimited-OCR
• Веса: https://huggingface.co/baidu/Unlimited-OCR-2
• Статья Unlimited-OCR: https://arxiv.org/abs/2606.23050
@cgevent
Кратко (AI)
Baidu представила Unlimited-OCR 2 — модель для распознавания документов, включая сканы, PDF, таблицы и формулы. Механизм SR-SWA ограничивает объём контекста, к которому модель обращается при обработке очередных фрагментов; по тестам Baidu, это ускоряет отдельные шаги декодирования на документах около 100 страниц.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖