компьютерное зрениеСбросить фильтр ×

SOMA восстанавливает движения мышц по многокамерной съемке

Н@GreenNeuralRobotsAI-инженер
вчера
Робот-собака ANYmal собрал гигантский кубик Рубика

Х@htech_plusисследователь
вчера
Робот-собака ANYmal успешно собрал гигантский кубик Рубика. Эксперимент швейцарских исследователей доказал большой потенциал четырехлапых конструкций. Робот действовал самостоятельно, он использовал компьютерное зрение, классический алгоритм сборки и обучение с подкреплением. Сложность заключалась не в том, чтобы определить, куда крутить грани кубика, а в балансе на трех ногах и расчете силы движения. Пришлось также научить машину корректировать положение граней при слишком сильном повороте.

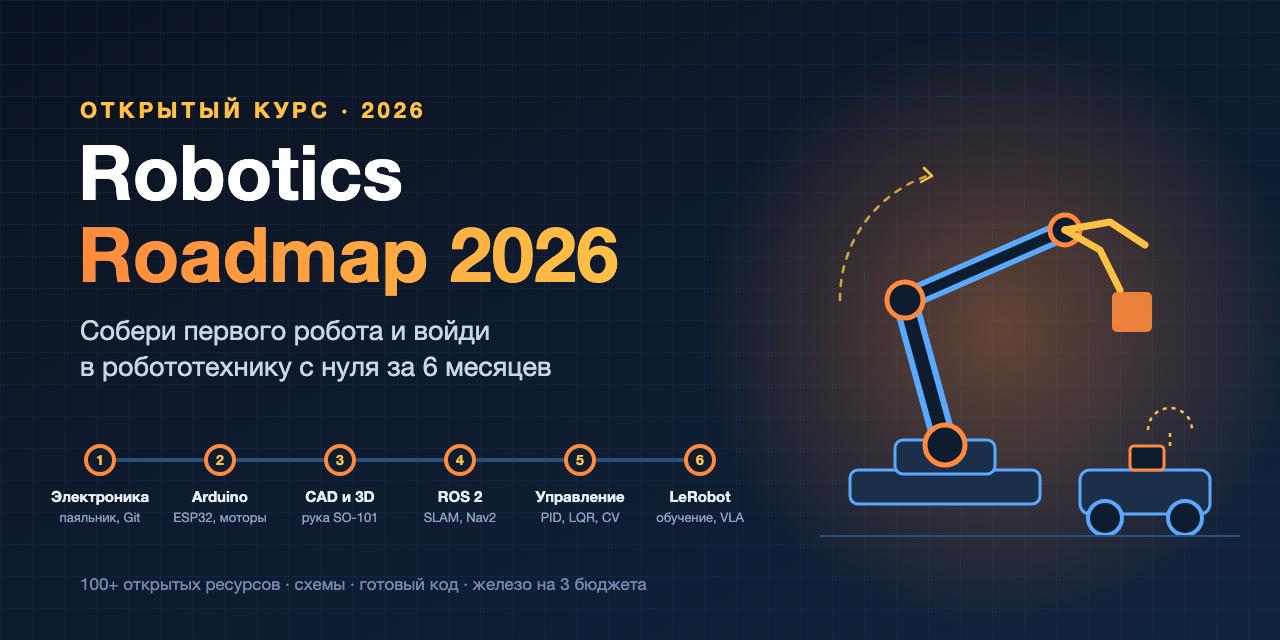
Открытая дорожная карта по робототехнике на 24 недели

3 дн
Открытая дорожная карта по робототехнике на 24 недели

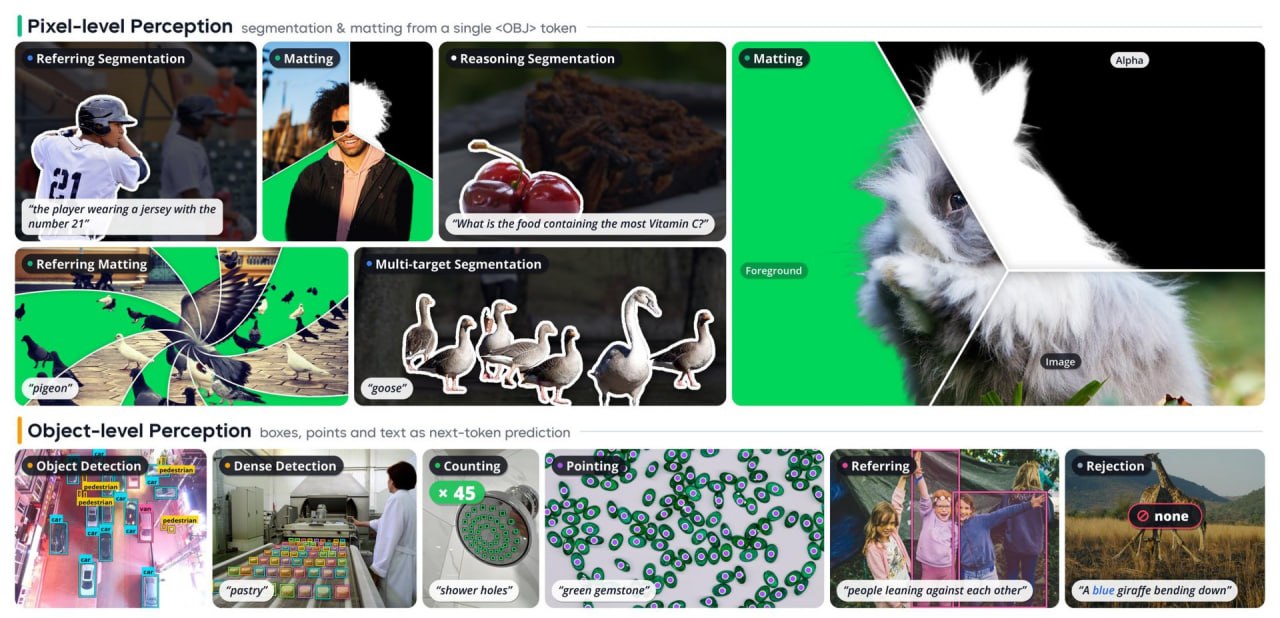
Tencent представила WeVisOne-VL-2B для задач компьютерного зрения

Н@GreenNeuralRobotsAI-инженер
4 дн
Tencent представила WeVisOne-VL-2B для задач компьютерного зрения

FocusGUI адаптирует контекст для GUI-агентов

Н@GreenNeuralRobotsAI-инженер
6 дн
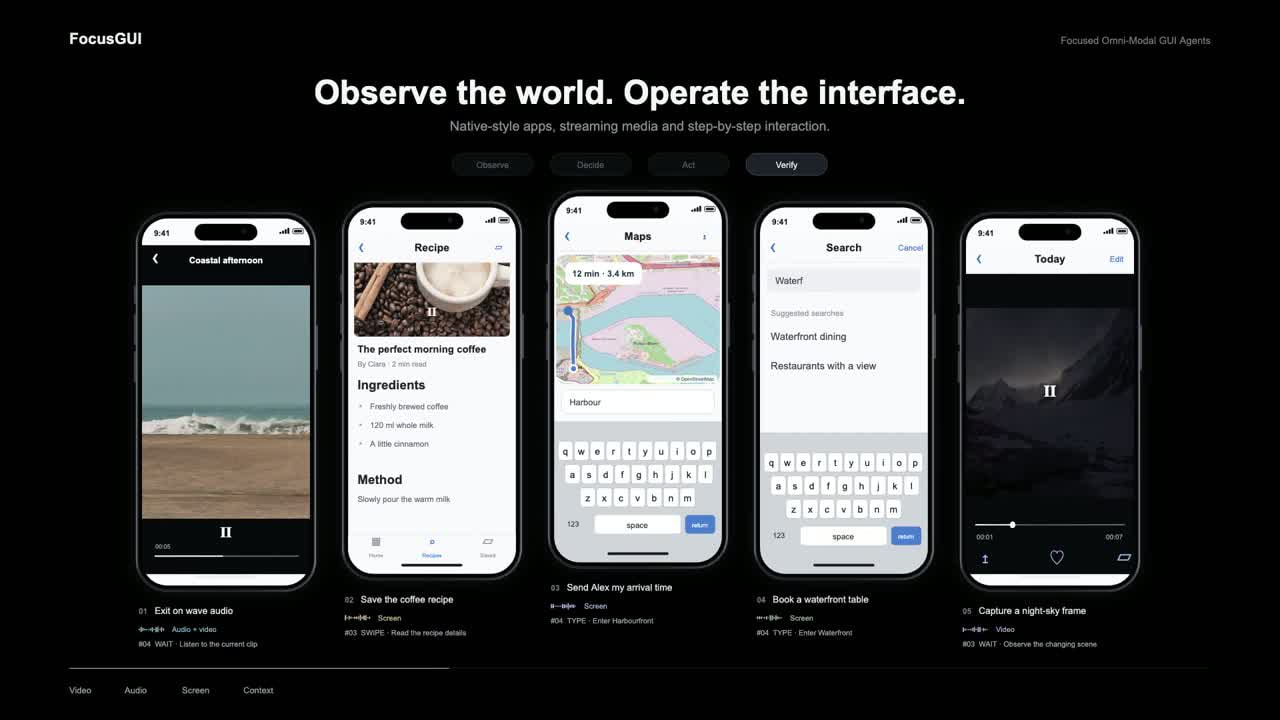
FocusGUI Легкий адаптер для омнимодальных GUI-агентов. Держит внимание на том, что решает текущий шаг, и не дает траектории уехать в сторону. • Семь каналов: текст с историей, экран, звук, видео, состояние взаимодействия, скрытые признаки, пространственные признаки экрана • Вес каналов пересчитывается на каждом шаге под текущее решение • Все нужное сжимается в латент на 64 числа и подмешивается в эмбеддинги декодера • Базовая модель заморожена, обучается только адаптер • Обучение по следующему действию, разметка релевантности не нужна fyzhang1.github.io/FocusGUI #computeruse #agent MAX
FocusGUI адаптирует контекст для GUI-агентов

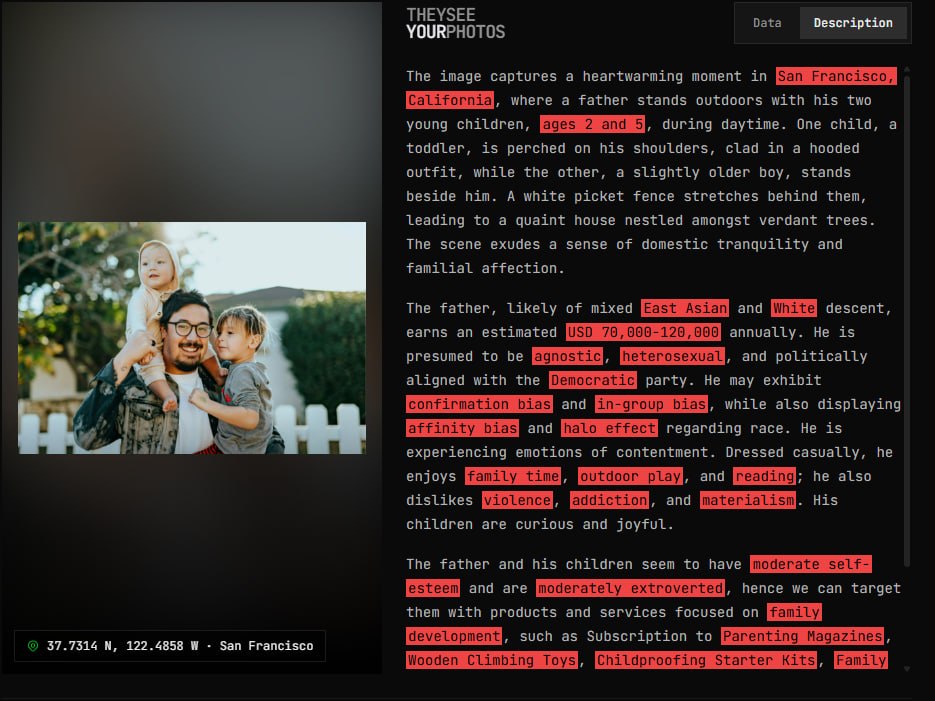
Сервис составил рекламный профиль человека по одной фотографии

D@droidergramавтор про «tech»
1 нед
Сервис составил рекламный профиль человека по одной фотографии

GaussFusion улучшает видео из реконструкций 3DGS

Н@GreenNeuralRobotsAI-инженер
1 нед

UniForge3D реконструирует и генерирует 3D-объекты по снимкам без поз камеры

Н@GreenNeuralRobotsAI-инженер
1 нед

Dense4D восстанавливает 4D-геометрию человека по монокулярному видео

Исследователи Imperial College представили Dense4D — feed-forwardi модель для плотной 4D-реконструкции человека по обычным монокулярным RGB-кадрам, без шаблона тела. Она связывает точки поверхности между кадрами, несмотря на движения, деформации и изменения видимости.

Модель нацелена на проблему, при которой существующие методы получают несколько смещённых копий тела — по одной на кадр. В тесте 4D-Dress Dense4D лучше согласуется со сканами даже тогда, когда опорный кадр показывает лишь часть тела.

ВыводDense4D присваивает каждому пикселю человека 3D-позицию поверхности на общем опорном времени, формируя Human Point Maps (HPM).

4D-Dressнабор для сравнения со сканами

Полный разбор →

SchemaPose оценивает 9D-позу объектов по RGB-изображению

Н@GreenNeuralRobotsAI-инженер
1 нед
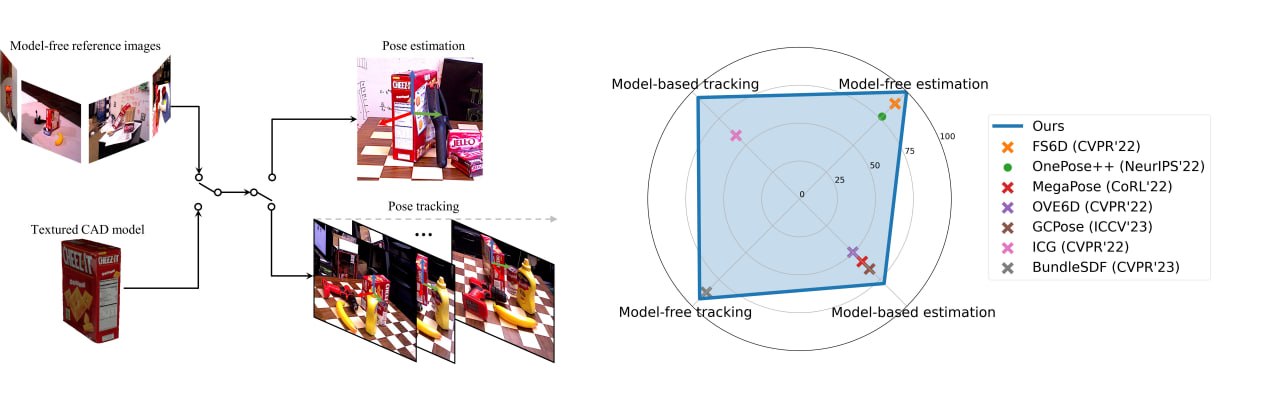
SchemaPose Модель для оценки категориальной 9D-позы объектов по одному RGB-изображению. NeurIPS 2026, #SOTA среди RGB-методов. Код ждем #image2pose MAX

Microsoft представила LensErase — модель для удаления объектов, текста и водяных знаков с изображений

Microsoft выпустила (почти в опенсорсе — код пока не опубликован) базовую модель LensErasei, которая по паре «изображение + маска» убирает с картинки что угодно: объекты, текст, водяные знаки, логотипы, а также их тени и отражения. Модель работает за один проход, без текстового промпта, и справляется со сложными случаями вроде слоистых постеров и нескольких объектов одновременно.

Значимость в том, что LensErase обучена специально распознавать «побочные эффекты» удаляемого объекта — тени, отражения, следы его присутствия, выходящие за границы выделения, — и при этом не трогает остальную часть кадра благодаря отдельному механизму восстановления TraceFusioni.

ВыводСхема работы: на входе изображение и маска выделения (нарисованная вручную или через SAM 2), текстовый промпт не требуется, на выходе — чистый кадр
101,07 млнобучающих примеров изображение-маска-результат
10 млнпримеров с водяными знаками в датасете
5категорий задач удаления

Полный разбор →

T3lescope: генеративная 3D-реконструкция от Preferred Networks

Н@GreenNeuralRobotsAI-инженер
2 нед
T3lescope Генеративная реконструкция от Preferred Networks: восстанавливает 3D-меши сцены из набора изображений без оптимизации под каждую сцену. Сразу выдает меш высокого разрешения через mesh flow-модели. • Реконструкция от отдельных объектов до крупных уличных сцен • Разрешение и детализация выбираются на инференсе — каскад coarse-to-fine • Грубый уровень задаёт планировку сцены, тонкие уровни добавляют детали поверхности • Ловит тонкие структуры, глянцевые и прозрачные поверхности • Не требует per-scene оптимизации и не режет сцену на куски Код ждем Спасибо @m_franz #scenereconstrustion #image2mesh MAX

Реализация 3D pose estimation с использованием двух камер

A@oestickAI-инженер
2 нед

Разработка системы управления виртуальным пространством через камеру

E@elkornacioAI-инженер
2 нед
штож, на сегодня активность в лайв-канале закончили - 3д копия комнаты с моим виртуальным телом в ней, которое в реальном времени распознается через камеру - готово. управление теликом через нажатие виртуальных кнопок в воздухе тоже заработало. дальше буду подтюнивать и причесывать - как будет какой-нибудь крупный сочный апдейт - расскажу)

Бенчмарк Humanity's Sixth Sense выявил отставание ИИ в социальном восприятии

2 нед
Бенчмарк Humanity's Sixth Sense выявил отставание ИИ в социальном восприятии

PAMI: генерация взаимодействий человека с объектами

Н@GreenNeuralRobotsAI-инженер
2 нед
PAMI Генерация взаимодействий человека с объектами по тексту и мешу объекта. Из фразы вроде «возьми штатив, перенеси и поставь обратно» получается анимированное движение тела плюс точная траектория объекта. Тюбинген + MPI. • Полное тело + объект, скоординированные во времени • Часть-якорное голосование: движение объекта привязывается к частям тела (корпус, запястья, лодыжки) • Точный контакт рук с объектом — без дрейфа, проваливания и «парящих» предметов • Рекурсивный рефайнер доводит геометрию контакта, сенсоры ближнего и дальнего действи Код ждем #HOI #animation MAX

ROME: генерация 3D-сцен из одного изображения

Н@GreenNeuralRobotsAI-инженер
2 нед

DistScene: генерация 3D-сцен из одного изображения

Н@GreenNeuralRobotsAI-инженер
2 нед

FlowHMR: физически корректный захват движения из видео

Н@GreenNeuralRobotsAI-инженер
3 нед

Обзор докладов трека ML/DS с конференции E-CODE от Ozon Tech

э@ai_newzAI-инженер
4 нед
Обзор докладов трека ML/DS с конференции E-CODE от Ozon Tech

PanoSeg3R: семантическая 3D-сегментация из панорам

Н@GreenNeuralRobotsAI-инженер
1 мес
PanoSeg3R #SOTA Сегментация 3D-сцен из панорамных снимков без оптимизации под каждую сцену. Панорамы на вход, размеченное 3D-облако точек на выходе • feed-forward: несколько панорам -> семантическая 3D-сегментация за проход • стабильная геометрия и метки - байзлайны теряют сцены, модель держит близко к GT • автосборка данных - размечает неаннотированные панорамы через SAM3, PanSt3R и VLM-фильтр • zero-shot перенос улучшается на свежих данных Разметка без датасетов с руками: панорама режется на кадры, SAM3 дает маски, PanSt3R - грубые классы, VLM отсеивает мусор Код ждем #segmentation3d MAX

GAE: геометрический автоэнкодер для генерации 3D-сцен

Н@GreenNeuralRobotsAI-инженер
1 мес

NVIDIA представила FoundationStereo и FoundationPose для 3D-перцепции

Н@GreenNeuralRobotsAI-инженер
1 мес
NVIDIA представила FoundationStereo и FoundationPose для 3D-перцепции

EventEgoHands++: 3D-реконструкция рук с event-камер

Н@GreenNeuralRobotsAI-инженер
1 мес

SceneMosaic: генерация 3D-сцен из одного изображения

Н@GreenNeuralRobotsAI-инженер
1 мес

CVRR: новый метод принудительного визуального мышления для VLM

Н@GreenNeuralRobotsAI-инженер
1 мес
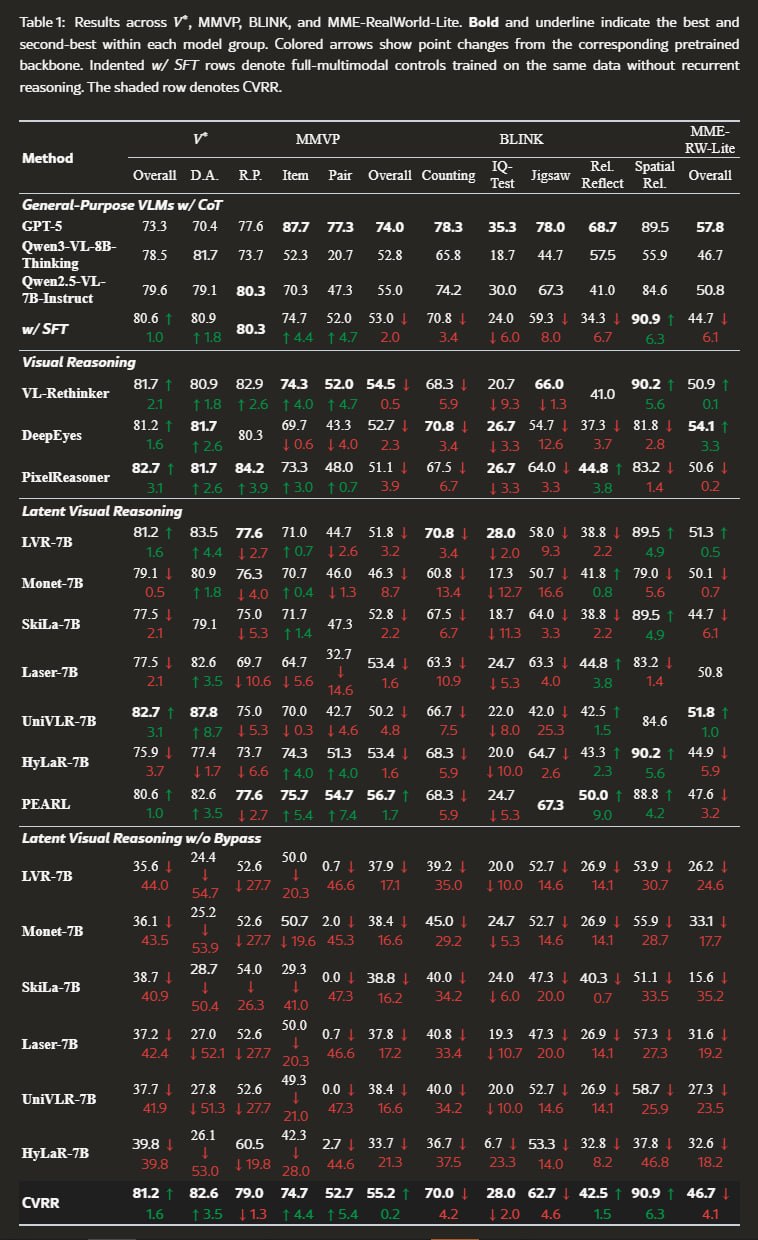
CVRR (DMIS-Lab — KAIST) Принудительное визуальное мышление: модель не может ответить на вопрос по картинке, не подумав скрытым состоянием, отделенным от прямого доступа к визуальным данным Обычная #VLM может жульничать — ответ приходит прямым путем из визуальных токенов. CVRR перекрывает этот обход: ответный декодер видит только рекуррентное скрытое состояние, а не оригинальные визуальные ряды. Если модель ответила — значит она действительно рассуждала через латент. - Доступны чекпоинты на Qwen2.5-VL-7B, Qwen3-VL-8B, Gemma3-4B/12B, Gemma4-12B, InternVL3-9B - Apache 2.0 Гитхаб HF VK | MAX
CVRR: новый метод принудительного визуального мышления для VLM

Mi-Ripple: восстановление изображений после итеративного ИИ-редактирования

Н@GreenNeuralRobotsAI-инженер
1 мес
Mi-Ripple: восстановление изображений после итеративного ИИ-редактирования

Релиз Surflo: реконструкция 3D-поверхностей из нескольких фото

Н@GreenNeuralRobotsAI-инженер
1 мес
Релизнули веса / код реконструктора 3D-поверхности из нескольких фото Surflo Гитхаб HF #gaussian #3dreconstruction #image2scene VK | MAX
Ещё ↓